Twee nieuwe producttitels per SKU met n8n en OpenAI
Ruben Runneboom, Taskforce
Uit de sessie: Marketing: Advertising in the Age of AI
Ruben Runneboom van Taskforce laat in de marketingsessie van april 2026 de eerste helft zien van de titeltest die zijn bureau voor de Britse webshop Medisave draait. Je ziet hoe productdata en echte zoektermen in één spreadsheet samenkomen en hoe een n8n-flow met OpenAI daar per product twee nieuwe titels van maakt. Handig voor wie een Shopping-feed beheert en titels nu met bulkregels bijwerkt.
Voor wie: Je een Shopping-feed beheert en wilt zien hoe je feeddata en zoektermen combineert tot betere titels.
Hetzelfde moment
- Hoofdstuk van 6:28 min: Twee AI-titels per SKU: opzet van een zelflerende test
Waarom dit ertoe doet
Ruben vertelt eerder in de sessie dat bij de meeste klanten van Taskforce 70 tot 80 procent van de omzet uit Google Shopping komt. De producttitel is daar je belangrijkste tekst. Google staat 1 tot 150 tekens toe, maar meldt dat gebruikers meestal alleen de eerste 70 tekens of minder zien. Wat in die eerste woorden staat, bepaalt of je product klikt. Bulkregels in een feedtool plakken velden aan elkaar, maar ze weten niet welke woorden klanten echt intypen. Die woorden staan wel in Search Console, per landingspagina. Door die data naast je feed te leggen en een taalmodel met vaste richtlijnen te laten schrijven, maak je titels die aansluiten op de zoekvraag. Je krijgt varianten die je daarna kunt testen.
Belangrijkste inzichten
- Taskforce maakt per SKU 2 nieuwe titels: één uit ongebruikte feedattributen en één uit organische zoektermen per landingspagina.
- Google staat 1 tot 150 tekens toe in een titel, maar gebruikers zien meestal de eerste 70 of minder; zet het belangrijkste vooraan.
- De Search Console API groepeert op zoekopdracht en pagina, tot 25.000 rijen per verzoek; zo koppel je zoektermen via de URL aan een SKU.
- Het taalmodel in n8n krijgt een richtlijnendocument per branche mee: volgorde van attributen, tekenlengte en plaats van het materiaal.
- Volgens Ruben komt bij de meeste klanten van Taskforce 70 tot 80 procent van de omzet uit Google Shopping, dus de titel weegt zwaar.
Twee bronnen in één master spreadsheet
De flow begint met een export van alle productinformatie uit het hoofdaccount. Op de slide heet dat de Channable-export, met SKU, titel, beschrijving, productcategorie en merk. Ruben benadrukt dat alle attributen meegaan, ook de velden die nu niet in de titel staan. Daarnaast haalt Taskforce de organische zoektermen per landingspagina op. Dat gebeurt met Markifact, een platform dat marketingbronnen zoals Google Ads, GA4 en Google Search Console koppelt en data naar Google Sheets kan schrijven. Search Console zelf kan dit ook leveren: de Search Analytics API groepeert op zoekopdracht en op pagina, met maximaal 25.000 rijen per verzoek. Omdat elk product een eigen landingspagina heeft, koppel je de zoektermen via die URL aan de juiste SKU. Zo krijgt elke regel in de spreadsheet extra kolommen met de woorden die mensen echt in Google typten voordat ze op die pagina landden.
Wat de n8n-flow met OpenAI doet
n8n noemt zichzelf een workflowtool onder een fair-code licentie die AI-functies combineert met procesautomatisering. Je kunt het zelf hosten of in de cloud draaien. In de flow van Taskforce zit een taalmodel van OpenAI dat per SKU twee titels maakt. Variant 1 bouwt op de extra attributen uit de feed, zoals highlights, materialen of afmetingen. Variant 2 bouwt op de zoektermen die bij de landingspagina horen. Het model krijgt een richtlijnendocument mee met de best practices van het bureau voor deze branche: de volgorde van attributen, de lengte in tekens en waar bijvoorbeeld het materiaal komt. Google stelt zelf ook regels: geen prijs, geen verzendinformatie, geen hoofdletters als nadruk en geen bedrijfsnaam in de titel. Merk, kleur, maat en leeftijdsgroep mogen er wel in. De twee nieuwe titels gaan terug in de spreadsheet als kolommen optimized_title_1 en optimized_title_2.
Waarom ongebruikte attributen goud waard zijn
Veel feeds bevatten meer informatie dan de titel laat zien. Merchant Center kent bijvoorbeeld het veld product highlight: minimaal 2 en maximaal 100 korte punten per product, elk tot 150 tekens, en Google raadt er 4 tot 6 aan. Ook beschrijving, materiaal en afmetingen staan vaak in de feed zonder dat ze in de titel terugkomen. Ruben zegt in de sessie dat de AI van Channable ongebruikte attributen inmiddels ook kan inzetten, maar dat Taskforce in juni 2025 begon, voordat die functie er was. De zoektermvariant is lastiger na te bouwen met alleen een feedtool, omdat die data uit Search Console komt en niet uit de feed. Daar zit volgens Ruben het voordeel ten opzichte van andere adverteerders.
Wat feit is en wat ervaring
De limieten voor titels, highlights en de Search Console API komen uit de documentatie van Google. Medisave bestaat sinds oktober 2001, zit in Weymouth in Engeland en verkoopt volgens de eigen site meer dan 30.000 productregels, met stethoscopen als bekende categorie. Dat Medisave rond de 20 miljoen omzet draait, in twintig landen adverteert en dat de feed vooraf heel karig was, zijn uitspraken van Ruben. Ruben noemt de spreadsheet zelf een flink bestand, maar voor de test werkt het. Wat er daarna met de titels gebeurt, het dupliceren per SKU en de test in een apart account, zie je in de clip over de zelflerende titeltest.
Probeer dit deze week
- Exporteer je 50 best verkopende producten uit Merchant Center en markeer welke attributen, zoals materiaal of highlights, nu niet in de titel staan.
- Haal in Search Console onder Prestaties de zoekopdrachten op voor 5 productpagina's en vergelijk die woorden met de eerste 70 tekens van hun titels.
- Schrijf een richtlijn van één pagina voor je titels (volgorde, maximaal 150 tekens, geen promotietekst) en laat een taalmodel daarmee 10 titels herschrijven die je zelf beoordeelt.
Begrippen
- SKU
- Stock keeping unit: de unieke code waarmee je één productvariant in je voorraad en feed herkent.
- n8n
- Een tool waarmee je stappen tussen systemen automatiseert in een visuele flow, ook met een taalmodel als stap.
- Organische zoektermen
- De woorden die mensen in Google typten voordat ze via een gewoon, niet betaald zoekresultaat op je pagina kwamen.
- Master spreadsheet
- Eén centraal bestand waarin alle productdata en extra kolommen per SKU samenkomen, als bron voor de test.
Verdiep je in de gids
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
Dus in principe wat we proberen te doen is wij trekken eigenlijk alle productinformatie uit het Google ja, main account, dus via Merchant Center account, draaien wij in een export, dus daar zitten alle product attributen erin, die pushen wij in een master spreadsheet Dus daar staan eigenlijk alle attributen in, dus niet alleen de titel en dat soort zaken, maar alles wat er bekend is vervolgens proberen wij ook dus vanuit de Search Console de data te trekken om dat met elkaar te combineren dus in dit geval heb je daar een tool voor dat heet Markifact en dat is eigenlijk een tool waarbij je dus ja op landingspagina niveau kan je die data eruit trekken uit de Search Console en daar kan je dus ook bij de ingetypte daadwerkelijk ingetypte zoekopdrachten binnen de binnen Google Organic, dus gewoon in de zoekbalk, krijg je er allemaal mee. En dan kun je dus ook zien op wat voor resultaten dat uiteindelijk is geland. Wat we dus doen, is dat we in die master spreadsheet combineren we de data. Dus dan heb je uiteindelijk de productinformatie uit je Google Main Account zet je in de master spreadsheet. En op basis van de landing page, want er zit natuurlijk aan elk product hangt de landing page, op basis van die landing page kunnen wij die data matchen, zodat we dus die Google master spreadsheet kunnen verrijken met de extra zoektermen. Dus dan hebben we daar gewoon speciale kolommen voor neergezet per SKU in dit geval. Zodat we daar een wat slimmere flow in hebben. Vanuit die Google Master Spreadsheet hebben we een flow lopen. Dat gaat via n8n of Nathan, hoe ook iedereen dat noemt. Iedereen noemt het anders. Wat we eigenlijk doen in dit geval is dat we twee nieuwe titels genereren voor elke SKU. Dus dat doen we één titel op basis van de additionele attributen die vanuit het Merchant Center komt. Maken we daar dus een combinatie van die attributen een nieuw titel van. Dus daar zit een flow in n8n op basis van onze best practices. Dus wij hebben eigenlijk een heel guideline document gemaakt voor de LLM die in de n8n flow zit. Oké, op het moment, als je dus een nieuw titel moet genereren, moet je hieraan voldoen. Denk bijvoorbeeld aan de opbouw van verschillende attributen, maar denk daarbij aan de karakterlengte, moet je het materiaal voor dit zetten of voor dat zetten. Dus we hebben speciaal voor deze branche, hebben we daar een guideline of guide reels voor gemaakt, waarbij hij dus op basis van die nieuwe productattributen, maakt hij een nieuw titel. Maar dat doet hij dus ook voor die Markifact data. Dus eigenlijk maakt hij dus op basis van alle zoektermen die op die landing page bekend zijn, maakt hij ook een nieuwe titel variant van. Volgens importeren we eigenlijk dus vanuit die flow, gaat eigenlijk dus die twee nieuwe titels, die gaan weer terug in die master spreadsheet. Dus die master spreadsheet, dat wordt uiteindelijk best wel een hufte van het bestand. Maakt in dit geval niet uit, maar voor de test werkt het ook prima.
Spreker: Ruben Runneboom, Taskforce
Bronnen
Meer over Productdata & Feeds
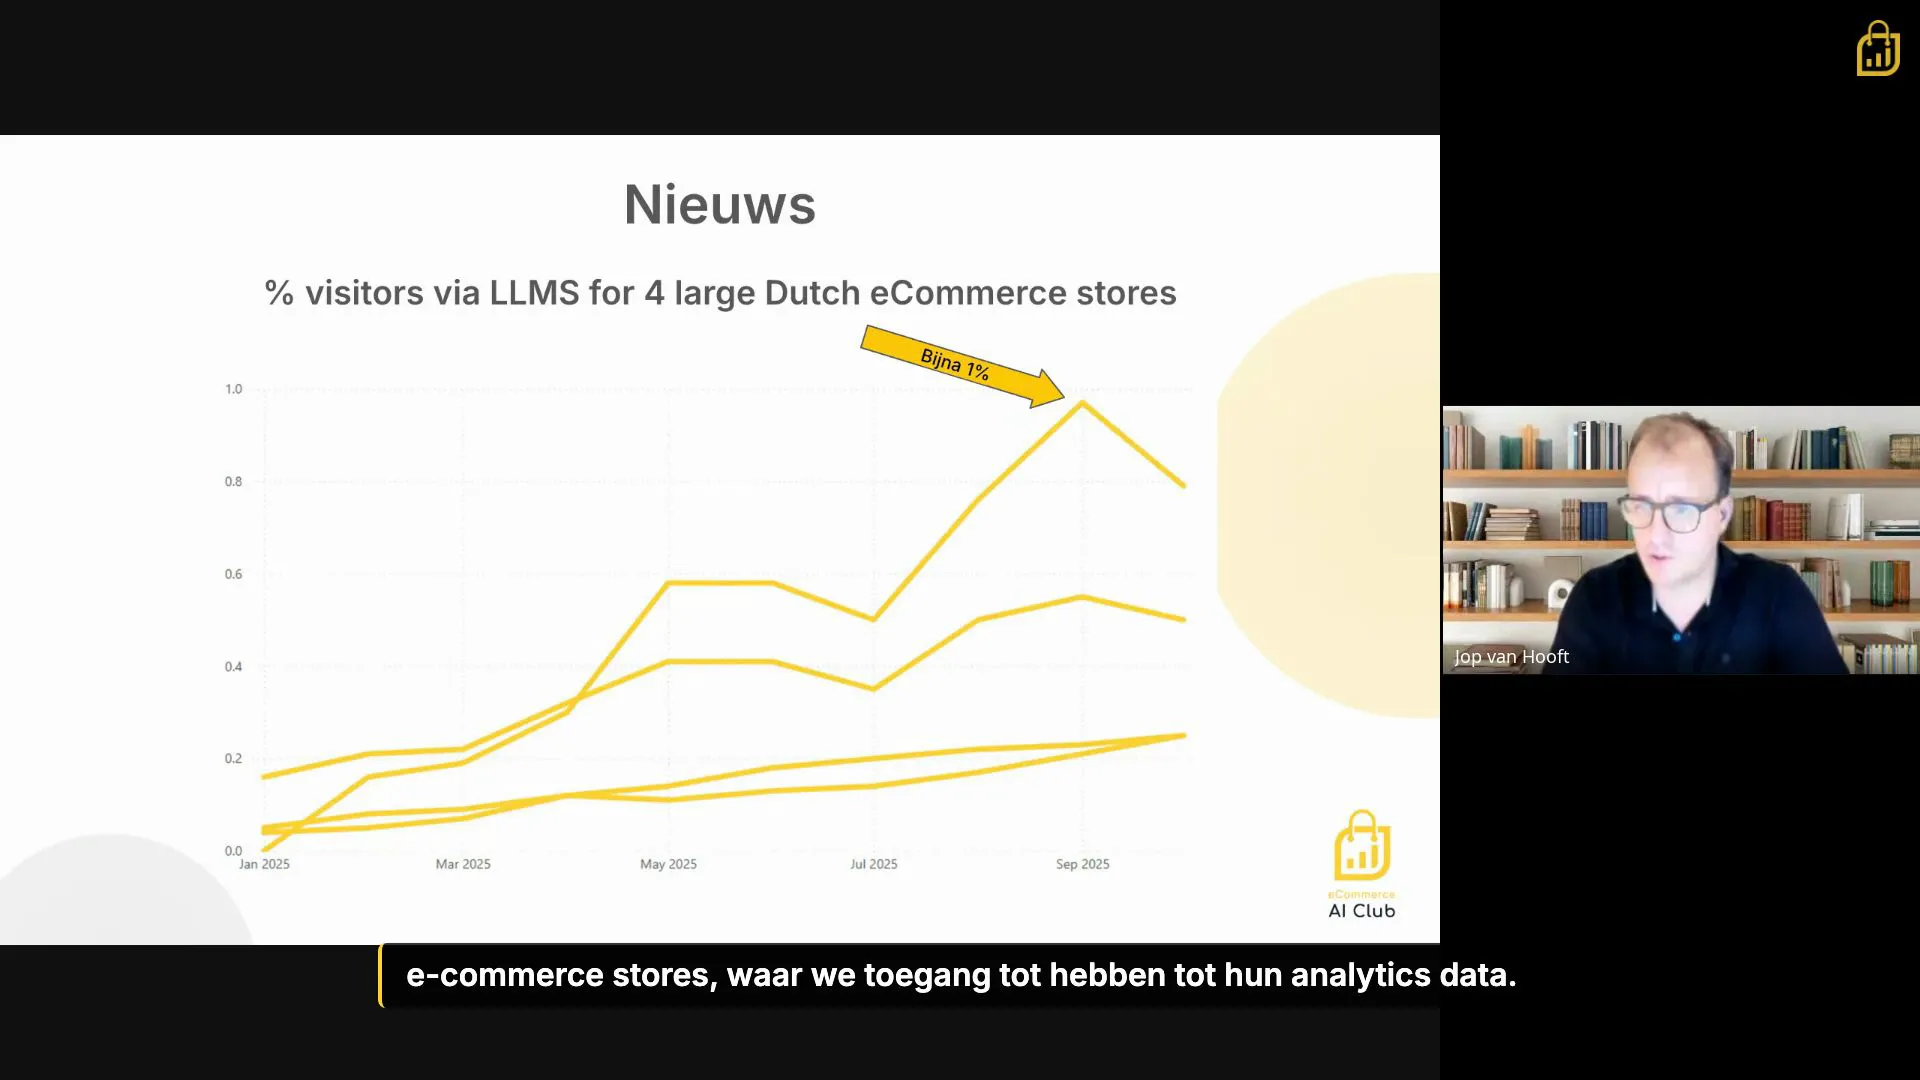 Duur 1:39
Hoeveel verkeer komt via LLMs bij Nederlandse webshops?
Jop van Hooft, eCommerce AI Club
Slechts 1% van je websiteverkeer komt via LLMs, maar het groeit exponentieel
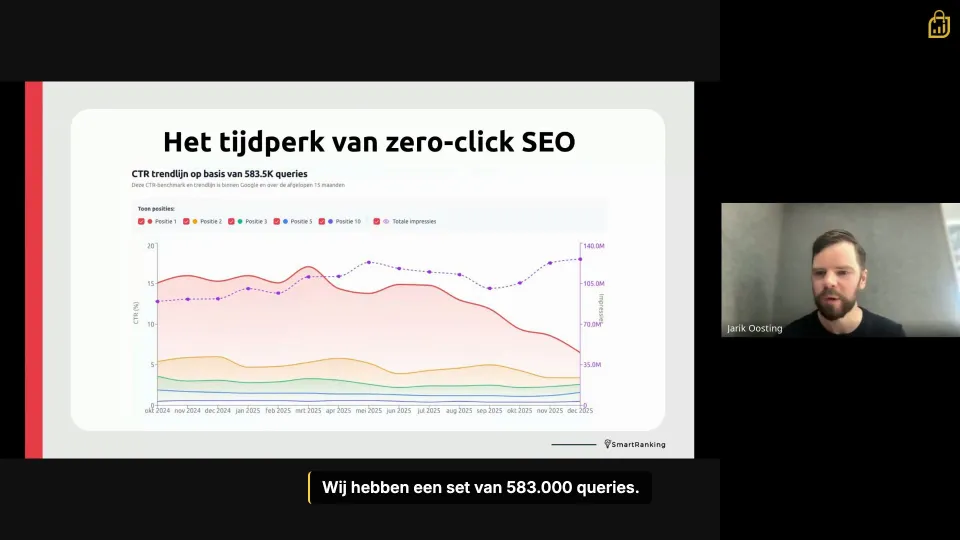 Duur 0:40
Zero-Click SEO
Jarik Oosting, Smart Ranking
De CTR voor positie 1 in Google is met meer dan de helft gedaald
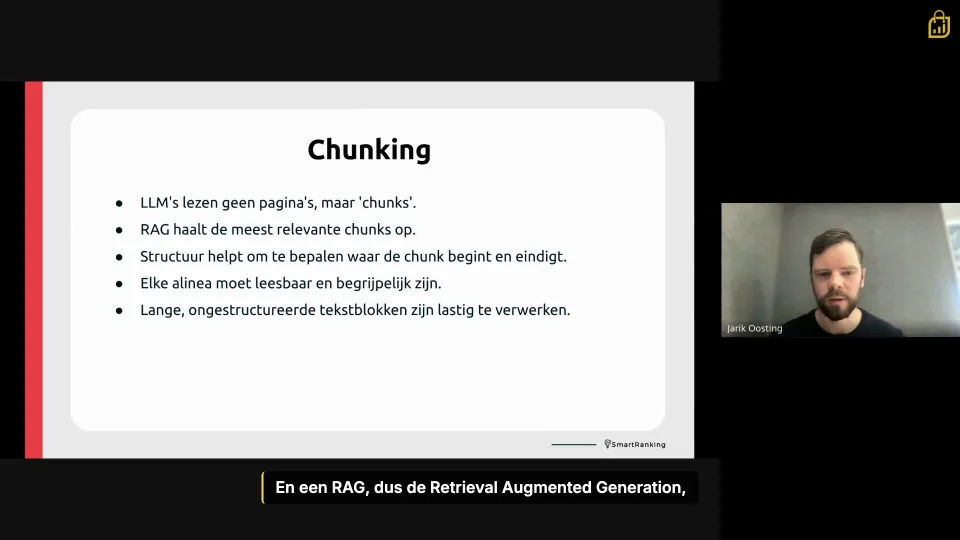 Duur 0:41
Zo leest een LLM jouw website
Jarik Oosting, Smart Ranking
Een LLM leest niet je hele pagina, alleen de relevante chunks