Zo leest een LLM jouw website
Jarik Oosting, Smart Ranking
Uit de sessie: Specialists: LLM Ready Website
Jarik Oosting van Smart Ranking legt in de Specialists-sessie over de LLM-ready website uit wat een taalmodel doet met jouw pagina nadat een zoekopdracht jouw URL heeft opgeleverd. Hij laat zien waarom je HTML-structuur bepaalt welk stuk tekst het model meeneemt.
Voor wie: Je beheert pagina's of sjablonen van een webshop en wilt weten hoe je tekst en HTML inricht voor AI-antwoorden.
Waarom dit ertoe doet
Wie een vraag stelt aan ChatGPT of Google AI Mode krijgt een antwoord dat is samengesteld uit stukken van webpagina's. Jouw categorietekst of productpagina concurreert daarbij niet als geheel, maar per fragment. Een pagina met lange blokken tekst, content die pas na JavaScript verschijnt of productinformatie zonder koppen heeft een kleinere kans dat het goede fragment wordt gekozen. Jarik Oosting noemt het onderschat. Google zegt zelf dat je geen speciale markup of aparte AI-bestanden nodig hebt, maar dat bestaande basis blijft gelden: crawlbaar, tekst die in de pagina staat en een goede pagina-ervaring. Voor een webshop met duizenden productpagina's is een sjabloonverbetering dus een hefboom.
Belangrijkste inzichten
- Een taalmodel leest volgens Jarik Oosting niet de hele pagina, maar een selectie chunks van vaak rond de 100 woorden; de lengte hangt van het model af.
- RAG (Retrieval Augmented Generation) is de stap waarin relevante chunks worden opgehaald voordat het model een antwoord schrijft.
- Praktijkgidsen noemen vaak 256 tot 512 tokens per chunk en adviseren splitsen op koppen in plaats van op vaste lengte.
- Een model dat via RAG ophaalt rendert de pagina volgens Jarik Oosting niet; zet belangrijke content dus server-side in de HTML.
- Google zegt dat voor AI Overviews en AI Mode geen speciale markup nodig is en dat structured data met de zichtbare tekst moet kloppen.
Chunking en RAG in gewone taal
Een taalmodel zoekt niet zelf het hele internet af. Bij een vraag haalt het eerst bronnen op, bij ChatGPT volgens Jarik Oosting deels uit de index van Bing. Daarna leest het model niet de hele pagina, want dat is kostbaar en inefficient. De pagina wordt in stukjes gesneden, chunks. Een retrieval-stap (RAG, Retrieval Augmented Generation) kiest daaruit de chunks die het best bij de vraag passen, en alleen die gaan naar het model om het antwoord te schrijven. Het woord RAG is dus de naam van het ophalen van relevante fragmenten voordat het model antwoordt.
Hoe groot is een chunk, en wat bepaalt de grens
Jarik Oosting noemt rond de 100 woorden per chunk, en zegt direct dat het afhangt van het model en de gebruikte techniek. Praktijkgidsen noemen vaak 256 tot 512 tokens, wat ruwweg meer is dan 100 woorden. Dat getal is dus een richtlijn, geen norm. Wat in alle bronnen terugkomt, is dat splitsen op de eigen structuur van het document, zoals koppen, beter werkt dan blind op lengte knippen. Een koptekst die bij zijn alinea blijft, geeft het fragment context. Dat verklaart het advies van Jarik Oosting: duidelijke H2- en H3-koppen, korte zelfstandig leesbare alinea's, lijsten en tabellen. Hij benadrukt dat een model geen voorkeur heeft voor opsommingen als zodanig; ze zijn gewoon makkelijker te knippen.
Rendering en gestructureerde data
Twee technische punten horen erbij. Het eerste is client-side JavaScript. Volgens Jarik Oosting rendert een taalmodel dat via RAG ophaalt de pagina niet, zoals Googlebot dat wel doet. Een AI-agent die een site bezoekt, doet dat mogelijk wel. Zet daarom belangrijke content in de HTML die de server aflevert. Het tweede is structured data. Jarik Oosting noemt het een discussiepunt of het helpt bij taalmodellen. Zijn advies voor producten is één Product-fragment per pagina met alle informatie en het liefst ook de door Google aanbevolen velden. Google zelf zegt dat structured data moet overeenkomen met de zichtbare tekst.
Wat is bewezen en wat is advies
De werking van chunking en retrieval is gedocumenteerd, maar de precieze keuzes van ChatGPT, Gemini of Google zijn niet openbaar. Jarik Oosting geeft zijn ervaring uit tests van een bureau, en benoemt zelf dat een taalmodel op waarschijnlijkheden werkt: elke prompt kan een iets ander antwoord geven. Gebruik zijn punten dus als goede hygiene voor pagina's die ook voor bezoekers beter worden, en meet daarna of je vaker genoemd wordt.
Probeer dit deze week
- Kies je 5 belangrijkste categoriepagina's en controleer of elke alinea korter is dan ongeveer 100 woorden onder een eigen H2 of H3.
- Open een productpagina met JavaScript uitgeschakeld en noteer welke informatie verdwijnt.
- Controleer met de Rich Results Test of je Product-markup volledig is en klopt met wat een bezoeker ziet.
Begrippen
- LLM
- Large language model: een taalmodel zoals ChatGPT of Gemini dat tekst genereert.
- Chunk
- Een stuk tekst van een pagina dat het systeem apart kan ophalen.
- RAG
- Retrieval Augmented Generation: eerst relevante fragmenten ophalen, dan pas het antwoord schrijven.
- Server-side rendering
- De server levert de pagina met inhoud al in de HTML, in plaats van dat JavaScript die pas in de browser opbouwt.
Verdiep je in de gids
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
Dat is niet zo. Een LLM deelt die pagina op in chunks, eigenlijk in stukjes. En een RAG, de Retriever Augmented Generation, die haalt aan de hand van de structuur van de pagina de meest relevante chunks op.
Dus een LLM trekt niet de complete content van die pagina af. Dat is kostbaar en niet efficiënt. Die pagina wordt opgedeeld in chunks, waarbij de structuur van die pagina enorm helpt om te bepalen voor een LLM waar die chunk begint en waar een chunk eindigt.
Spreker: Jarik Oosting, Smart Ranking
Bronnen
Meer over Productdata & Feeds
 Duur 1:39
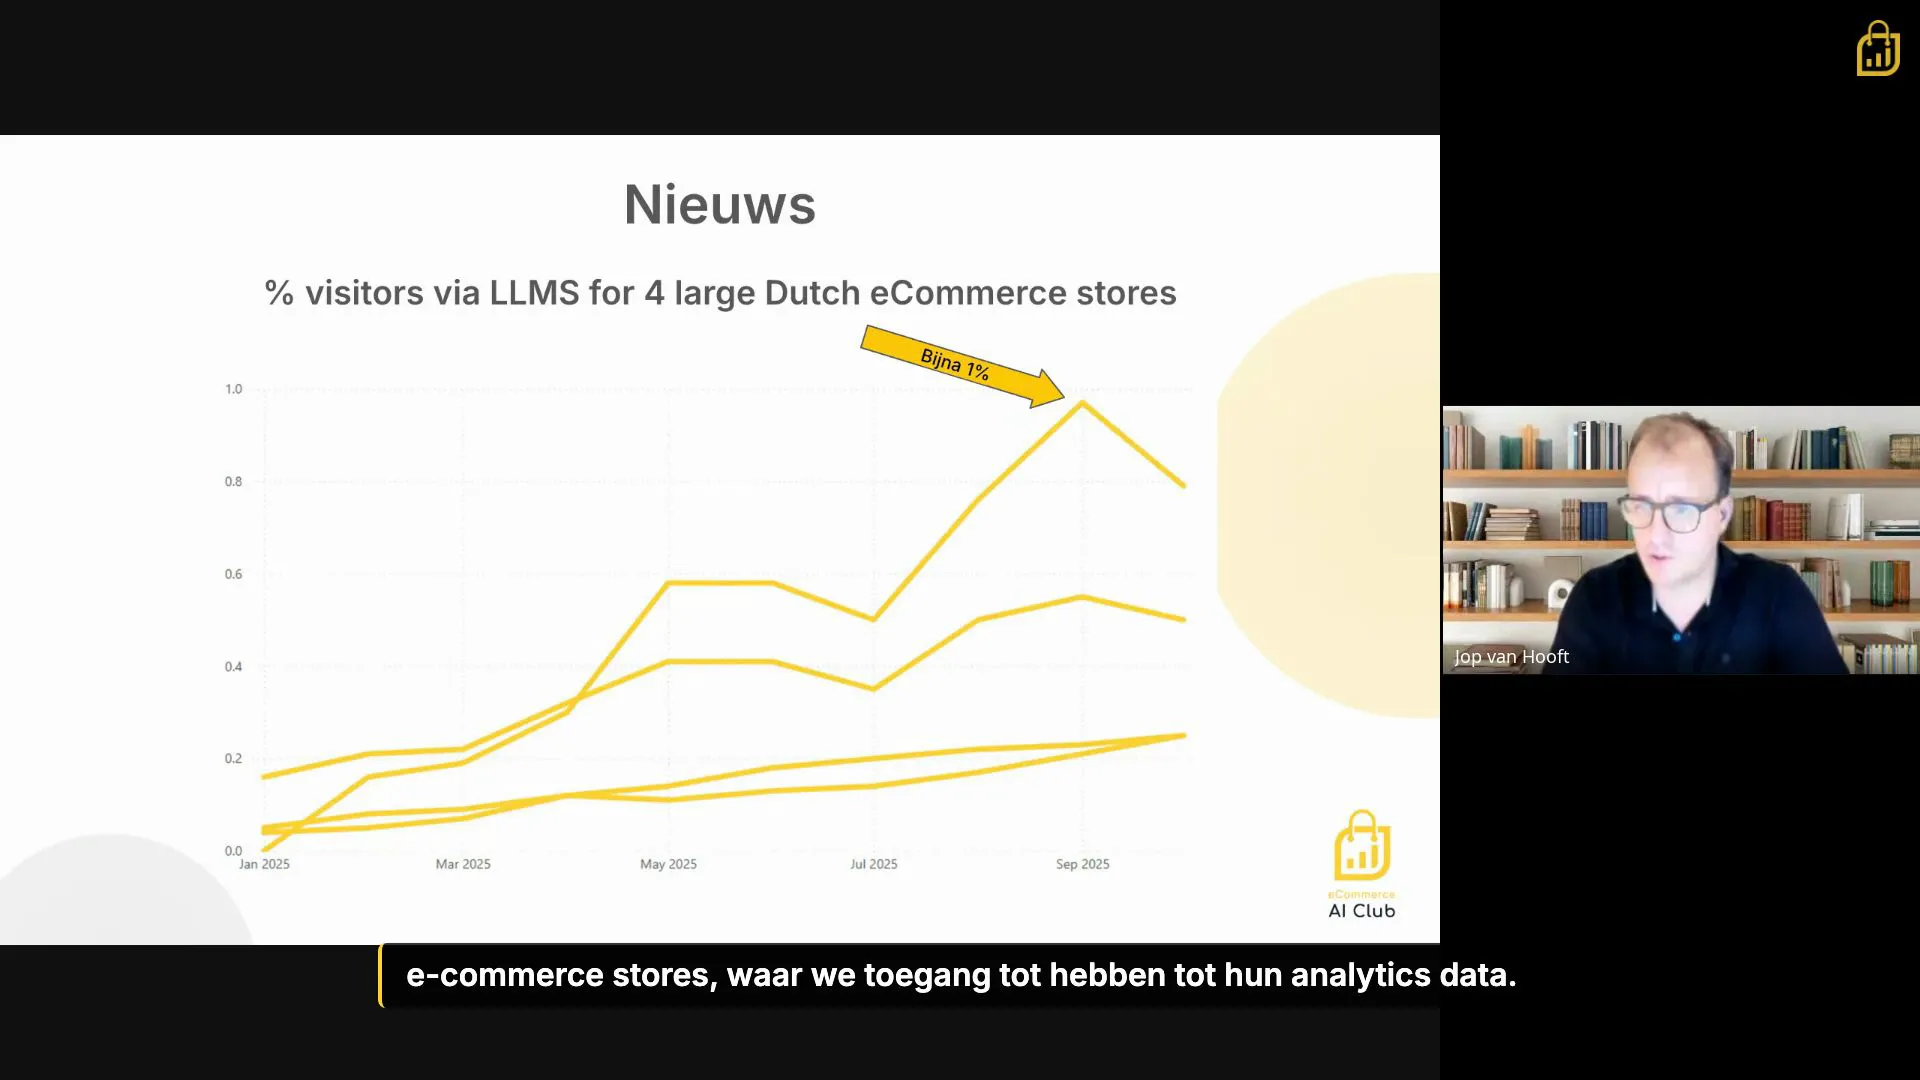
Hoeveel verkeer komt via LLMs bij Nederlandse webshops?
Jop van Hooft, eCommerce AI Club
Slechts 1% van je websiteverkeer komt via LLMs, maar het groeit exponentieel
 Duur 0:40
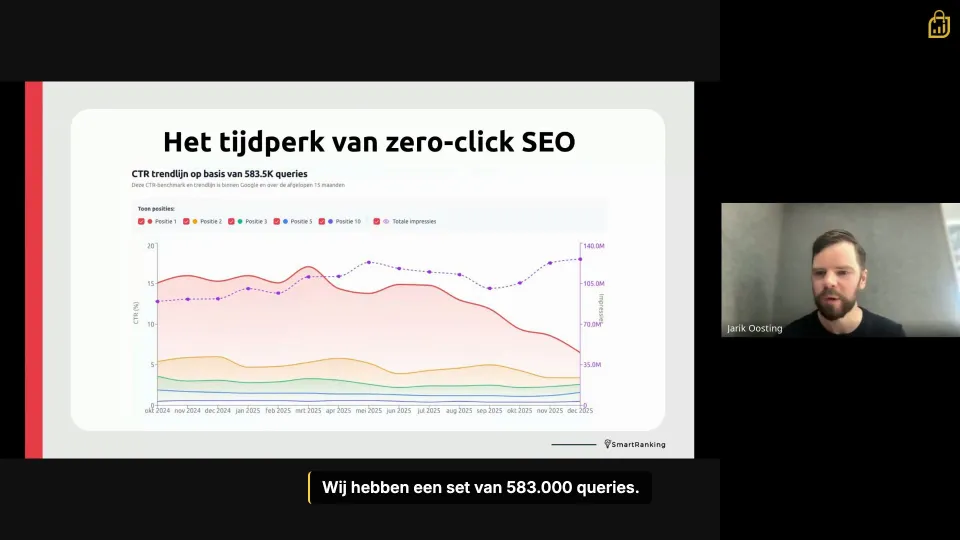
Zero-Click SEO
Jarik Oosting, Smart Ranking
De CTR voor positie 1 in Google is met meer dan de helft gedaald
 Duur 0:38
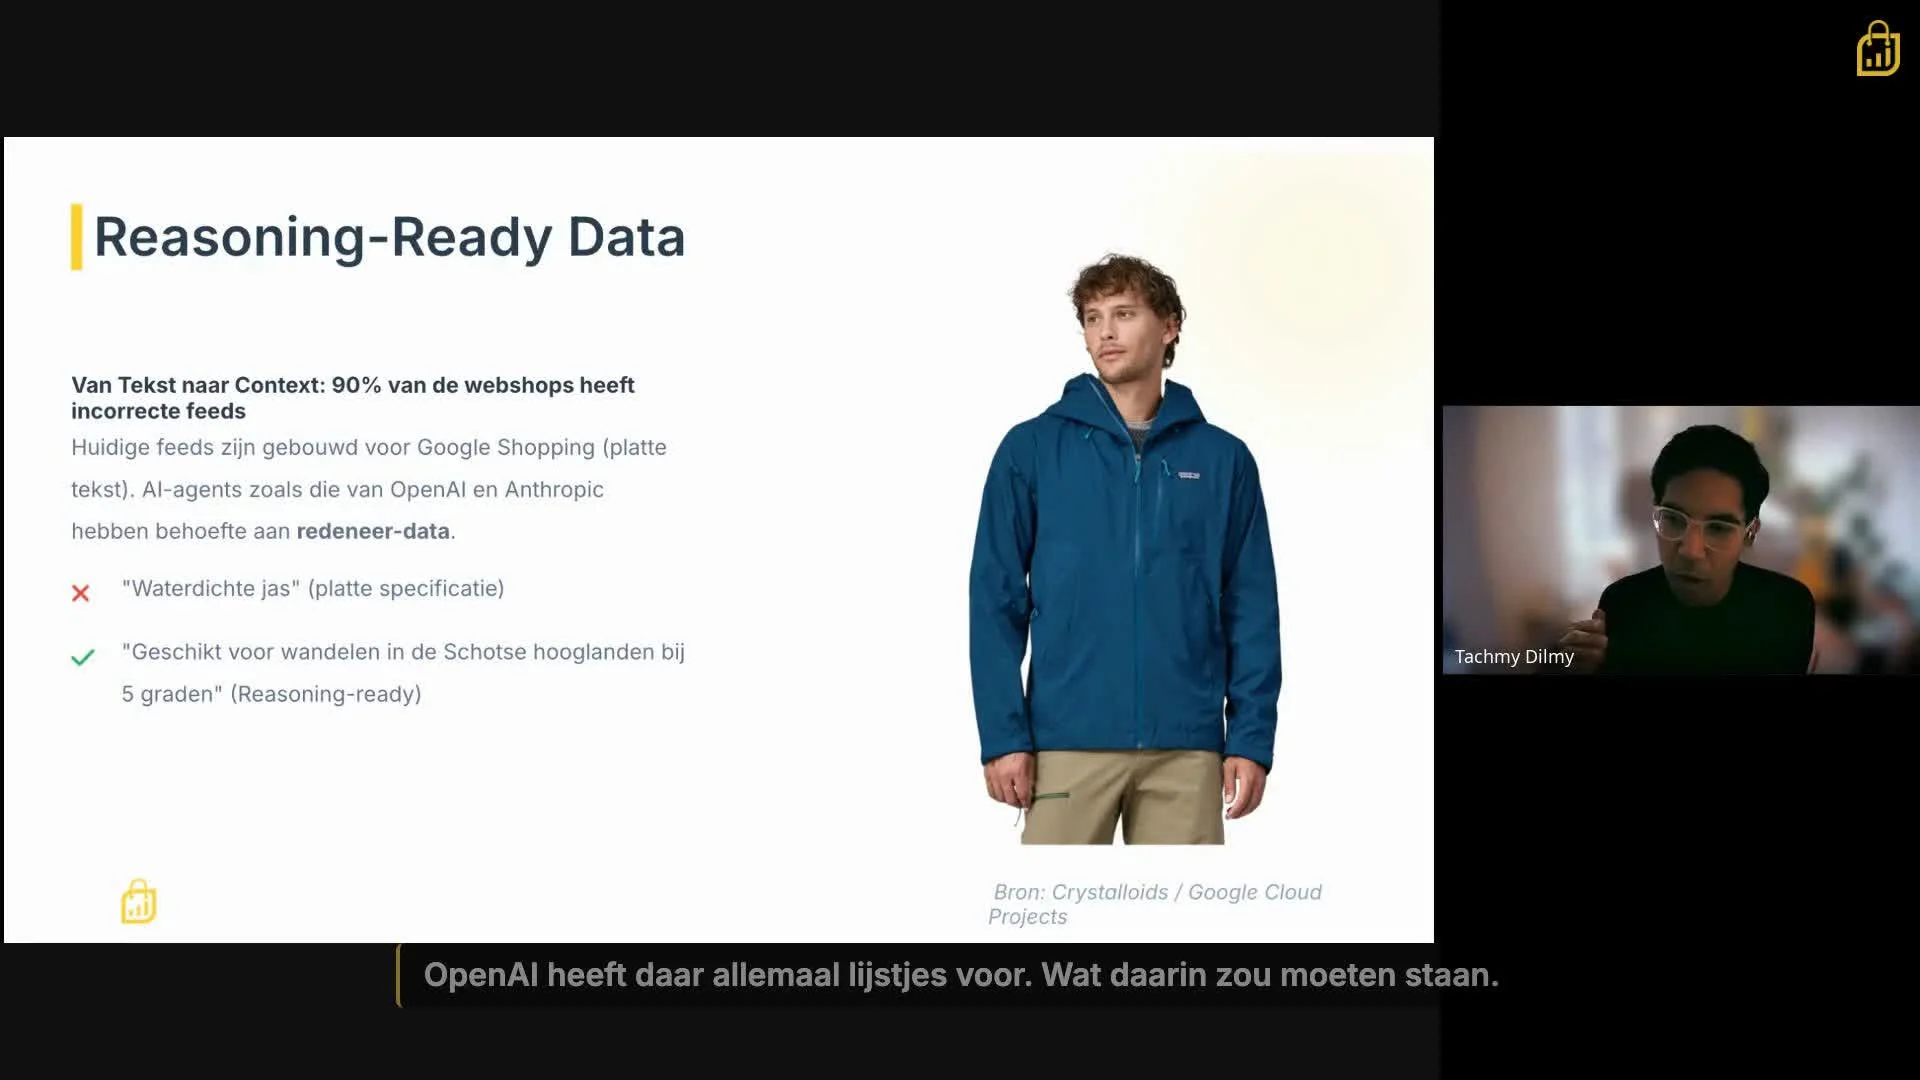
AI Feeds: verder dan platte specs
Tachmy Dilmy, eCommerce AI Club
Je feed vullen met platte specs? AI agents willen redeneerdata