Twee AI-titels per SKU: opzet van een zelflerende test
Ruben Runneboom, Taskforce
Uit de sessie: Marketing: Advertising in the Age of AI
Ruben Runneboom van Taskforce laat de opzet zien van een zelflerende feedtest voor Medisave. Productdata uit Merchant Center en zoektermen uit Search Console komen in een master spreadsheet. Een n8n-flow maakt twee nieuwe titels per SKU, die in een testaccount tegen de originele titel draaien.
Voor wie: Je wilt zien hoe je producttitels met AI genereert en in een eigen test vergelijkt.
Hetzelfde moment
- Clip van 3:07 min: Twee nieuwe producttitels per SKU met n8n en OpenAI
Waarom dit ertoe doet
Zelf titels laten schrijven door AI is makkelijk. Weten welke titel beter werkt is lastiger. Taskforce bouwt een systeem dat zichzelf optimaliseert, zodat je binnen Shopping vooral nog budget en de mate van agressiviteit hoeft te sturen. Dit hoofdstuk laat de hele flow zien, van export tot vergelijking, met drempels voor welke producten meedoen.
Belangrijkste inzichten
- Het hoofdaccount en testaccount draaien in Nederland met een geosplit en een andere CSS.
- Productattributen uit Merchant Center en Search Console-data per landingspagina komen samen in een master spreadsheet.
- Een n8n-flow met een guidelinedocument maakt twee titels per SKU: een uit attributen, een uit zoektermen.
- Elke SKU heeft drie varianten: de basistitel plus titel 1 en titel 2.
Twee accounts en een geosplit
Medisave heeft twee Google Ads-accounts, wat het bureau niet zelf koos; het kwam uit eerdere tests. Taskforce draait nu een hoofdaccount en een testaccount, beide in Nederland, elk op een andere CSS, met een geosplit waarbij regio's op branchekenmerken gelijk zijn verdeeld. Zo is de test redelijk eerlijk.
De flow van data naar titels
Alle productattributen uit het Merchant Center van het hoofdaccount gaan via een export in een master spreadsheet. De Search Console-data haalt Taskforce met de tool Markifact op landingspaginaniveau, inclusief de ingetypte zoekopdrachten, en koppelt die per landingspagina aan elk product. Een flow in n8n genereert twee titels per SKU. Een komt uit de extra attributen, de ander uit de zoektermen. Een guidelinedocument stuurt het taalmodel, met regels voor opbouw, tekenlengte en materiaal. De titels gaan terug in de spreadsheet.
Drie varianten en de vergelijking
In Channable maakt Taskforce twee duplicaten per SKU, een met titel 1 en een met titel 2. Samen met de basistitel zijn dat drie varianten per SKU. Die gaan naar het testaccount. Een product doet alleen mee als het voldoet aan drempels: er moet spend zijn, en er moet een aankoop zijn geweest om de kosten per acquisitie en de ROAS te kennen. Scripts in beide accounts vergelijken per periode welke variant het best presteert.
Probeer dit deze week
- Maak een exportbestand van je Merchant Center met alle attributen en voeg per product de landingspagina toe.
- Schrijf een guidelinedocument van 1 pagina met regels voor titelopbouw en tekenlengte, voordat je een model titels laat maken.
Begrippen
- Geosplit
- Een test waarbij je regio's verdeelt over twee groepen, zodat je varianten naast elkaar kunt vergelijken.
- CSS
- Comparison Shopping Service, een partij die je Shopping-advertenties bij Google plaatst.
- n8n
- Een tool om automatiseringsflows te bouwen die diensten en AI-modellen koppelt.
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
En ja, wat wij zo tof vinden is ja, hoe bouw je eigenlijk een zelflerend systeem, een zelfoptimaliserend systeem, dat je eigenlijk je handen er vanaf kan trekken, maar dat je eigenlijk weet, ja, naarmate dit systeem langer loopt, hoe kan je ervoor zorgen dat dat zichzelf optimaliseert en dat je eigenlijk geen omkijker meer na hebt en op die manier zoveel mogelijk uit je shoppinglist kan halen en dat je eigenlijk, ja, binnen de shoppingcampagnes alleen nog je budgetten en ja, de actie, ja, de mate van agressiefheid van target hoeft te optimaliseren, dat eigenlijk de product zichzelf optimaliseert. Dus eigenlijk best wel een gave use case, al zeg ik het zelf, om mezelf even de hand in eigen boezem te steken. Maar ja, dat is denk ik wel heel leuk om even te laten zien hoe dat in dit geval kan. Dus ik zal hier nu even een soort van webflow laten zien hoe wij dat in dit geval doen. Wij werken voor Medisave met twee Google Ads accounts. Dat is niet iets wat we zelf hebben gekozen, maar dat was al aanwezig, omdat ze bepaalde andere tests in het verleden hebben uitgevoerd. Maar eigenlijk wat wij momenteel doen, is dat we een main account hebben en een testaccount. We draaien allebei in dit geval Nederland, we draaien allebei op een andere CSS en hebben een geosplit erin zitten, waarbij eigenlijk de regio's gelijkwaardig verdeeld zijn qua specifieke kernmerken voor deze branche. zodat we eigenlijk een soort van enigszins goede testen kunnen draaien, wat we dan ook willen gaan testen. Dus in principe wat we proberen te doen, is wij trekken eigenlijk alle productinformatie uit het Google main account, dus via het Merchant Center account, draaien wij in een export, dus daar zitten alle productattributen erin, die pushen wij in een master spreadsheet. Dus daar staan eigenlijk alle attributen in, Dus niet alleen de titel en dat soort zaken, maar alles wat er bekend is. Vervolgens proberen wij ook dus vanuit de Search Console de data te trekken om dat met elkaar te combineren. Dus in dit geval heb je daar een tool voor, dat heet Markifact. En dat is eigenlijk een tool waarbij je dus op landingspaginaniveau kan je die data eruit trekken uit de Search Console. En daar kan je dus ook bij de daadwerkelijk ingetypte zoekopdrachten binnen Google Organic, dus gewoon in de zoekbalk, krijg je er allemaal mee. En dan kun je dus ook zien op wat voor resultaten dat er uiteindelijk is geland. Wat we dus doen, is dat we in die master spreadsheet combineren de data. Dus dan heb je uiteindelijk de productinformatie uit je Google Main Account, zet je in de master spreadsheet. En op basis van de landing page, want er zit natuurlijk aan elk product hangt de landing page. Op basis van die landing page kunnen wij die data matchen, zodat we dus die Google Master Spreadsheet kunnen verrijken met de extra zoektermen. Dus dan hebben we daar gewoon speciale kolommen voor neergezet per SKU in dit geval, zodat we daar een wat slimmere flow in hebben. Vanuit die Google Master Spreadsheet hebben we een flow lopen. Dat gaat via N8N of Nathan, hoe ook iedereen dat noemt. Iedereen noemt het anders. Wat we eigenlijk doen in dit geval is dat we twee nieuwe titels genereren voor elke SKU. Dus dat doen we één titel op basis van de additionele attributen die vanuit, in dit geval vanuit het Merchant Center komt, maken we daar dus een combinatie van die attributen, maken we dus een nieuw titel van. Dus daar zit een flow in, in n8n, om op basis van onze best practices, dus we hebben eigenlijk een heel guideline document gemaakt voor het is voor de lm die in die en het en flow zit oké om het moment als je dus nieuwe titel moet genereren moeten hier aan voldoen het denk bijvoorbeeld aan de opbouw van verschillende attributen maar denk daarbij aan de karakter lengte moet je materiaal voor dit zet op voor dat zetten dus hebben speciaal voor deze branche hebben daarin guide line of guide reels voor gemaakt waarbij die dus op basis van die nieuwe product attributen maakt die een nieuw titel, maar dat doet hij dus ook voor die Markifact data. Dus eigenlijk maakt hij dus op basis van alle zoektermen die op die landing page bekend zijn, maakt hij ook een nieuwe titel variant van. Volgens importeren we eigenlijk dus vanuit die flow, gaat eigenlijk dus die twee nieuwe titels, die gaan weer terug in die mass spreadsheet. Dus die mass spreadsheet, dat wordt uiteindelijk best wel een hufte van het bestand. maakt in dit geval niet uit maar voor de test werkt het prima ze eigenlijk wat vanuit daar doen is wat we wat we doen is we maken in channel maak er een nieuw product feed van hebben ze eigenlijk gewoon een duplicaat waarbij we de nieuwe titels koppelen aan de juiste attributen vervolgens maken dus twee duplicaten per sku dus eentje met de nieuwe titel 1 en de andere met de titel 2 en dus eigenlijk dat je uiteindelijk ja dus dus drie titels hebt dus de basis titel variant 1 en variant 2 zodat je drie varianten hebt per SKU. Nou deze SKU's, die nieuwe titels die ja die koppelen in principe aan een nieuwe aan Google test account waarbij ze eigenlijk ja de campagnes in gaan en proberen data te verzamelen. Nou dat loopt natuurlijk, op de andere kant op. Uiteindelijk wat we dus doen is we gaan kijken oké welke producten komen in aanmerking voor dit voor onze test dus elke product moet voldoen aan een aantal randvoorwaarden om mee te doen aan de test zo moeten bijvoorbeeld enige spend op een bepaald product zijn omdat er anders geen data komt nou we willen ook dat er een purge is op plaatsgevonden heeft want anders weten niet wat de performance is hebben weten we niet wat de kost per acquisitie is en de weten niet wat de rol als is ze hebben daarin ja eigenlijk in dit stukje hebben we dus een aantal thresholds bepaald waaraan die producten kunnen voldoen vervolgens hebben we in beide accounts hebben we twee scripts draaien die de performance met elkaar kunnen vergelijken dus we hebben dus in een main account en google test account hebben dus in dit geval dezelfde SKU's lopen alle zij hetzelfde met andere titels en op basis daarvan wat hij dus doet is oké in de periode welke variant heeft de beste performance. Dat kunnen we gewoon uit elkaar halen.
Spreker: Ruben Runneboom, Taskforce
Meer over Productdata & Feeds
 Duur 1:39
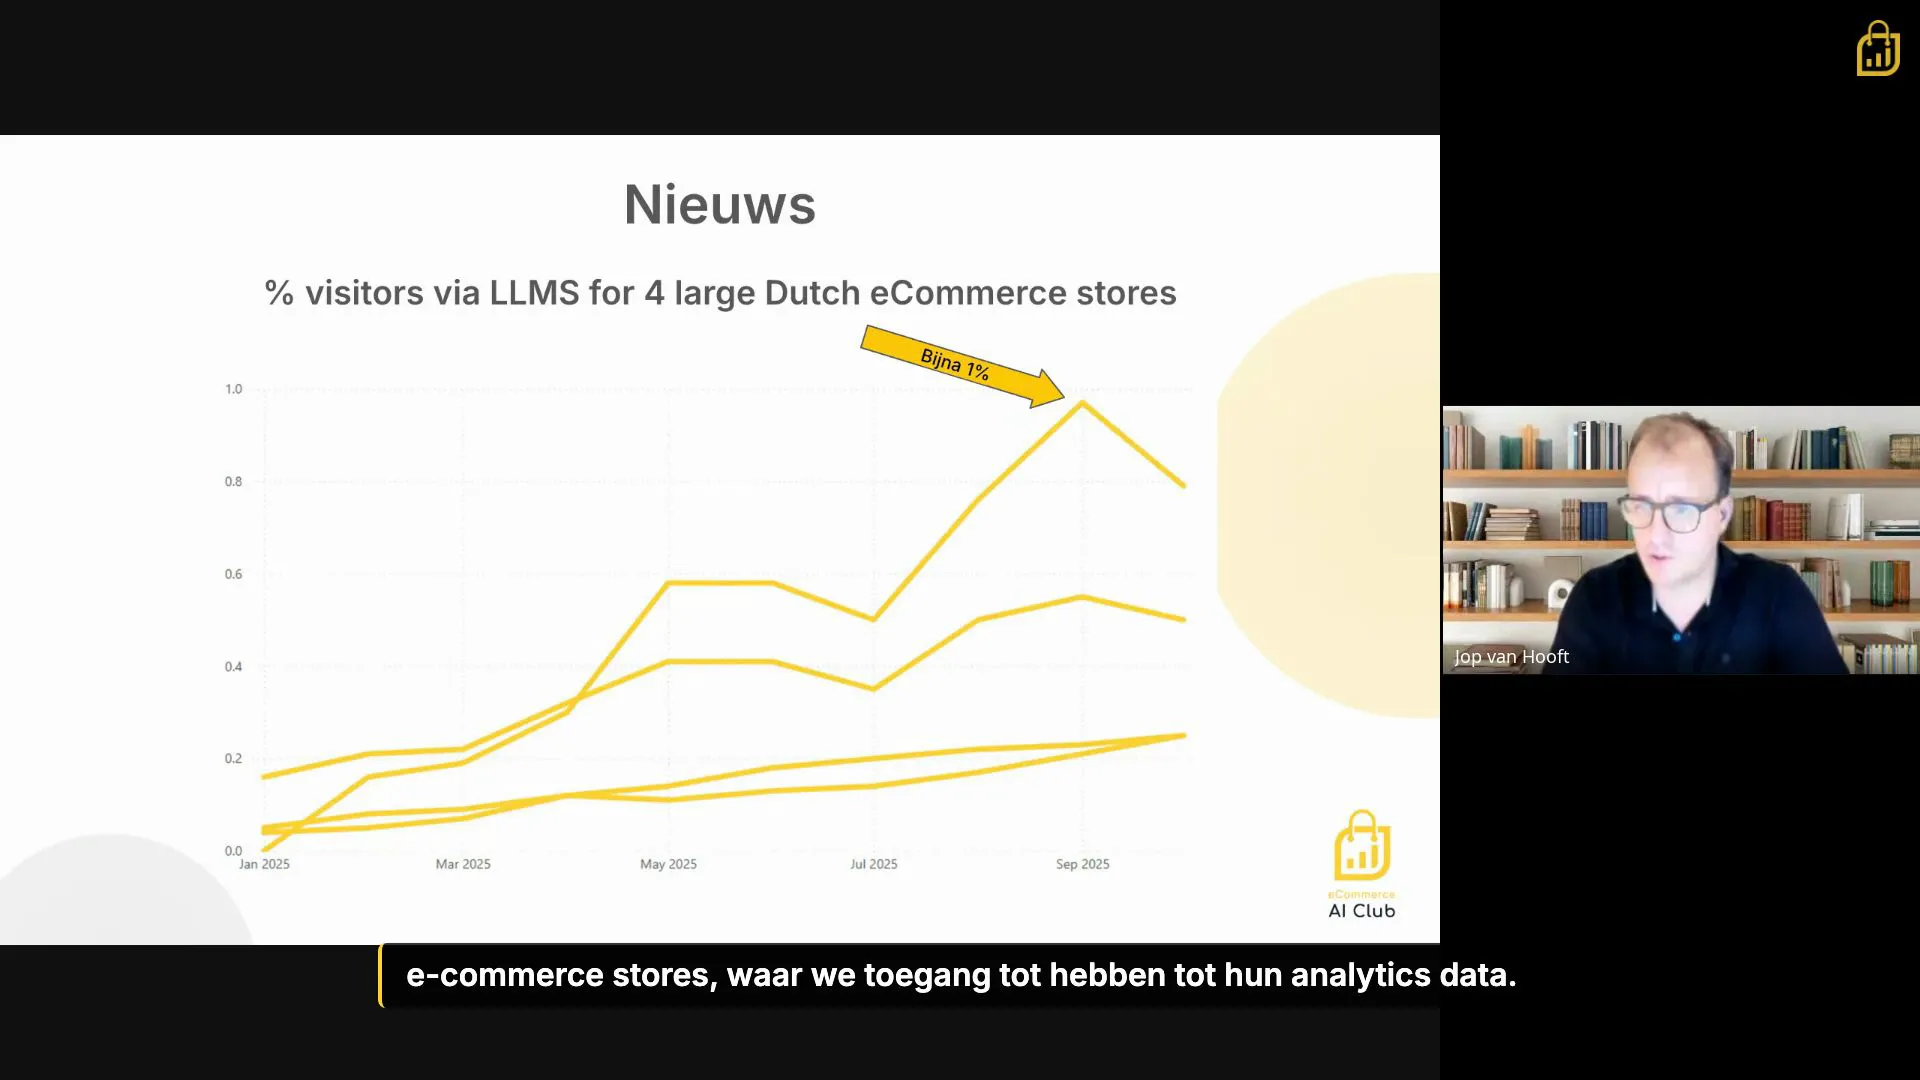
Hoeveel verkeer komt via LLMs bij Nederlandse webshops?
Jop van Hooft, eCommerce AI Club
Slechts 1% van je websiteverkeer komt via LLMs, maar het groeit exponentieel
 Duur 0:40
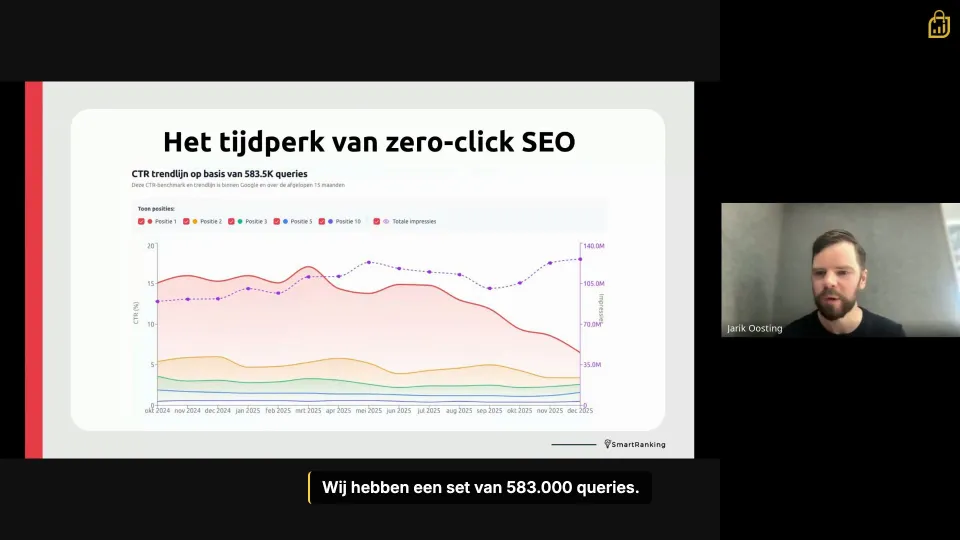
Zero-Click SEO
Jarik Oosting, Smart Ranking
De CTR voor positie 1 in Google is met meer dan de helft gedaald
 Duur 0:41
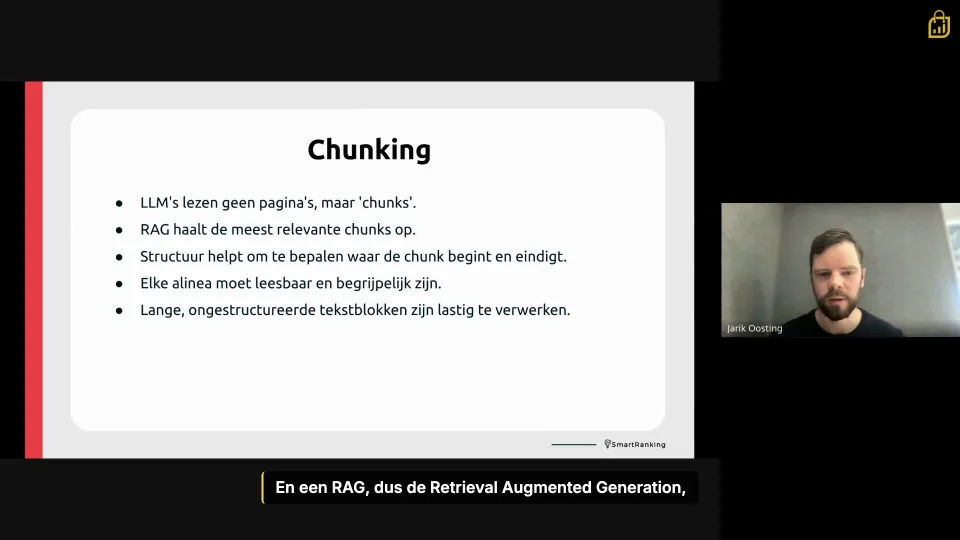
Zo leest een LLM jouw website
Jarik Oosting, Smart Ranking
Een LLM leest niet je hele pagina, alleen de relevante chunks