Het gevaar van AI-browsers: prompt injection
Tachmy Dilmy, eCommerce AI Club
Uit de sessie: Maandelijkse Meeting nov 2025
Tachmy Dilmy laat twee aanvallen zien waarmee een AI-browser kan worden gekaapt: onzichtbare tekst op een webpagina en besmet geheugen. Je krijgt de achtergrond bij beide dreigingen en wat je als webshop of gebruiker kunt doen.
Voor wie: Jij of je team gebruikt een AI-browser of agent die ingelogd is op mail, advertentie- of betaalaccounts.
Waarom dit ertoe doet
AI-browsers zoals Comet, Atlas of Claude voor Chrome lezen een pagina en voeren daarna acties uit namens jou. Dat is handig voor een inkoper die prijzen vergelijkt, maar het is een nieuw aanvalsoppervlak. Brave toonde in augustus 2025 aan dat een verborgen opmerking op Reddit de Comet-browser kon laten verwijzen naar het e-mailadres van de gebruiker en een eenmalige inlogcode uit Gmail, waarmee een account overgenomen kon worden. De gebruiker had alleen op 'vat deze pagina samen' geklikt. Als je team een AI-browser gebruikt, is het handig te weten welke accounts daarin ingelogd zijn en welke acties zonder bevestiging mogen.
Belangrijkste inzichten
- Prompt injection werkt doordat een model instructies in gelezen inhoud niet betrouwbaar scheidt van jouw opdracht; de tekst hoeft niet zichtbaar te zijn.
- Brave toonde op 20 augustus 2025 aan dat een verborgen Reddit-reactie de Comet-browser een inlogcode uit Gmail liet lezen.
- LayerX meldde in oktober 2025 de 'Tainted Memories'-aanval op ChatGPT Atlas; OpenAI zegt dat het niet reproduceerbaar is.
- Brave adviseert bevestiging voor gevoelige acties en het scheiden van agentisch en gewoon browsen.
- OWASP noemt least privilege en menselijke goedkeuring als maatregelen en zegt dat geen methode volledig sluit.
Wat prompt injection is
Prompt injection is een kwetsbaarheid waarbij invoer het gedrag van een taalmodel op ongewenste manieren verandert. OWASP, de organisatie die de bekendste lijst met beveiligingsrisico's voor taalmodellen bijhoudt, rekent het tot het grootste risico en maakt onderscheid tussen directe en indirecte injectie. Bij indirecte injectie leest het model externe inhoud, zoals een webpagina of bestand, met instructies erin. De tekst hoeft niet zichtbaar te zijn voor een mens, het moet alleen door het model worden gelezen. Het model kan opdracht en inhoud namelijk niet betrouwbaar uit elkaar houden.
Dreiging een: comment jacking
In de clip heet dit comment jacking: onzichtbare of onopvallende tekst in een reactie, zoals witte tekst op een witte achtergrond. Het bekendste gedocumenteerde voorbeeld komt van Brave, dat op 20 augustus 2025 beschreef hoe verborgen instructies in een Reddit-reactie, achter een spoilertag, de Comet-browser van Perplexity manipuleerden. Zodra de gebruiker op samenvatten klikte, haalde de assistent het e-mailadres op, startte een inlogpoging en las de eenmalige code uit Gmail. Brave meldde het op 25 juli 2025. De eerste fix bleek onvolledig, en Brave schrijft dat latere tests lieten zien dat het probleem niet volledig was opgelost. Houd er rekening mee dat de term 'comment jacking' in de clip niet de naam is die Brave gebruikt.
Dreiging twee: tainted memories
De tweede dreiging gaat over het geheugen van de AI. Beveiligingsbedrijf LayerX meldde in oktober 2025 een zwakte in ChatGPT Atlas, die zij 'Tainted Memories' noemden: een kwaadaardige pagina zou via een zogenaamde CSRF-aanval verborgen instructies in het geheugen van ChatGPT kunnen schrijven, die bij later gebruik worden geactiveerd. OpenAI betwist dit en zei het resultaat niet te kunnen reproduceren en geen misbruik in de praktijk te hebben gezien. De kwetsbaarheid staat dus niet vast. Het idee dat een geheugen een aanvalsroute is, blijft wel een serieus ontwerpprobleem.
Wat helpt
Brave raadt aan pagina-inhoud altijd als onbetrouwbaar te behandelen, acties te controleren op overeenkomst met jouw opdracht, bevestiging te eisen voor gevoelige acties zoals mailen, en agentisch browsen te scheiden van gewoon browsen. OWASP noemt als maatregelen onder meer least privilege en menselijke goedkeuring bij risicovolle acties, en zegt dat geen enkele methode sluitend is. De les uit de clip volgt daaruit: geef een AI-browser zo weinig rechten als nodig en blijf zelf bevestigen.
Probeer dit deze week
- Inventariseer welke accounts (mail, boekhouding, advertenties) ingelogd zijn in de browser waarin je team AI gebruikt, en log uit wat niet nodig is.
- Gebruik een apart browserprofiel zonder opgeslagen logins voor AI-agenttaken.
- Zet de geheugenfunctie van je AI-tool uit of beperk die voor accounts met toegang tot klant- of betaalgegevens, en spreek af dat mailen en betalen altijd handmatig wordt bevestigd.
Begrippen
- Prompt injection
- Een aanval waarbij verborgen instructies in tekst een taalmodel iets laten doen wat de gebruiker niet vroeg.
- Indirecte injectie
- De instructie zit niet in jouw vraag maar in externe inhoud, zoals een webpagina, die het model leest.
- Comment jacking
- Term uit de clip voor het kapen van een AI via onzichtbare tekst in reacties op een pagina.
- Tainted memories
- Besmet AI-geheugen: een instructie die in het geheugen van de assistent komt en later wordt geactiveerd.
- Least privilege
- Het principe dat een systeem alleen de minimale rechten krijgt die nodig zijn voor de taak.
Verdiep je in de gids
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
1 is een Cometjacking. [onverstaanbaar] Dat is: een agent krijgt een soort van injectie van een prompt, en dat kan gebeuren zoals je bijvoorbeeld door Reddit aan het browsen bent, dat er in een witte tekst iets staat waardoor die iets gaat doen wat je helemaal niet wil, dat er [onverstaanbaar] geïnjecteerd wordt.
En het tweede is tainted memories. Dat is een beetje op dezelfde manier: je browsert over allerlei websites heen, hij vult het AI geheugen van jou met allemaal dingen die je niet wil, en op een gegeven moment gaat hij die dingen ook daadwerkelijk gaan uitvoeren. En dit zijn twee van die voorbeelden waar dit soort browsers helemaal nog niet geschikt voor zijn, doordat ze het nog niet kunnen herkennen als: dit is niet een echte opdracht van de gebruiker, maar dat is een opdracht van een stukje tekst wat verwerkt op een pagina die ik nu bezocht heb.
En er komen allerlei benchmarks uit van: we zijn steeds meer in staat om dit soort prompt injections te herkennen, maar nog steeds, er zijn nog een groot aantal gevallen waarin dit gebeurt. En dat is ook waar ze het meest bang voor zijn: zijn Reddit pagina's waarin [onverstaanbaar] dingen toegevoegd zijn, niet per se Reddit zijn, maar wat dan ook, waarbij dan staat: en ga naar deze bankrekening en maak het geld over... [onverstaanbaar]
Spreker: Tachmy Dilmy, eCommerce AI Club
Bronnen
Meer over Security & Beleid
 Duur 1:20
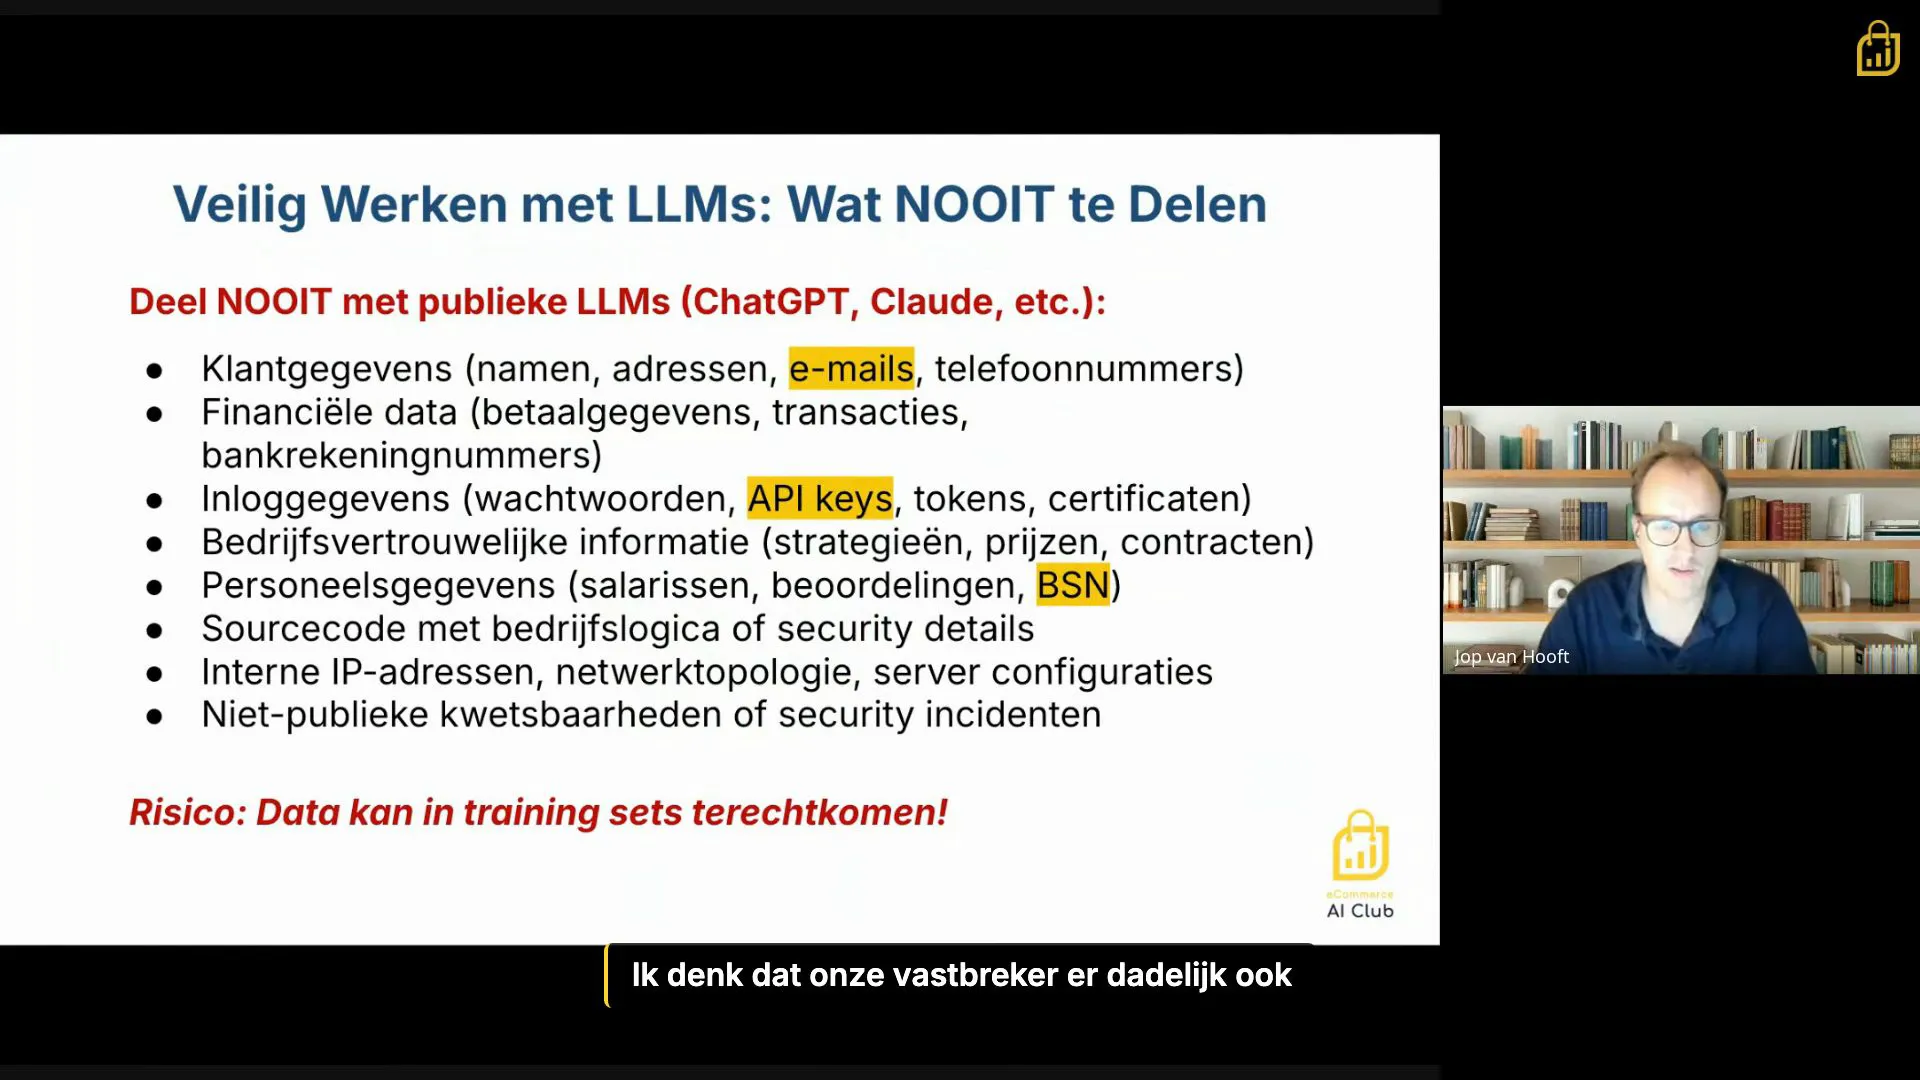
Wat NOOIT te delen met AI
Jop van Hooft, eCommerce AI Club
API-keys worden net zo makkelijk gedeeld als lunchplannen, en dat is gevaarlijk
 Duur 1:37
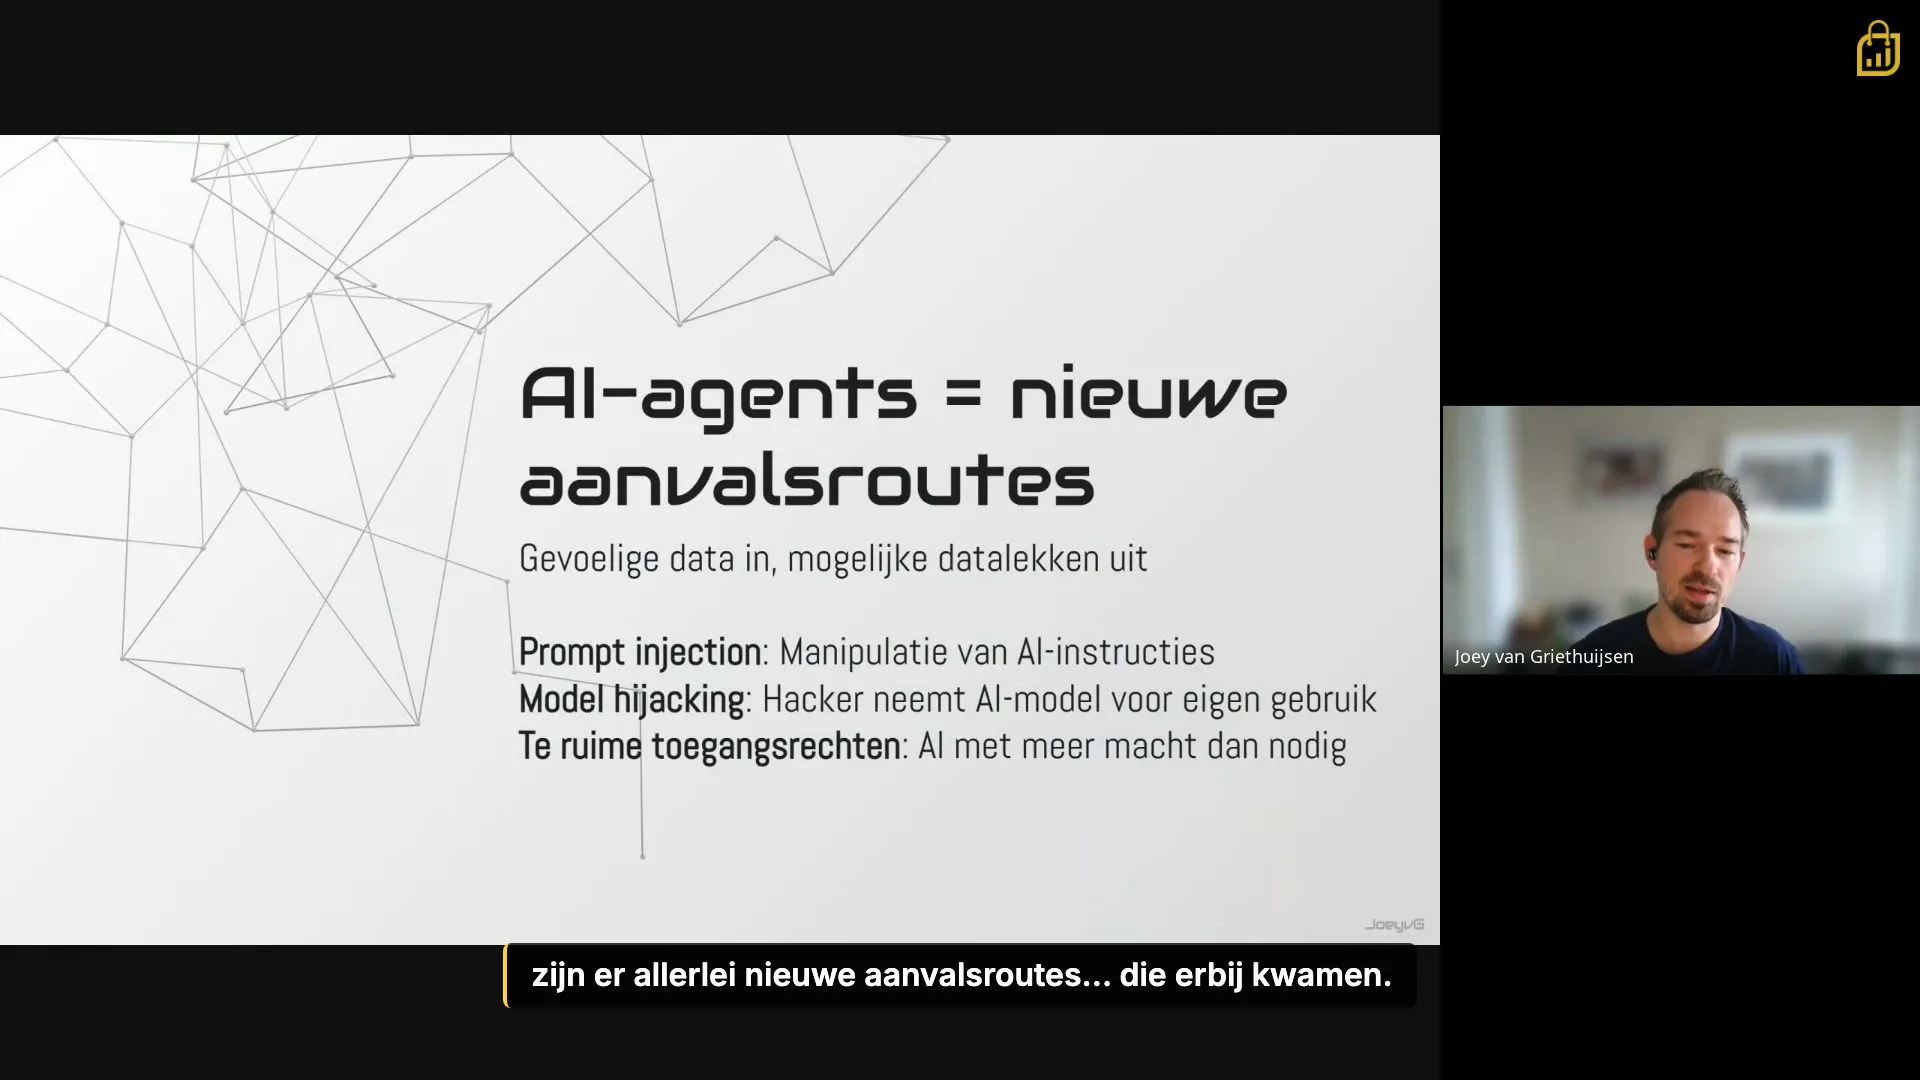
Te ruime toegangsrechten bij AI-agents
Joey van Griethuijsen, HumanAgent
n8n's eigen website gaf een AI-agent onnodig toegang tot Entra en Jira
 Duur 1:42
Data classificatie: hash, postcode en deep links
Jop van Hooft, eCommerce AI Club
Hash je e-mails, bewaar 4 cijfers postcode, deep-link naar Magento