AI-slop in je webshop: zo toets, meet en voorkom je generieke AI-content
, eCommerce AI Club
Afdeling: AI voor SEO en GEO, AI voor content en productdata
Voor e-commerce managers en eigenaren van NL en BE webshops (5 tot 200 FTE) die AI inzetten voor productteksten, mails en advertenties
Hoe voorkom je dat AI-teksten op je webshop slecht scoren?
Geef elke AI-tekst iets wat een model nog niet heeft: unieke data, specifieke details en gebruiksgevallen. Generieke content zit al in de trainingsdata en wordt niet opgehaald, legde Smart Ranking uit in onze sessie van maart 2026. Puur AI rankt volgens Digital Applied gemiddeld 23% lager. Laat feiten controleren voordat een tekst live gaat, zoals ook Google vraagt.
Feiten met datum en bron
- Azerty.nl testte ChatGPT 3.5 op 115 producten: gemiddeld 1,05 plek hogere posities en 185% meer verkopen. (, bron: thuiswinkel.org)
- Apicon testte handmatig 20 Nederlandse webshops: bij 19 van de 20 weken filters, productattributen en categorieën van elkaar af. (, bron: emerce.nl)
- In een studie van SE Ranking naar AI-content over 16 maanden viel het aandeel pagina's in de top 100 van 28% naar 3%. (, bron: frankwatching.com)
- Een taalmodel knipt je pagina in stukjes van ongeveer 100 woorden, met je koppen als snijlijn, legde Jarik Oosting van Smart Ranking uit. (, bron: video van onze sessie)
In 2025 kozen Merriam-Webster en de American Dialect Society allebei 'slop' als woord van het jaar. In september 2026 beschreef Google in een onderzoekspaper een systeem met de naam SAFE, bedoeld om massaal gemaakte AI-content op te sporen. Die twee feiten raken ook jouw webshop. Of AI je winst of schade oplevert, hangt van één ding af: wat je toevoegt dat het model zelf niet weet.
We rekenen in deze gids met één voorbeeldwinkel. Het is een illustratieve basis, geen echte klant: een webshop met 5.000 SKU's, 40.000 orders per jaar en een gemiddelde orderwaarde (AOV) van 65 euro. Dat is 2,6 miljoen euro omzet (40.000 maal 65). De producten staan in een PIM (bijvoorbeeld Akeneo), de feed loopt via Channable naar Google Merchant Center en bol.com, de shop draait op Shopify, Magento of WooCommerce, klantenservice op Zendesk of Freshdesk en de mails op Klaviyo of Spotler. Alle cijfers met 'aanname' zijn rekenwaarden: vervang ze door je eigen cijfers uit Analytics en Search Console.
Wat is AI-slop, en waar zit het in je webshop
Slop is AI-content in grote aantallen met weinig inspanning, kwaliteit of betekenis. Het woord kwam rond 2022 op en werd in mei 2024 breed bekend door programmeur Simon Willison (bron: Wikipedia, 2 november 2026). Voor een webshop is het een patroon: 5.000 productteksten met dezelfde zinsbouw, een Klaviyo-flow die iedereen al kent, advertenties die op die van je concurrent lijken.
Jop van Hooft liet het in februari 2026 in onze Champion-sessie zien op een slide met vier voorbeelden: outreach, e-mail, advertenties en productbeschrijvingen met 'overal dezelfde tekst'. Zijn vraag aan de zaal: hoe val je op als iedereen dezelfde tools gebruikt? Zijn antwoord: kwaliteit, authenticiteit en jouw unieke kennis. Zie de clip AI Slop: de tsunami die eraan komt.
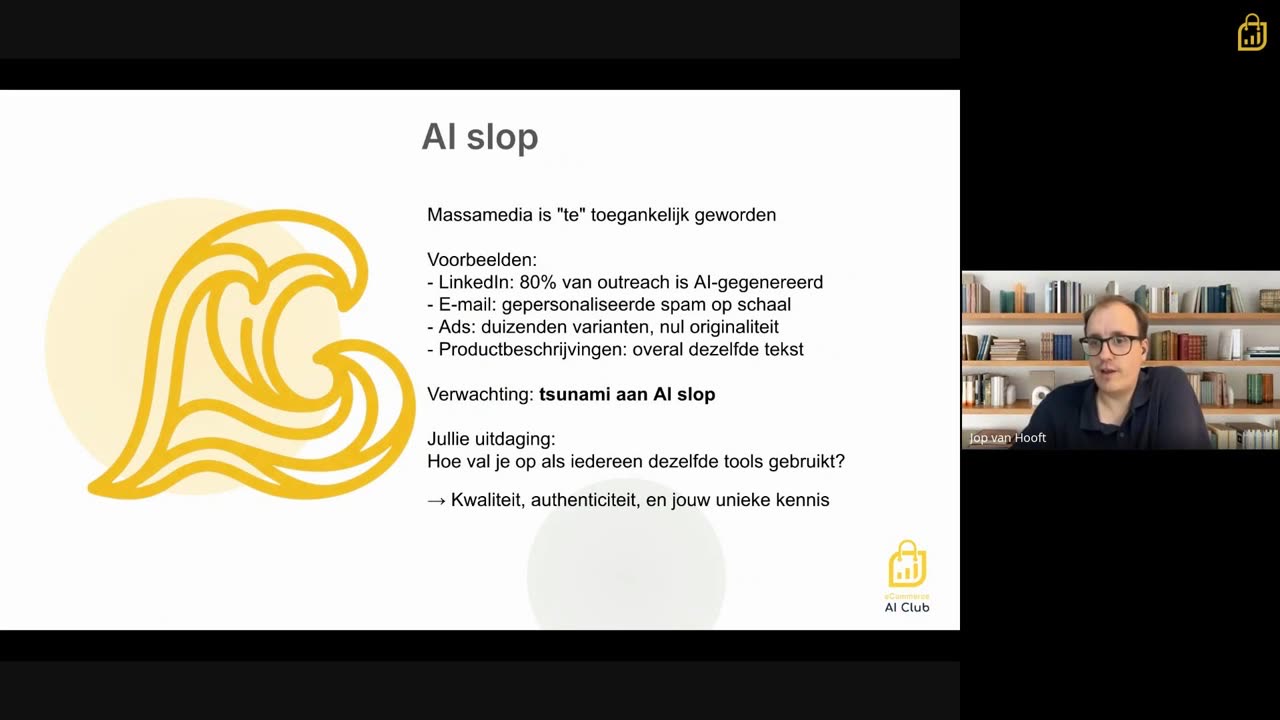
Slide uit de Champion-sessie van februari 2026: bij productbeschrijvingen noemt de slide 'overal dezelfde tekst'. De percentages op de slide hebben we niet gecontroleerd en gebruiken we niet.
Bron: eCommerce AI Club, clip 'AI Slop: de tsunami die eraan komt', gezien 2026-11-02
Uit onze sessies: bekijk de video
Wat Google letterlijk zegt
Het meeste dat je leest ('Google straft AI-content') klopt niet. Google toetst het resultaat, niet het gereedschap. De regels zijn wel scherp.
| Regel | Wat er staat | Wat het voor je webshop betekent |
|---|---|---|
| Spambeleid: scaled content abuse | Veel pagina's maken 'for the primary purpose of manipulating search rankings and not helping users'. Genoemd: generatieve AI gebruiken voor veel pagina's zonder waarde voor gebruikers, en automatische transformaties zoals synoniemen vervangen of vertalen (spambeleid). | Vertaal je 5.000 productteksten met AI naar Duits en Frans zonder iets toe te voegen, dan val je mogelijk onder dit voorbeeld. Dat is relevant voor een NL-shop die naar BE of DE uitbreidt. |
| Gevolg | Sites die het beleid schenden 'may rank lower in results or not appear in results at all'. | Verdwijnen uit de resultaten is mogelijk, niet alleen zakken. Search Engine Journal meldde in september 2026 over SAFE, een Google-paper over een AI-detector voor slop zonder cijfers; of het live is, is niet bevestigd. |
| Gen-AI-richtlijn | 'It is critical to manually factcheck and review all AI-generated content'. Dat geldt ook voor titels, metabeschrijvingen, structured data en alt-teksten (richtlijn). | Je review dekt ook de metadata. |
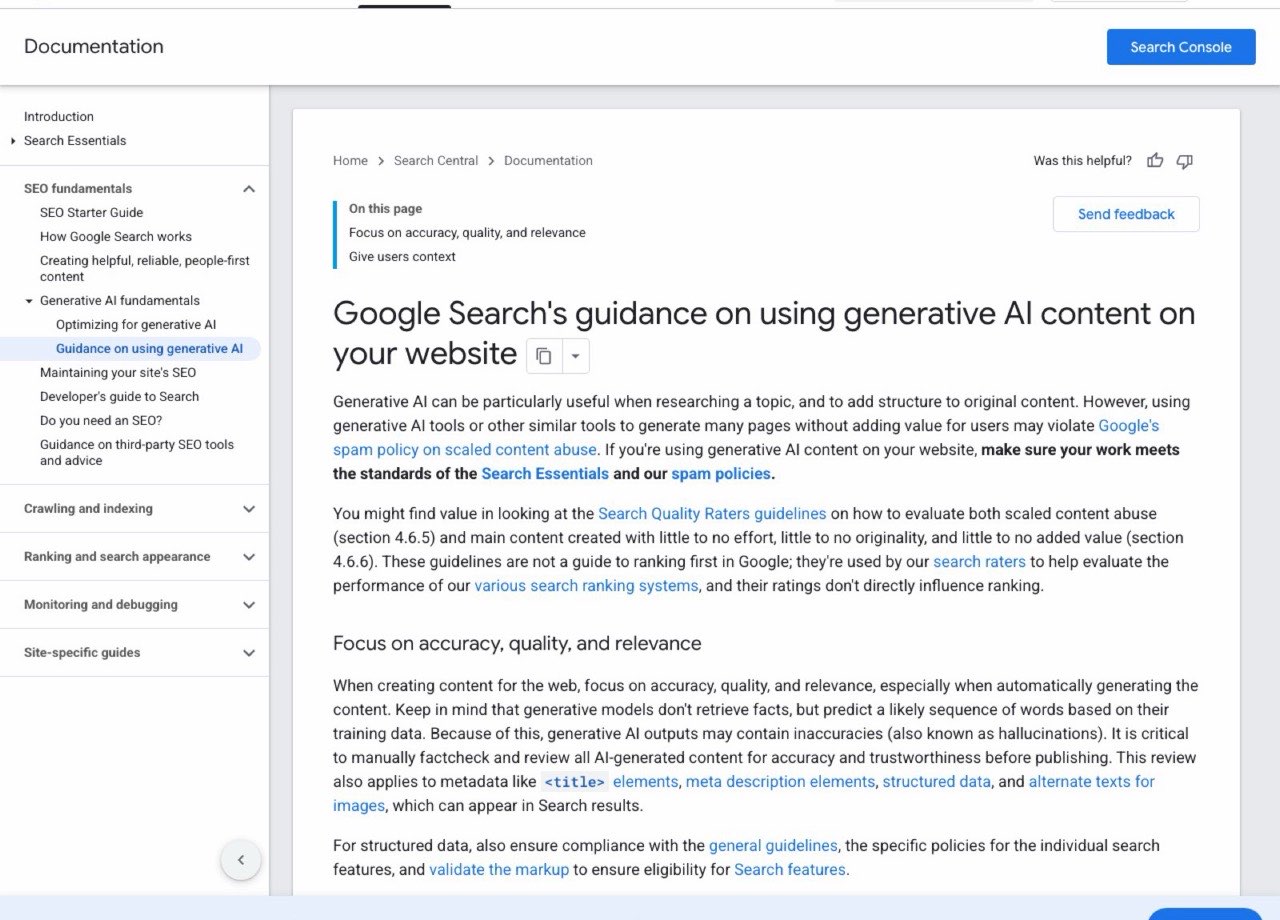
De officiële Google-pagina met de factcheck-regel voor AI-content, inclusief metadata zoals title, meta description, structured data en alt-tekst. Onderkant van de cookiebalk bijgesneden.
Bron: Google Search Central, 'Guidance on using generative AI content', gezien 2026-11-02
Voor Google Shopping geldt een eigen, geverifieerde regel. In de Merchant Center-hulppagina staat dat je met generatieve AI gemaakte titels en beschrijvingen moet aanleveren via `structured_title` en `structured_description`, met `digital_source_type` op `trained_algorithmic_media`. AI-afbeeldingen moeten de IPTC-tag DigitalSourceType houden en die tag mag je niet verwijderen. Controleer in Channable of je feedregels deze velden kunnen vullen. Anders loopt je goedkeuringspercentage (feed approval rate = goedgekeurde items gedeeld door ingediende items) risico.
Het bewijs: vier onderzoeken en één NL-pilot
De onderzoeken spreken elkaar deels tegen omdat ze 'AI-content' anders definiëren. Lees de tabel als vier verschillende vragen. De cijfers van Semrush, Digital Applied, SE Ranking en Rankability kennen we alleen via het overzicht van Frankwatching (28 juli 2026). Het Ahrefs-cijfer hebben we bij de bron gelezen.
| Onderzoek | Opzet | Resultaat | Wat je eruit haalt |
|---|---|---|---|
| Ahrefs (juli 2025) | 100.000 zoekwoorden, top 20, ongeveer 600.000 pagina's | 86,5% van de topresultaten bevat enige AI-content, 4,6% is puur AI. Correlatie AI-percentage met positie: 0,011. | AI-gebruik is geen rankingfactor. Puur AI is zeldzaam in de top. |
| Semrush (april 2026) | 20.000 zoekwoorden, 42.000 blogposts | Positie 1 is 8 keer vaker menselijk geschreven dan puur AI. | Voor plek 1 wint puur AI niet. |
| Digital Applied (maart 2026) | 4.200 artikelen, 140 domeinen, 16 maanden | Puur AI rankt gemiddeld 23% lager. Kloof groeit van 14% (3 maanden) naar 31% (16 maanden). | Het verlies komt langzaam. Meet lang genoeg. |
| SE Ranking (maart 2026) | 2.000 AI-artikelen, 20 nieuwe domeinen, 16 maanden | Maand 2 en 3: 28% in de top 100. Daarna 3%. Na spamupdates 3,2 keer vaker uit de index dan menselijke content. | Vroege resultaten zeggen niets. Uit de index vallen is erger dan zakken. |
Van 28% naar 3% betekent dat 25 van de 28 procentpunten verdwijnen: ongeveer 89% van de pagina's die eerst scoorden. In de Digital Applied-studie hadden pure AI-pagina's na twaalf maanden gemiddeld 1,6 backlinks, menselijke pagina's 4,2 (2,6 keer zoveel) en AI-ondersteunde pagina's 3,9. Het tussenmodel gebruikt AI als gereedschap, met een mens als eigenaar.
Het toetsmodel: Bron, Brein, Bestaansreden
Elk stuk content haalt drie toetsen voordat het live gaat. Faalt het op één, dan is het slop, hoe goed de zinnen ook lopen.
| Toets | Vraag | Faalsignaal | Reparatie |
|---|---|---|---|
| Bron | Staat er iets in dat het model zelf niet kon weten? Eigen data, retourredenen, Zendesk-klantvragen. | Je vervangt de tekst door de uitvoer van een standaardprompt en niemand merkt het. | Eén eigen feit per tekst: een maat uit je retourdata, een klantvraag, een eigen foto. |
| Brein | Heeft een benoemde mens de feiten gecontroleerd en zijn naam eronder gezet? | Niemand weet wie het nakeek, of 'het team'. | Eén eigenaar per contentsoort, een reviewer die niet de maker is. |
| Bestaansreden | Kun je in één zin zeggen waarom een klant deze pagina nodig heeft? | Je maakt de pagina omdat je een feedveld of zoekwoord kunt vullen. | Samenvoegen met een sterkere pagina, of niet maken. |
Een Nederlands voorbeeld voor de Bron-toets: in onze sessie met Tijmen van den Elzen van Engaige. Het Nederlandse merk Mr. Marvis noemt zijn broeken 'The Originals' of 'The Classy'. Voor klanten is dat duidelijk. Een model zonder context weet niet wat 'The Classy' is en vult de tekst aan met algemene broekpraat. De reparatie die hij liet zien: laad productnamen, collectienamen en synoniemen in de kennisbasis. Dat is brondata, en het kost volgens de clip enkele uren. Bekijk het fragment in Hoe Mr. Marvis AI trainde op merkspecifieke productnamen.
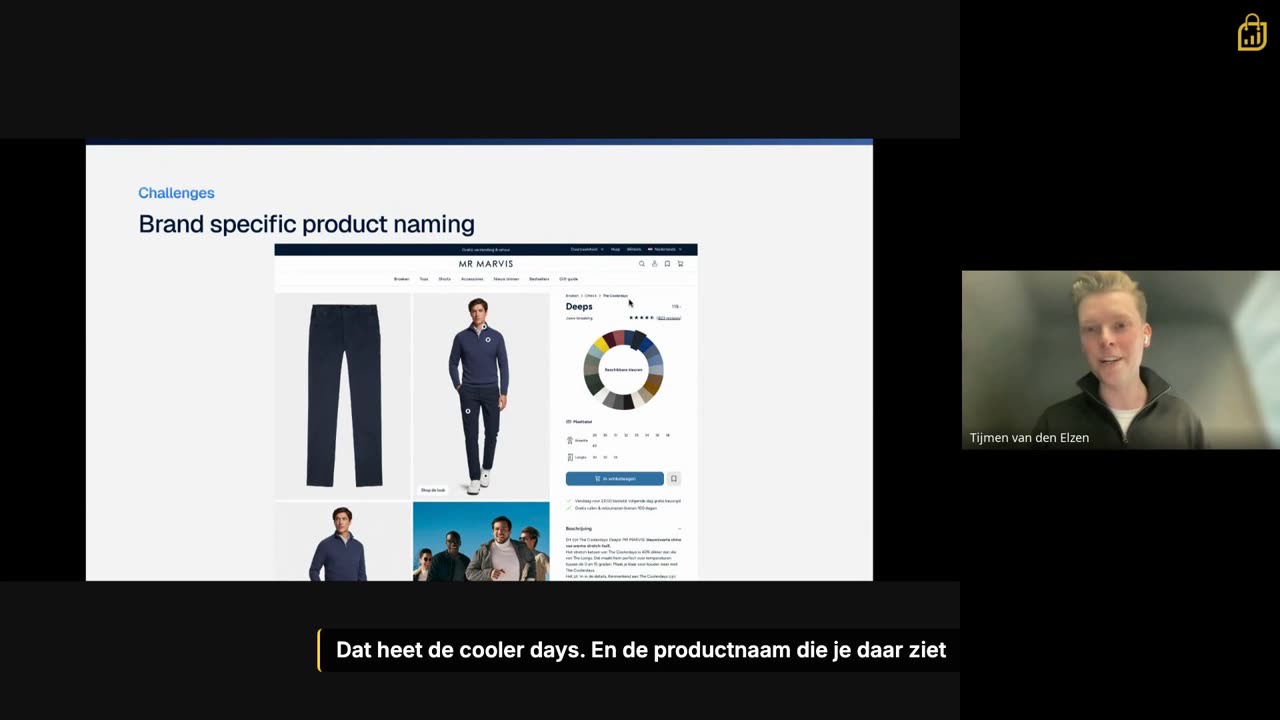
Slide van Tijmen van den Elzen (Engaige) met een echte Mr. Marvis-productpagina. De naam bovenaan is een merknaam, geen feedveld als 'broektype'; een model moet die kennen voordat het erover schrijft.
Bron: eCommerce AI Club, clip over Mr. Marvis (maandelijkse meeting december 2025), gezien 2026-11-02
Uit onze sessies: bekijk de video
Een tweede Nederlandse bron laat zien hoe vaak de brondata zelf het probleem is. Apicon testte handmatig 20 Nederlandse webshops: bij 19 van de 20 weken filters, productattributen en categorieën van elkaar af. Bij een supermarktshop toonde de categorie 'volkoren brood' 18 producten, maar met het filter 'volkoren' bleven er 6 over, omdat 12 producten het attribuut misten (Emerce, 10 juni 2026). Apicon verkoopt productdata-diensten (het stuk is een persbericht). Een AI-tekst kan een ontbrekend attribuut niet repareren. Hij verzint het of laat het weg.
Jarik Oosting van Smart Ranking legde in onze maandelijkse sessie van maart 2026 uit waarom generieke content geen kans heeft: een model heeft die al in zijn trainingsdata en haalt hem niet op. Wat wel helpt: unieke data, een productspecialist, specifieke details en gebruiksgevallen, en bijgewerkte content. Een model knipt je pagina bovendien in stukjes (in zijn clip ongeveer 100 woorden) en gebruikt je koppen als snijlijn. Lange lappen tekst en koppen die van H1 naar H4 springen kosten je. Zie Zo leest een LLM jouw website.
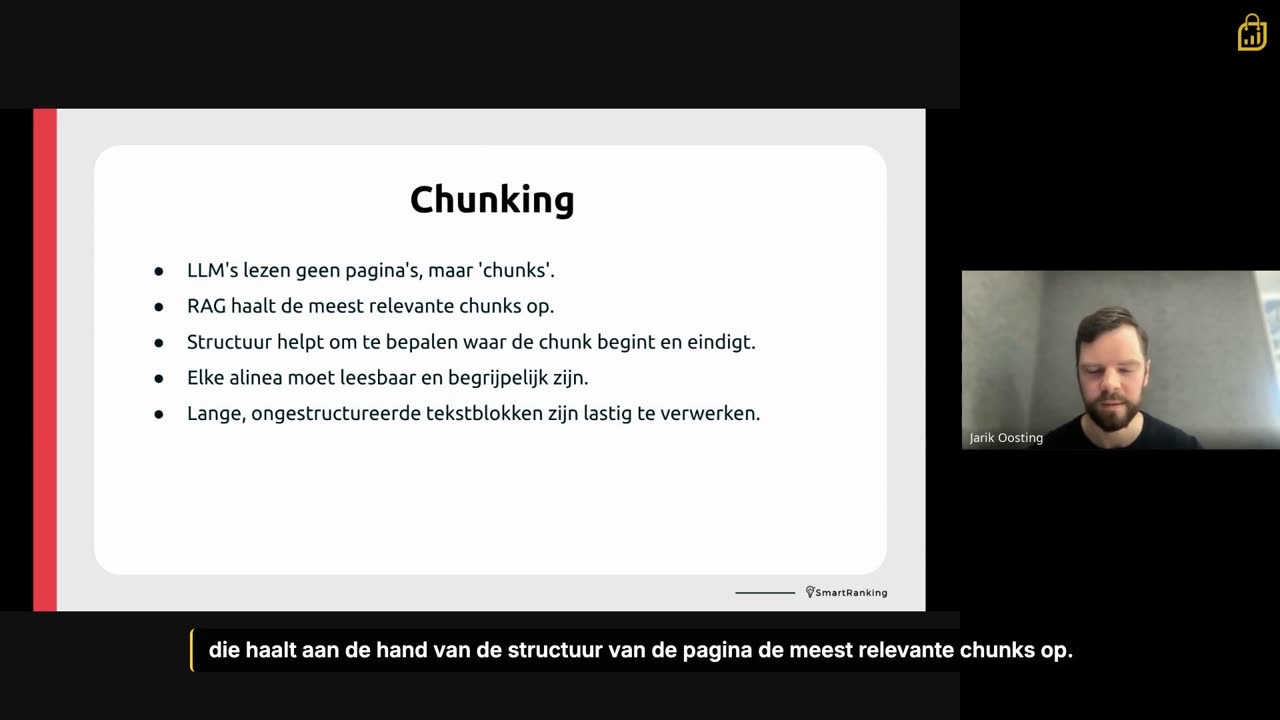
Slide van Jarik Oosting (Smart Ranking). Voor je productpagina's betekent dit: korte alinea's per onderwerp (maat, materiaal, verzorging) in plaats van één blok tekst.
Bron: eCommerce AI Club, clip 'Zo leest een LLM jouw website', gezien 2026-11-02
Uit onze sessies: bekijk de video
Risicoklassen in je voorbeeldwinkel
Het meeste geld gaat verloren in uniforme review: evenveel tijd voor een product met 3 bezoeken per maand als voor je bestseller. Deel daarom in klassen in. De aantallen hieronder zijn aannames voor de basiswinkel van 5.000 SKU's.
| Klasse | Wat valt eronder | Aantal | AI-rol | Controle | Tijd per stuk |
|---|---|---|---|---|---|
| A | Top 5% bestsellers, categoriepagina's, merk- en gidspagina's | 250 | Concept en structuur | Volledige expertreview, eigen feit verplicht | 15 min |
| B | Middensegment met omzet | 1.000 | Concept uit feed plus merkgids | Review op feiten en toon | 5 min |
| C | Lange staart, bijna geen verkeer | 3.750 | Sjabloon uit feedvelden, geen vrije tekst | Steekproef 10% (375 stuks) | 5 min per gecontroleerd stuk |
| D | Mails (Klaviyo, Spotler), advertenties, Zendesk-macro's | Per campagne | Varianten maken | Mens kiest en bewerkt, nooit automatisch verzenden | Per campagne vastleggen |
Bij klasse C is het slop-gevaar het grootst en de waarde het laagst. Toon daar liever alleen feitelijke attributen uit je PIM dan 3.750 teksten die allemaal 'hoogwaardige kwaliteit en stijlvol design' beloven. Op bol.com komt daar een eigen risico bij. De bol-pagina voor leveranciers over AI gaat alleen over boeken: AI-gegenereerde boeken moet je in de productinformatie aangeven, ook na substantiële bewerking (bol Leveranciersplatform). Voor andere categorieën vonden we geen officiële AI-regel. Wel meldt dienstverlener PlatformProfessionals (zonder datum op de pagina) dat bol kijkt naar de content die online staat, niet naar het gereedschap, en noemt het voorbeeld dat 'waterafstotend' door AI kan veranderen in '100% waterdicht', een harde claim (bulletin).
Rekenen: wat review kost en wat er op het spel staat
De rekensom voor de 5.000 teksten, met een aangenomen uurtarief van 45 euro.
| Scenario | Berekening | Uren | Kosten bij 45 euro per uur |
|---|---|---|---|
| Alles ongezien publiceren | 0 minuten | 0 | 0 euro, het risico is volledig voor jou |
| Iedereen 5 minuten review | 5.000 maal 5 = 25.000 minuten | 416,7 | 18.750 euro |
| Alles herschrijven door een expert | 5.000 maal 10 = 50.000 minuten | 833,3 | 37.500 euro |
| Gelaagd (A/B/C) | 250 maal 15 + 1.000 maal 5 + 375 maal 5 = 3.750 + 5.000 + 1.875 = 10.625 minuten | 177,1 | ongeveer 7.969 euro |
De gelaagde aanpak kost 7.969 tegen 18.750 euro: een besparing van 10.781 euro (57%). Neem aan dat 20% van de omzet uit organisch zoeken komt: 520.000 euro (20% van 2,6 miljoen). Bij een contributiemarge van 30% (aanname) kost 10% organisch verlies 52.000 euro omzet en 15.600 euro marge. Dat is bijna twee keer de reviewkosten (15.600 gedeeld door 7.969 is 1,96). Daar komt de klantenservice bij. Als 8% van de orders (3.200 contacten) een productvraag oplevert en een contact 4 euro kost (aanname), is dat 12.800 euro. Cost per contact is service-uren maal uurtarief gedeeld door het aantal contacten.
Stap voor stap: het productieproces
- Leg je merkgids vast in één bestand (prompt hieronder): toon, verboden woorden, doelgroep, drie klantvragen per productgroep, belofteregels.
- Bepaal per contentsoort de klasse (A tot D) en welk percentage je controleert.
- Genereer concepten uit PIM-velden en merkgids, nooit uit alleen een productnaam. Exporteer de velden uit Akeneo of je shop als bron.
- Laat een tweede prompt het concept toetsen op beweringen die niet in de feed staan (reviewprompt).
- De reviewer controleert feiten, voegt het eigen feit toe en tekent af met naam en datum.
- Controleer titel, metabeschrijving, structured data, alt-teksten en de Merchant Center-velden `structured_title` en `structured_description`.
- Publiceer in batches van maximaal 25 pagina's per week en volg indexering en klikken.
- Schrijf in het logboek op wat er is gewijzigd en waarom.
Je bent redacteur van [webshopnaam]. Lees de merkgids hieronder en pas die toe op elke tekst.

DOELGROEP: [bijv. mensen die hun tuin inrichten, 35 tot 60 jaar]
TOON: [3 woorden, bijv. nuchter, behulpzaam, concreet]
VERBODEN WOORDEN: hoogwaardig, stijlvol, ultiem, perfect, revolutionair, 'in de wereld van'
VERPLICHT PER TEKST: minstens één concreet feit uit de feed (maat, gewicht, materiaal, levertijd) en één situatie uit klantvragen.
REGELS: verzin geen eigenschappen. Staat iets niet in de feed, schrijf 'ONBEKEND: [veld]' in plaats van te raden. Gebruik merk- en collectienamen alleen zoals ze in de woordenlijst staan.
WOORDENLIJST MERKNAMEN: [naam = wat het is]
KLANTVRAGEN BIJ DEZE PRODUCTGROEP: [vraag 1] / [vraag 2] / [vraag 3]

FEED VOOR DIT PRODUCT:
[plak hier de PIM-velden]
Hieronder staan een concept-tekst en de feedgegevens van het product. Doe drie dingen.
1. Geef een lijst van elke bewering in de tekst die NIET letterlijk of rekenkundig volgt uit de feed. Citeer de zin. Let extra op versterkingen (bijvoorbeeld 'waterafstotend' wordt 'waterdicht').
2. Geef aan welke zinnen ook op een willekeurig ander product uit deze categorie zouden passen.
3. Stel twee vragen die een klant zou stellen en die de tekst niet beantwoordt.
Geef geen herschreven tekst. Geef alleen de drie lijsten.

TEKST:
[concept]

FEED:
[feedvelden]
Het merklogboek: context tegen het gemiddelde
Slop ontstaat als het model niets van je merk weet en daarom het gemiddelde produceert. In onze Champion-sessie van februari 2026 vertelde Jop van Hooft dat hij geen werk meer doet zonder AI ernaast, die ook meekijkt hoe hij tot een antwoord komt. Na elke klus zegt hij: zet het in het logboek. Het logboek hangt aan GitHub, dus alles staat in een Git-structuur en de AI weet wat er in de organisatie speelt. In de maandelijkse sessie van maart 2026 gaf hij het voordeel: bij een vervolgvraag op een mail van 1 februari wist zijn AI nog precies wat er was gedaan, terwijl hij het zelf was vergeten. Zijn motto: context is king. Zie de clip AI Logbook.
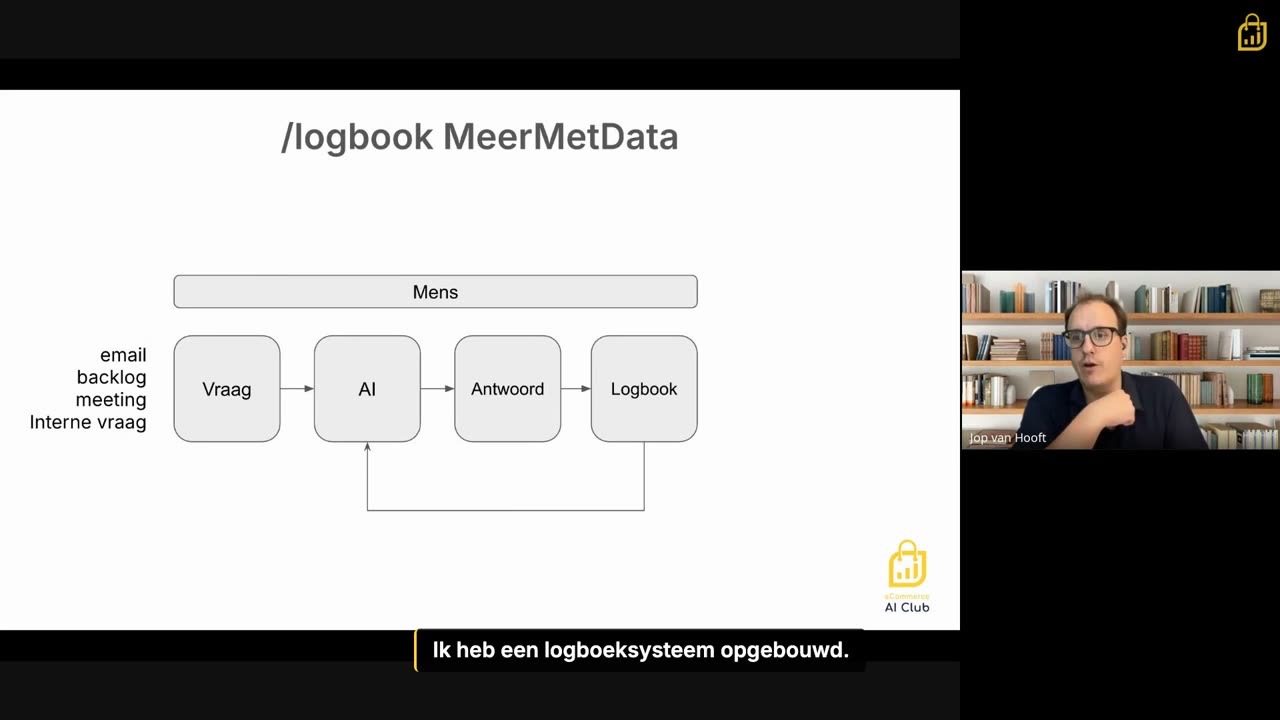
Het logboek-schema uit de Champion-sessie van februari 2026: vraag, AI, antwoord, logboek, en het logboek voedt de volgende vraag. Jij vult dat voor je webshop met merkgids, klantvragen en eigen feiten.
Bron: eCommerce AI Club, clip 'AI Logbook: kennis vastleggen als concurrentievoordeel', gezien 2026-11-02
Uit onze sessies: bekijk de video
Een map met tekstbestanden is genoeg:
- merkgids.md: toon, doelgroep, verboden woorden, woordenlijst merknamen
- klantvragen.md: per productgroep de vragen uit Zendesk, chat en reviews, met datum
- feiten.md: data die het model niet kent (retourpercentage per maat, levertijden per leverancier, testresultaten)
- besluiten.md: per datum wat je wijzigde, waarom en wie het goedkeurde
- fouten.md: wat misging en welke regel dat opleverde
Kiezen: vier werkwijzen vergeleken
| Werkwijze | Bewijs | Tijd per tekst | Kies dit als |
|---|---|---|---|
| Bulk-AI zonder review | SE Ranking: 28% in top 100 in maand 2 en 3, daarna 3%. Google noemt het als voorbeeld van scaled content abuse. | Bijna 0 | Nooit voor pagina's die moeten ranken. |
| AI uit feed plus steekproef | Past bij klasse C en bij Azerty's aanpak (feeddata als bron). De steekproef van 10% is een eigen keuze, geen bron. | 5 min bij 10% van de teksten | Lange staart met een goede PIM. |
| AI-concept plus expertreview | Digital Applied: AI-ondersteunde pagina's 3,9 backlinks tegen 4,2 menselijk en 1,6 puur AI. | 5 tot 15 min | Klasse A en B. |
| Volledig menselijk | Semrush: positie 1 is 8 keer vaker menselijk geschreven. | Meer dan 15 min (eigen inschatting) | Merkverhaal, testrapport, advies. |
Meten: KPI's en een test die bij je verkeer past
| KPI | Formule en bron | Goed | Slecht |
|---|---|---|---|
| Indexering van de batch | Geïndexeerde pagina's gedeeld door gepubliceerde pagina's, Search Console | Meer dan 90% binnen 4 weken (eigen drempel) | Nieuwe pagina's blijven achter, zoals bij EarthMed |
| Feed approval rate | Goedgekeurde items gedeeld door ingediende items, Merchant Center | Gelijk aan vóór de batch | Afkeuringen op titel of beschrijving na een AI-batch |
| Conversie | Orders gedeeld door sessies: 40.000 gedeeld door 2.000.000 = 2% | Gelijk of beter dan controlegroep | Lager dan controlegroep |
| Retourpercentage | Geretourneerde orders gedeeld door orders: 12% van 40.000 = 4.800 | Gelijk of lager | Hoger: beloftes die het product niet waarmaakt |
| Contactratio | Productvragen gedeeld door orders: 3.200 gedeeld door 40.000 = 8% | Daalt | Stijgt na een batch |
Een A/B-test op productpagina's past niet bij de meeste shops. Vuistregel: n = 16 maal p maal (1 min p) gedeeld door het verschil in het kwadraat. Bij 2% conversie en een verwacht verschil van 0,4 procentpunt is dat 0,3136 gedeeld door 0,000016, ofwel 19.600 sessies per variant. De basiswinkel heeft 2 miljoen sessies per jaar, dus ongeveer 166.700 per maand over 5.000 SKU's. Een groep van 20 producten krijgt gemiddeld 667 sessies per maand (20 gedeeld door 5.000 maal 166.700). Dat is bijna 30 maanden voor één test. Gebruik daarom deze opzet.
- Kies 40 vergelijkbare producten. Wijs er 20 toe aan de nieuwe werkwijze en 20 aan de huidige (controlegroep). Verdeel op omzet.
- Publiceer de testgroep in één batch en noteer de datum.
- Meet wekelijks 12 weken: indexering, klikken, vertoningen, feed-afkeuringen. Conversie bekijk je alleen als richting. Herhaal de meting na 6 en 12 maanden, want Digital Applied zag de kloof pas groeien.
- Succes: batch na 4 weken voor meer dan 90% geïndexeerd en klikken niet lager dan de controlegroep. Falen: één van beide blijft achter. Draai dan de batch terug en pas de toetsen aan.
Organisatie: wie doet wat
- Eén eigenaar per contentsoort: productteksten (vaak de e-commerce manager of contentspecialist), mails (CRM), advertenties (performance). 3 namen, 3 rollen.
- Poort per klasse: A en B afgetekende feitencontrole, C steekproef, D handmatige verzending uit Klaviyo of Spotler.
- Log: datum, contentsoort, prompt en modelversie, bron van de feiten, reviewer, wijziging. Zo achterhaal je na een core update welke batch het probleem veroorzaakte.
- Elk kwartaal: lees tien willekeurige teksten achter elkaar. Kun je ze niet uit elkaar houden, dan is dat je slop-index.
Risico's en regels
| Gebied | Wat geldt | Bron en status |
|---|---|---|
| Google Search | Scaled content abuse en factcheckplicht, zie hierboven. | Google Search Central, gelezen 2 november 2026 |
| Google Merchant Center | AI-titels en -beschrijvingen via `structured_title` en `structured_description` met `digital_source_type` `trained_algorithmic_media`. IPTC-tag op AI-afbeeldingen behouden. | Merchant Center-hulppagina 14743464, volledig gelezen 2 november 2026 |
| bol.com | Officiële AI-regel alleen voor boeken (aangeven in productinformatie). Voor andere categorieën geen officiële regel gevonden. | bol Leveranciersplatform, gelezen 2 november 2026 |
| EU AI Act, artikel 50 | Wie AI-tekst publiceert 'ter informatie van het publiek over zaken van openbaar belang' moet dat vermelden, tenzij er menselijke review en redactionele verantwoordelijkheid is. Gewone productteksten vallen er waarschijnlijk niet onder, een chatbot en realistische AI-beelden mogelijk wel. | artificialintelligenceact.eu; toepassingsdatum 2 augustus 2026 en reikwijdte laten toetsen door een jurist |
| AVG | Plak geen klantgegevens (Zendesk-tickets, orderdata) in een publieke AI-tool en regel een verwerkersovereenkomst. | Door een jurist te toetsen |
Het merkrisico telt zwaarder dan het juridische. In een interne werksessie in oktober 2026 hoorden we over AI-video's voor klanten: wij zien dat het slop is, maar veel mensen zien het niet. Dat voordeel is tijdelijk.
Wat we leerden
- Pilots van weken bewijzen weinig: Azerty meldt geen meetperiode, EarthMed viel pas na maanden. Plan metingen op 6, 12 en 26 weken.
- In maart 2026 noemde Jop de mythe 'AI maakt generieke rommel' deels waar. Zijn reparatie: de juiste tools, prompting en een creatieve aanpak, en AI laten versterken in plaats van AI aan het stuur te zetten.
- In een interne werksessie van oktober 2026 kwam AI-moeheid ter sprake: mensen worden moe van nieuwe modellen en van slop. Reden om minder, scherper en eigener te publiceren.
30 dagen: van inventarisatie tot eerste batch
| Week | Doel | Concreet |
|---|---|---|
| 1 | Inventariseren | Exporteer alle AI-teksten van de laatste 12 maanden uit je shop en PIM. Haal per pagina klikken uit Search Console. Deel de 5.000 SKU's in klasse A tot D in. Kies één eigenaar en één reviewer. |
| 2 | Merkgids en logboek | Schrijf merkgids.md (met woordenlijst merknamen), klantvragen.md (3 per productgroep) en feiten.md (5 eigen feiten). Test beide prompts op 10 producten. |
| 3 | Pilot | Kies 40 vergelijkbare producten, maak 20 nieuwe teksten volgens het proces, laat 20 ongemoeid. Noteer de startdatum. Controleer titel, metabeschrijving, alt en de Merchant Center-velden. |
| 4 | Meten en besluit | Controleer indexering en feed-afkeuringen van de 20 pagina's. Publiceer maximaal 25 pagina's per week. Leg in besluiten.md vast wat blijft. Plan meetmomenten na 6, 12 en 26 weken. |
Heb je al honderden AI-teksten live staan, begin dan met klasse A: herschrijf de pagina's met omzet en kijk of indexering en klikken verbeteren, voordat je iets verwijdert. EarthMed verwijderde alles en herstel is nog niet aangetoond.
Bronnen en wat we niet konden vaststellen
We konden 3 dingen niet bij de bron bevestigen: de studies van Semrush, Digital Applied, SE Ranking en Rankability (alleen het Frankwatching-overzicht), de Azerty-cijfers (alleen via Thuiswinkel.org, niet herberekend) en een officiële bol.com-regel voor AI-productteksten buiten boeken. De EU AI Act-reikwijdte is juridisch niet getoetst. Gegevens uit je eigen shop wegen zwaarder dan al deze studies.
Veelgestelde vragen
Straft Google AI-content?
Google straft niet het gebruik van AI, maar wel content die in grote aantallen is gemaakt om te ranken zonder waarde voor gebruikers (scaled content abuse). Overtreders kunnen lager ranken of helemaal uit de resultaten verdwijnen, aldus Google Search Central (2 november 2026).
Is AI-content slecht voor SEO?
Niet automatisch. Ahrefs vond bij 600.000 pagina's een correlatie van 0,011 tussen AI-aandeel en positie. Maar in een 16 maanden durende studie van SE Ranking viel het aandeel pagina's in de top 100 van 28% naar 3%, en puur AI rankt volgens Digital Applied gemiddeld 23% lager (beide via Frankwatching, juli 2026).
Hoeveel AI-content is veilig?
Er is geen veilig percentage. Zoals inspace.io schrijft, is er geen magisch getal. Wat telt is of elke pagina een eigen feit bevat, is nagekeken door een benoemd mens en een reden heeft om te bestaan.
Hoe herken ik AI-slop in mijn eigen shop?
Neem tien teksten, haal de productnaam weg en kijk of je ze nog uit elkaar kunt houden. Gebruik daarna de reviewprompt uit dit artikel om beweringen zonder bron te vinden. AI-detectors zijn onbetrouwbaar: Ahrefs noemt ze kansberekeningen met fout-positieven.
Moet ik AI-content labelen?
Voor gewone commerciële teksten met menselijke review meestal niet; artikel 50 van de EU AI Act gaat over AI-tekst ter informatie van het publiek over zaken van openbaar belang, realistische deepfakes en chatbots. Voor AI-titels en -beschrijvingen in Google Merchant Center gelden wel aparte velden (structured_title en structured_description, bron: Google). Bij boeken op bol.com moet je AI-gegenereerde inhoud aangeven. Laat de rest toetsen door een jurist.
Wat moet ik doen met AI-teksten die al live staan?
Deel ze in risicoklassen in, begin met klasse A en meet indexering en klikken per batch. Verwijder pas na meting. Het EarthMed-voorbeeld (JumpFly, oktober 2026) laat zien dat verwijderen niet automatisch herstel geeft.
Werkte AI voor productteksten ook voor een Nederlandse webshop?
Azerty.nl meldde na een pilot met ChatGPT 3.5 op 115 producten gemiddeld 1,05 plek hogere posities en 185% meer verkopen op die pagina's (Thuiswinkel.org, 22 januari 2025). Er is geen meetperiode of controlegroep genoemd, en Azerty zelf zegt dat de eerste-mover-positie meespeelde. Meet dus zelf over meerdere maanden.
Bronnen
Onze sessies
- eCommerce AI-Club: Maandelijkse Meeting, 2026-03-12
- Interne werksessie, 2026-10-20
- Interne werksessie, 2026-10-06
- Interne werksessie, 2026-09-22
Openbare bronnen
- developers.google.com/search/docs/essentials/spam-policies (gecontroleerd 2026-11-02)
- developers.google.com/search/docs/fundamentals/using-gen-ai-content (gecontroleerd 2026-11-02)
- developers.google.com/search/docs/fundamentals/creating-helpful-content (gecontroleerd 2026-11-02)
- searchenginejournal.com/google-has-deployed-a-new-ai-spam-detector-called-safe/590918/ (gecontroleerd 2026-11-02)
- jumpfly.com/blog/a-cautionary-tale-one-sites-ai-assisted-seo-crash/ (gecontroleerd 2026-11-02)
- frankwatching.com/archive/2026/07/28/seo-ai-content-zoekmachines-onderzoeken/ (gecontroleerd 2026-11-02)
- ahrefs.com/blog/ai-generated-content-does-not-hurt-your-google-rankings/ (gecontroleerd 2026-11-02)
- en.wikipedia.org/wiki/AI_slop (gecontroleerd 2026-11-02)
- artificialintelligenceact.eu/article/50/ (gecontroleerd 2026-11-02)
- thuiswinkel.org/nieuws/slimme-seo-met-generatieve-ai-bij-retailers/ (gecontroleerd 2026-11-02)
- emerce.nl/wire/handmatige-test-20-nederlandse-retailers-zien-hoe-onvolledige-productdata-producten-onvindbaar-maakt-ai-marketplaces-google-shopping (gecontroleerd 2026-11-02)
- leveranciers.bol.com/nl/hulp-nodig/assortimentsbeleid/boeken/ (gecontroleerd 2026-11-02)
- platformprofessionals.nl/bulletin/ai-content-chatgpt-claude-bol-beleid-cases/ (gecontroleerd 2026-11-02)
- support.google.com/merchants/answer/14743464 (gecontroleerd 2026-11-02)
Over deze gids
Geschreven door de redactie van de eCommerce AI Club, gepubliceerd op . De gids steunt op 4 sessies van de club en 14 openbare bronnen, voor het laatst gecontroleerd op . Ze staan onder Bronnen. Elke ochtend zetten we het AI-nieuws voor webshops online, en in de cases staat wat Nederlandse en Belgische webshops en winkels met AI deden. Zie je een fout, mail dan [email protected].
De nieuwsbrief, elke woensdag
Om 08:00 krijg je de beste berichten van de week, met een case en een gids.