Techniek voor AI-zichtbaarheid: retrievaltijd en rendering
Jarik Oosting, SmartRanking
Uit de sessie: Specialists: LLM Ready Website
Jarik Oosting van SmartRanking noemt de techniek het fundament van zichtbaarheid in taalmodellen. In deze clip uit de Specialists-sessie over de LLM-ready website legt hij uit waarom de tijd die een model krijgt om je pagina op te halen telt, en waarom JavaScript een probleem kan zijn.
Voor wie: Je bent verantwoordelijk voor het platform of de templates van een webshop en wilt weten welke techniek AI-zichtbaarheid bepaalt.
Waarom dit ertoe doet
Een productpagina die prima rankt in Google kan leeg zijn voor ChatGPT. Googlebot voert JavaScript uit, de crawlers van OpenAI en Anthropic doen dat niet. Vercel mat in december 2024 dat GPTBot in een maand 569 miljoen verzoeken op zijn netwerk deed en Claude 370 miljoen, en dat geen van de grote AI-crawlers JavaScript rendert. Laadt je shop prijs, voorraad of productbeschrijving pas in de browser, dan mist het model die informatie. Jarik Oosting voegt daar een tweede punt aan toe: een model heeft weinig tijd om je pagina op te halen. Een trage server kost je dan een plek in het antwoord.
Belangrijkste inzichten
- Volgens Jarik Oosting heeft een taalmodel beperkte tijd om je pagina op te halen, om kosten en snelheid.
- Google noemt een LCP van 2,5 seconden of minder goed, gemeten op het 75e percentiel.
- Vercel mat in december 2024 569 miljoen verzoeken van GPTBot en 370 miljoen van Claude in een maand, zonder JavaScript-rendering.
- Render prijs, voorraad en productinformatie server-side; client-side rendering is prima voor extra's.
- Een AI-agent in browsermodus bekijkt je site wel zoals een bezoeker; een gewone vraag in ChatGPT of AI Mode niet.
Beperkte tijd voor retrieval
Als een taalmodel via RAG zoekt, haalt het pagina's op, knipt ze in stukken (chunks) en kiest de relevante stukken. Daar zit volgens Jarik Oosting een tijdslimiet op, om kosten en snelheid. Hij maakt een onderscheid: het gaat hem niet om laadsnelheid voor de gebruiker, maar om hoe snel een model de informatie op je pagina vindt. Als graadmeter noemt hij de Core Web Vitals, en dan vooral de Largest Contentful Paint (LCP). Google noemt een LCP van 2,5 seconden of minder goed, gemeten op het 75e percentiel van de paginaweergaven. Volgens Jarik zitten de meeste grote webshops goed, maar een hoge LCP is een signaal om op te letten.
Client-side rendering
Bij client-side rendering stuurt de server een bijna lege pagina en bouwt JavaScript in de browser de inhoud op. Googlebot rendert zo'n pagina zoals een bezoeker hem ziet. Een taalmodel dat via RAG ophaalt doet dat volgens Jarik niet. Het onderzoek van Vercel bevestigt dat voor de crawlers: ChatGPT en Claude halen JavaScript-bestanden op, maar voeren ze niet uit. Vercel adviseert daarom belangrijke content server-side te renderen en client-side rendering te bewaren voor extra's zoals een chatwidget. Jarik maakt één uitzondering: een AI-agent, zoals de agent-modus van ChatGPT, bekijkt je site wel in een browser.
Wat telt als cruciale content
Voor een webshop is dat de productnaam, prijs, voorraadstatus, levertijd, specificaties en reviews. Staat een van die velden alleen in een script dat na het laden data ophaalt, dan ziet een crawler zonder rendering hem niet. Moderne frameworks zoals Next.js, Nuxt of Hydrogen kunnen server-side of statisch renderen; vaak is het een instelling per template. Jarik heeft het lijstje met 'tientallen punten' bewust ingekort tot de belangrijkste, en zegt dat je hiervoor meestal een developer nodig hebt.
Feit en inschatting
Dat AI-crawlers geen JavaScript uitvoeren is gemeten door Vercel en MERJ. Dat er een vaste tijdslimiet voor retrieval is en dat LCP invloed heeft op selectie door een model, is de ervaring van Jarik. OpenAI en Google publiceren daar geen grenswaarden voor. Gebruik LCP dus als indicatie dat je server snel genoeg levert, niet als harde drempel.
Probeer dit deze week
- Open 3 productpagina's met JavaScript uitgeschakeld en noteer welke van prijs, voorraad en beschrijving verdwijnen.
- Bekijk in Search Console het Core Web Vitals-rapport en zoek de templates met een LCP boven 2,5 seconden.
- Vraag je developer per template of de productinformatie in de HTML van de server staat of pas na laden verschijnt.
Begrippen
- Retrieval
- Het ophalen van pagina's en stukken tekst door een taalmodel voordat het antwoordt.
- LCP
- Largest Contentful Paint: hoe snel het grootste element van een pagina zichtbaar is; goed is 2,5 seconden of minder.
- Client-side rendering
- De browser bouwt de pagina-inhoud op met JavaScript, nadat de server een bijna lege pagina stuurt.
- Server-side rendering
- De server levert de pagina met de inhoud al in de HTML.
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
Wat voor de techniek heel belangrijk komt te weten is dat een LLM beperkte tijd heeft voor de retrieval van die informatie. Dus als een LLM op het internet gaat zoeken via RAG, dan is daar beperkte tijd om informatie te chunken, om informatie terug te halen. Het heeft met kosten te maken, maar ook met snelheid. En vaak wordt gedacht dat laadsnaalheid ook voor LLMs belangrijk is, omdat het goed is voor de gebruikers. Maar dat is in principe niet zo. Met name de tijd dat het duurt voor retrieval. Dus hoe snel kan een LLM informatie op je website vinden. Dat is van impact of jij wel of niet zichtbaar wordt binnen een LLM. En voor die techniek en ook de toegang tot je platform zijn er een aantal zaken belangrijk. Ik kan wel een lijst maken van 100 punten, maar ik heb de belangrijkste punten hier gedestilleerd. De laatheid van je platform, dat heeft impact op het selecteren van fragmenten op basis van die chunks. Je kan heel simpel kijken naar de Core Web Vitals, dat is een hele goede indicatie of je platform wel of niet snel laat. Dat is eigenlijk de allermakkelijkste. Gezien de e-commerce platformen die hier zitten, zal dit doorgaans wel goed zijn. Maar mocht het niet zo zijn, mocht je echt een hele hoge LCP bijvoorbeeld zien, wees je daar wel bewust van, dat het impact kan hebben of jouw website, jouw e-commerce platform of merk, wel of niet geselecteerd wordt door een LLM. Dus vergeet niet dat dit echt wel een cruciaal onderdeel is, en eigenlijk het fundament van het zichtbaar worden binnen zo'n LLM. Het is ook belangrijk om beperkt gebruik te maken van client-site JavaScript rendering. Dus daar heb je echt cruciale content. zorgen voor dat die informatie via de server-site gerenderd wordt. Dat heeft ook met die chunking te maken en met die RAG te maken. Want via RAG, als een LLM RAG doet voor jouw platform, dan wordt de pagina niet gerenderd. Dus wat Google doet met Googlebot, de crawler, is dat Google de pagina bekijkt zoals een gebruiker dat bekijkt. Een LLM doet dat niet. Een AI-agent wel. Dus de ChatGPT-agent gaat jouw platform wel bekijken. Maar als je een vraag stelt in ChatGPT of AI mode, gebeurt dat niet. Dus beperk daarom client-side rendering als dat mogelijk is.
Spreker: Jarik Oosting, SmartRanking
Bronnen
Meer over Productdata & Feeds
 Duur 1:39
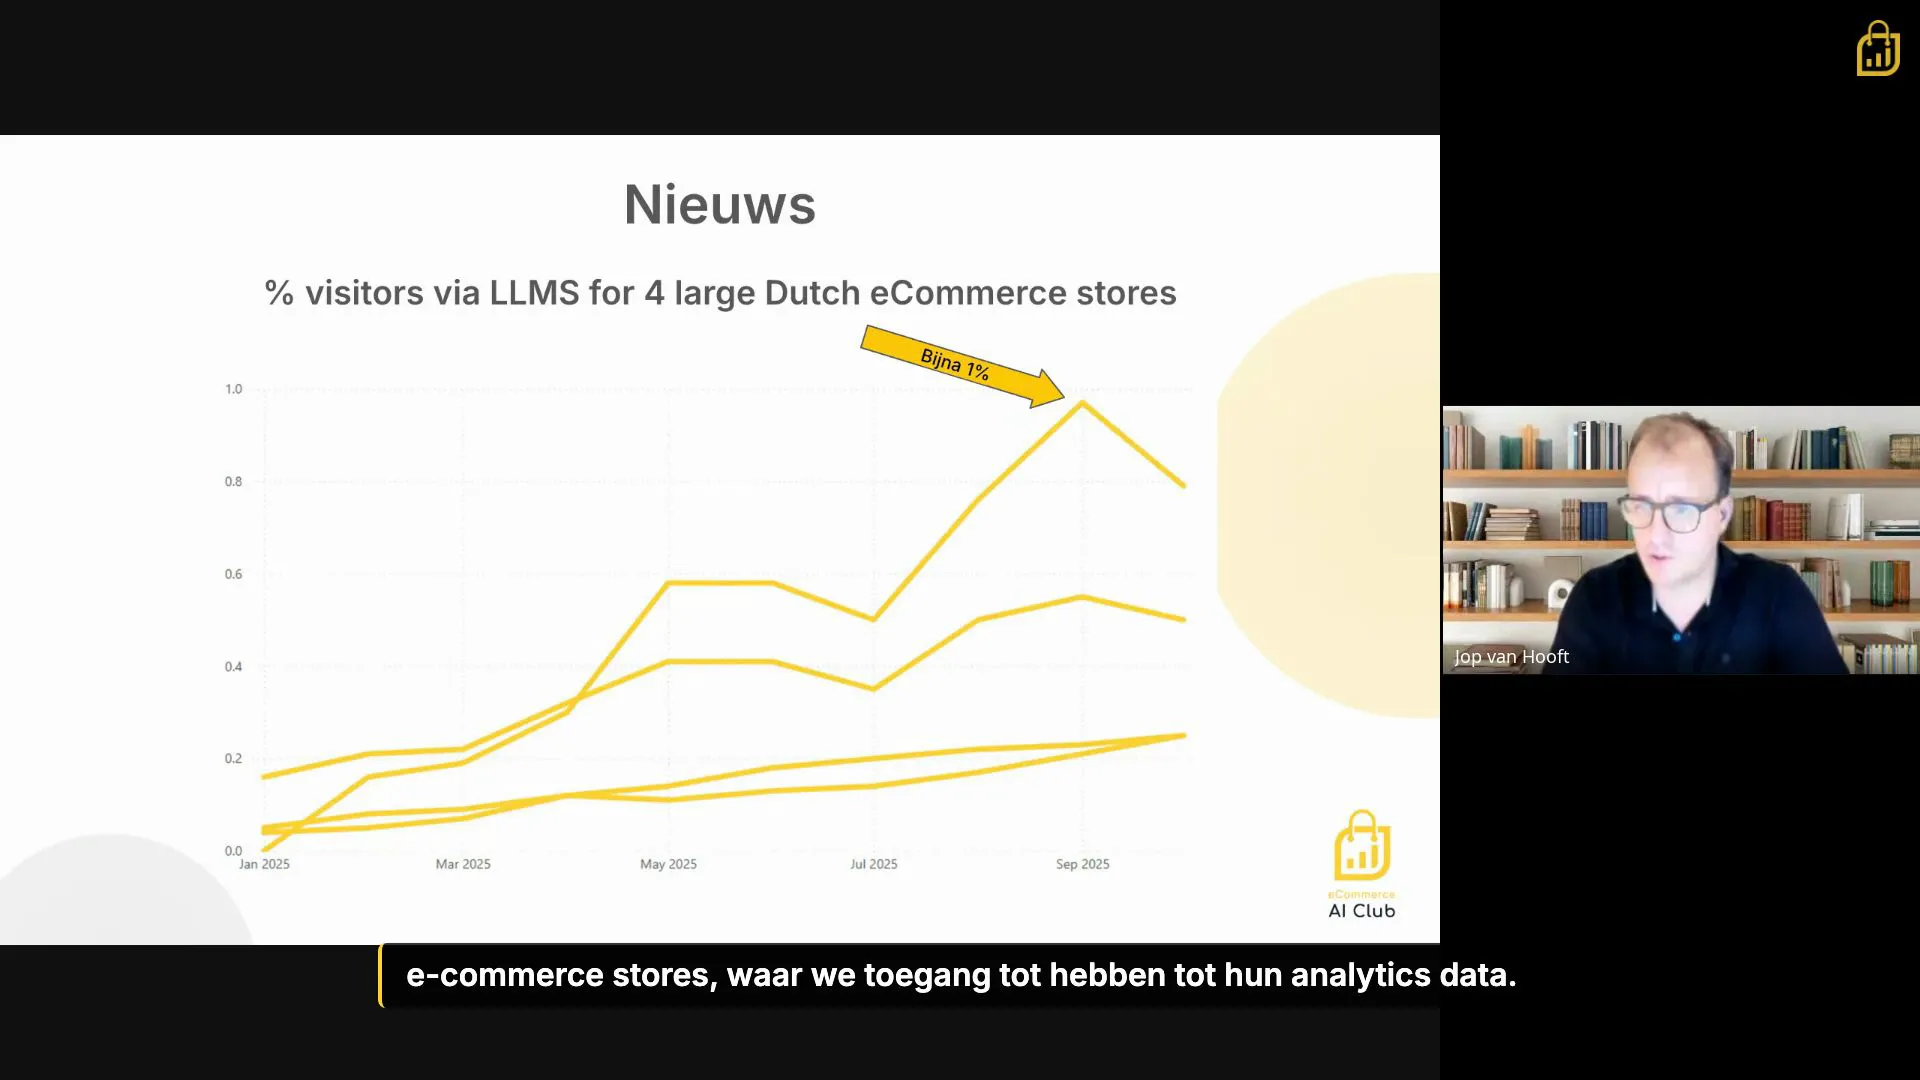
Hoeveel verkeer komt via LLMs bij Nederlandse webshops?
Jop van Hooft, eCommerce AI Club
Slechts 1% van je websiteverkeer komt via LLMs, maar het groeit exponentieel
 Duur 0:40
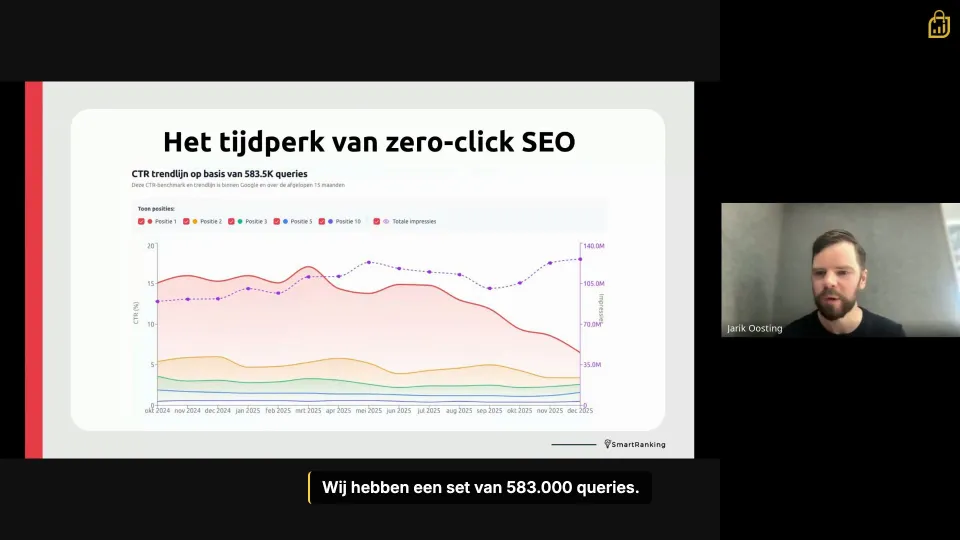
Zero-Click SEO
Jarik Oosting, Smart Ranking
De CTR voor positie 1 in Google is met meer dan de helft gedaald
 Duur 0:41
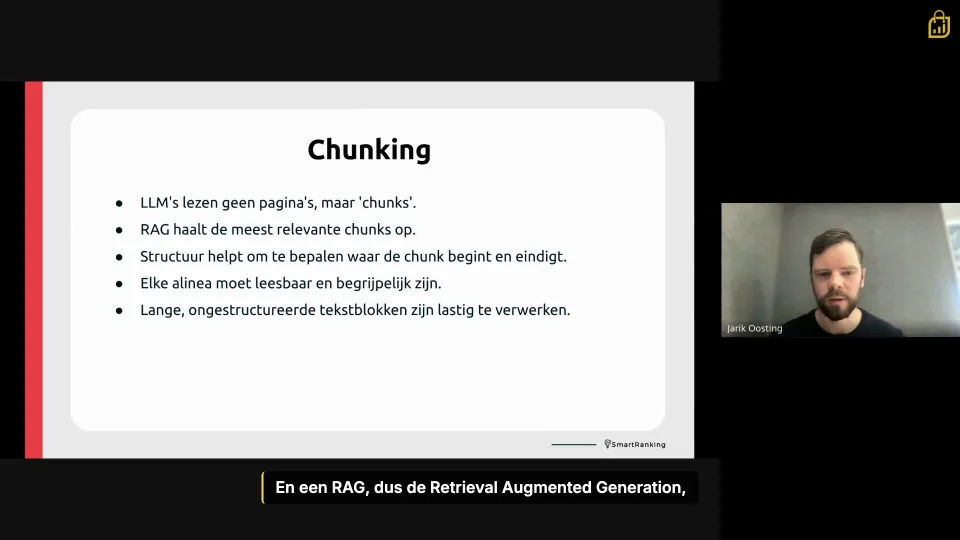
Zo leest een LLM jouw website
Jarik Oosting, Smart Ranking
Een LLM leest niet je hele pagina, alleen de relevante chunks