Structured data en je feed, niet llms.txt
Jarik Oosting, SmartRanking
Uit de sessie: Specialists: LLM Ready Website
Jarik Oosting van SmartRanking loopt in de Specialists-sessie over de LLM-ready website de technische punten langs die wel en niet helpen in AI-antwoorden. Je hoort waarom structured data en een complete shoppingfeed tellen, waarom hij llms.txt nu overslaat en welke fout hij op productpagina's tegenkwam.
Voor wie: Je moet kiezen waar je developer-uren in steekt om producten in AI-antwoorden te krijgen.
Waarom dit ertoe doet
Tijd van developers is schaars, dus de vraag is waar je die in steekt. Jarik Oosting is duidelijk: niet in een llms.txt-bestand, wel in product structured data en Merchant Center. Google schrijft zelf dat je voor AI Overviews en AI Mode geen nieuwe machineleesbare bestanden, AI-tekstbestanden of speciale markup nodig hebt. Tegelijk raadt AI Mode in de VS producten aan met data uit de feed. Een productpagina met twee concurrerende Product-blokken of een feed met ontbrekende GTIN's werkt dan tegen je. Jarik zag die dubbele blokken bij webshops van deelnemers aan de sessie. Het is een fout die je met één templatewijziging oplost.
Belangrijkste inzichten
- Structured data maakt volgens Jarik Oosting niets of breekt niets, maar helpt een taalmodel je pagina te begrijpen.
- Gebruik één Product-blok per pagina; Google vereist een naam en minstens één van review, aggregateRating of offers.
- Een complete Merchant Center-feed is volgens Jarik de basis voor productaanbevelingen in AI Mode.
- llms.txt is een voorstel van 3 september 2024; Google zegt dat je voor AI-functies geen AI-tekstbestanden nodig hebt.
- Controleer je markup met de Rich Results Test en zorg dat hij klopt met de zichtbare tekst.
Structured data helpt een model begrijpen
Structured data is code (meestal JSON-LD volgens schema.org) die vertelt wat er op een pagina staat: dit is een product, dit is de prijs, dit is de voorraad. In de SEO-wereld is het een discussiepunt of taalmodellen er iets mee doen, omdat ze tekst in tokens omzetten. Jarik Oosting zegt dat het wel helpt: het maakt of breekt niets, maar het model begrijpt je pagina beter. Google zegt dat er geen speciale schema.org-markup nodig is voor AI-functies, en dat je structured data moet kloppen met de zichtbare tekst.
Eén Product-blok, zo volledig mogelijk
Op een productpagina van een deelnemer zag Jarik twee Product-elementen. Dat is verwarrend voor een model, en ook voor de gratis Shopping-vermeldingen in Google. Zijn advies: één Product-fragment met alle informatie. Hij noemt 8 soorten gegevens: prijs, verzendsnelheid, reviews, voorraadstatus, merk, SKU of GTIN, beschrijving en afbeeldingen. Google vereist voor een product-snippet een naam en minstens één van review, aggregateRating of offers, met een prijs in de offer. Beschikbaarheid, valuta en geldigheid van de prijs zijn aanbevolen. Controleer het resultaat met de Rich Results Test van Google.
De shoppingfeed als bron voor AI Mode
Naast structured data noemt Jarik een complete shoppingfeed. In de VS ziet hij AI Mode steeds vaker producten aanraden, met doorvragen, en een deel van die informatie komt volgens hem uit Merchant Center. Hoe completer je feed, hoe beter je klaarstaat als Google in Nederland ook producten gaat aanraden in de AI-modus, die sinds 8 oktober 2025 in het Nederlands werkt. Denk aan titels, GTIN's, attributen als kleur en maat, verzendkosten en levertijd.
Waarom llms.txt nu weinig oplevert
llms.txt is een voorstel van Jeremy Howard van 3 september 2024: een markdown-bestand in de root van je site dat AI-agents naar beknopte, leesbare versies van je content wijst. Jarik raadt aan er nu geen tijd in te steken. Volgens hem ondersteunen Google en OpenAI het niet, en gebruiken alleen Claude en Perplexity het, waarbij Perplexity klein is. Op zijn slide staat het onder 'minder belangrijk'. Google bevestigt dat je geen AI-tekstbestanden nodig hebt. Dat Claude en Perplexity het lezen, hebben we niet bij een primaire bron kunnen controleren. Het voorstel zelf richt zich vooral op softwaredocumentatie.
Probeer dit deze week
- Haal 5 productpagina's door de Rich Results Test en tel hoeveel Product-blokken elke pagina heeft.
- Exporteer je feed uit Merchant Center en noteer het percentage producten zonder GTIN of zonder levertijd.
- Staat llms.txt op je roadmap, verschuif die uren naar het samenvoegen en aanvullen van je product structured data.
Begrippen
- Structured data
- Code in een pagina, meestal JSON-LD, die zoekmachines vertelt wat er staat, zoals product, prijs en voorraad.
- llms.txt
- Voorgesteld markdown-bestand in de root van een site dat AI-agents naar beknopte content wijst.
- Rich Results Test
- Gratis tool van Google die controleert of je structured data geldig is.
- GTIN
- Wereldwijd productnummer zoals de EAN-barcode, waarmee Google een product herkent.
Verdiep je in de gids
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
Structured data, die heb ik net al een aantal keren voorbij horen komen, dat is heel goed, want dat helpt om content te begrijpen. Het is best wel een groot discussiepuntje, ook weer binnen de SEO-wereld of structured data wel of niet belangrijk is voor LLMs. Er wordt vaak gedacht dat dat niet zo is, omdat LLMs een methode gebruiken, dat heet tokenizen, het omzetten van content, dus die chunks in tokens, om sneller bepaalde dingen te kunnen vergelijken, even de hele korte technische uitleg. Maar dat is niet zo. Structured data is wel echt belangrijk. Dat heeft impact op of een LLM jouw platform wel of niet goed kan begrijpen. Het is niet hetgeen wat het maakt of breekt, maar het helpt wel. Het gebruik van een goede HTML-structuur is belangrijk. Ik heb er ook een paar voorbeelden van in de volgende slides. Toegankelijkheid voor AI-agents en een complete shopping feed. Nu mag ik hopen dat het laatste hier wel goed zit. Maar mocht er nog iets in je shoppingfeed, bijvoorbeeld in wat je in Merchant Center terugziet, niet goed zijn, besteed er wel aandacht aan. Want wat we dus zien in Amerika, is dat die AI-mode steeds vaker producten aanraadt, en dat je dat kan doorvragen, en dat de informatie die de AI-mode laat zien, voor een deel uit Merchant Center komt. Dus hoe compleet je Merchant Center, hoe betere basis je straks al legt om in AI-mode, als Google in Nederland of in Europa, ook producten gaat aanraden om daar ook zichtbaar te zijn. Wat minder belangrijk is en waar ik adviseer, en dit wil ik wel graag benadrukken, om er nu geen aandacht aan te besteden, dat is het llms.txt bestand. Die hoor ik heel vaak nog voorbij komen, maar dat wordt niet ondersteund door Google. Het wordt niet gebruikt en ondersteund door OpenAI. Het is iets wat Claude en Perplexity wel gebruiken, maar Perplexity is echt gigantisch klein. En ze lijken ook niet echt meer heel hard te gaan groeien. Dus ik zou hier geen aandacht aan besteden. Veel beter kun je dat dan leggen op bijvoorbeeld de HTML-structuur of structured data. Daar zou ik mijn tijd lekker in gaan steken. Met name voor jullie is de Product structured data een hele belangrijke. Ik heb een aantal verschillende webshops bekeken. Dus een aantal deelnemers van deze presentatie. En je ziet soms nog wat gekke dingen in de structured data voorbij komen. Dit is een voorbeeld waarbij er bijvoorbeeld twee product structured data elementen worden ingeladen. Dat is verwarmd. Voor een LLM is dat verwarmd, maar ook voor simpelweg bijvoorbeeld organic shopping binnen Google Search. Dus dat heeft niks met geo te maken, maar goed, het is wel mooi meegenomen. En zorg ervoor dat je één product structured data fragment gebruikt, met daarin alle informatie, en het liefst ook de aanbevolen informatie wat Google aangeeft. Dus dan heb je het over prijs, verzendsnelheid, reviews, voorwaartsstatus, merk, SKU of een GTIN, de productontschrijving, afbeeldingen, etc. Dit kun je checken via de Rich Result Test van Google, wellicht wel bekend bij de meeste van jullie. Maar mocht je dit soort dingen zien, het is goed om dit samen te voegen. en zoveel mogelijk informatie en zoveel mogelijk ondersteunende informatie, want er zijn echt tienduizenden verschillende stukjes data die je kan gebruiken, maar met name deze om dat aan te vullen.
Spreker: Jarik Oosting, SmartRanking
Bronnen
Meer over Productdata & Feeds
 Duur 1:39
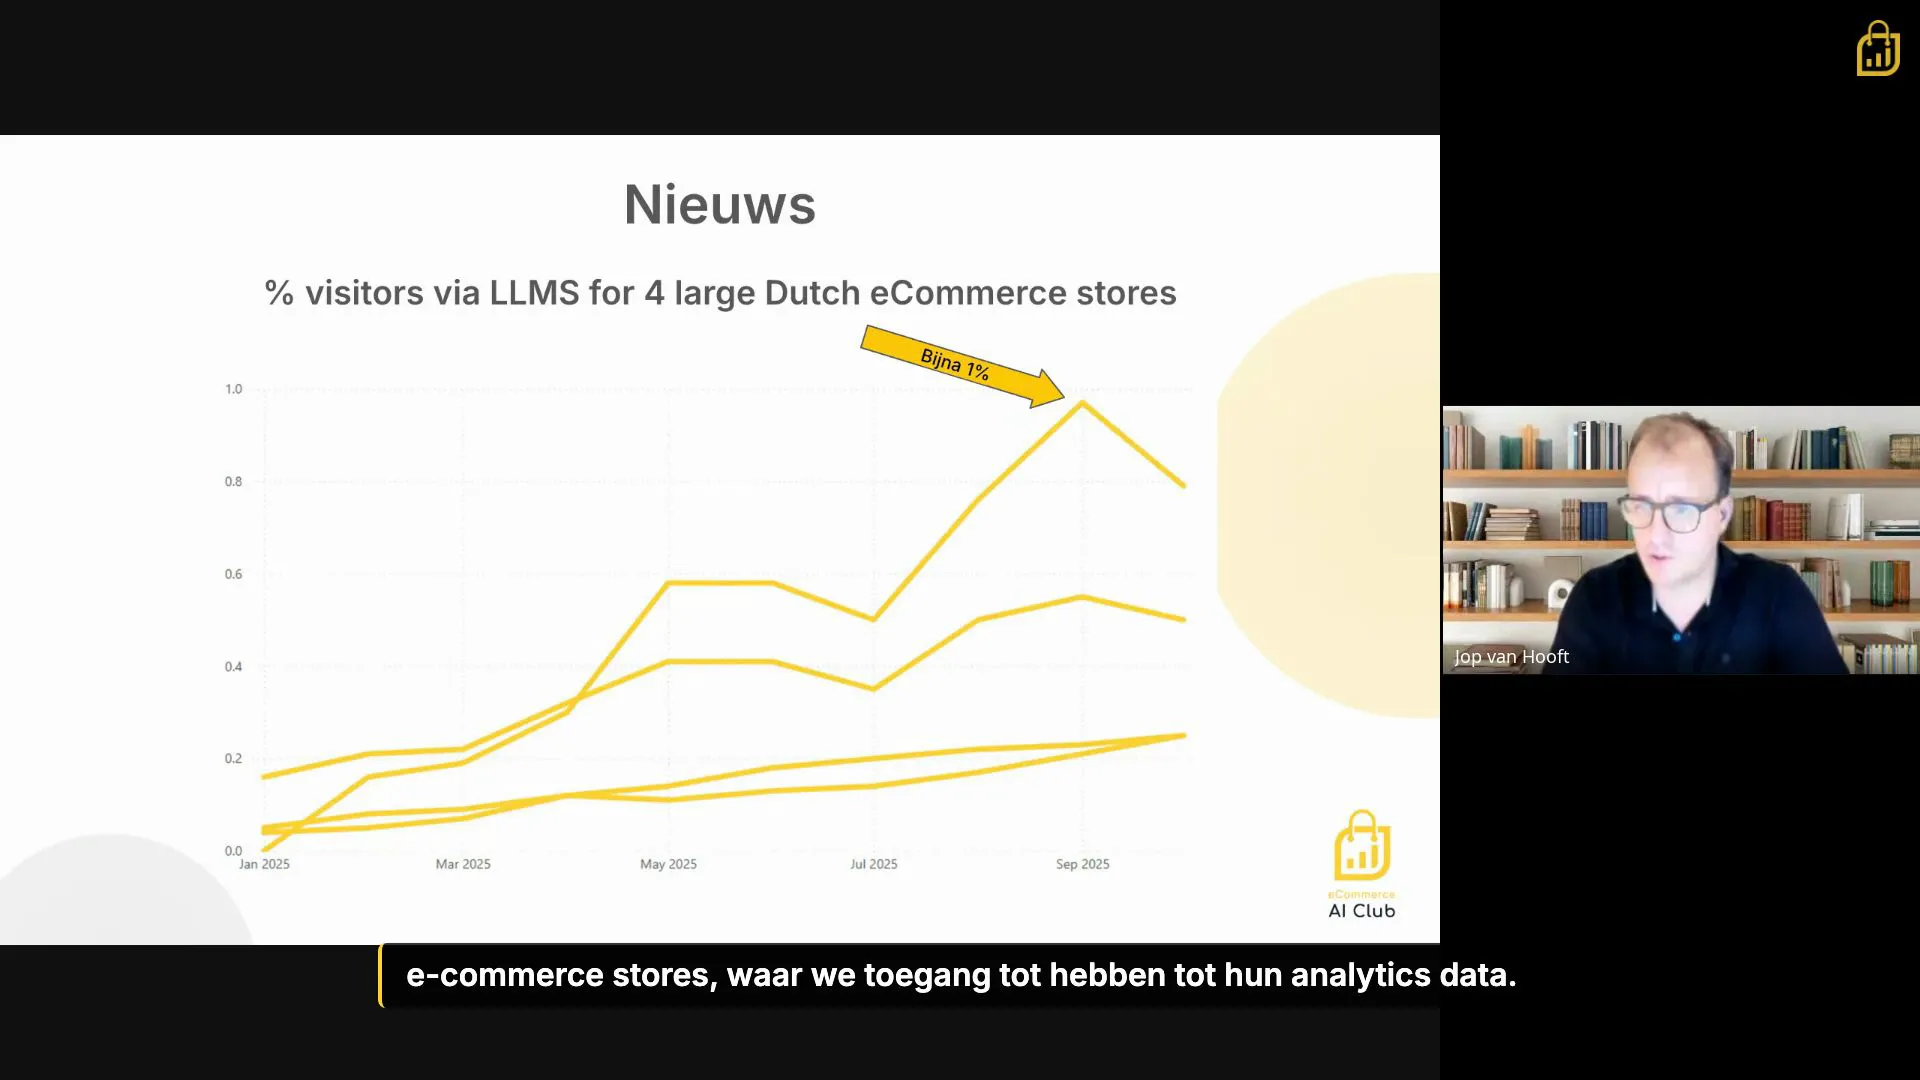
Hoeveel verkeer komt via LLMs bij Nederlandse webshops?
Jop van Hooft, eCommerce AI Club
Slechts 1% van je websiteverkeer komt via LLMs, maar het groeit exponentieel
 Duur 0:40
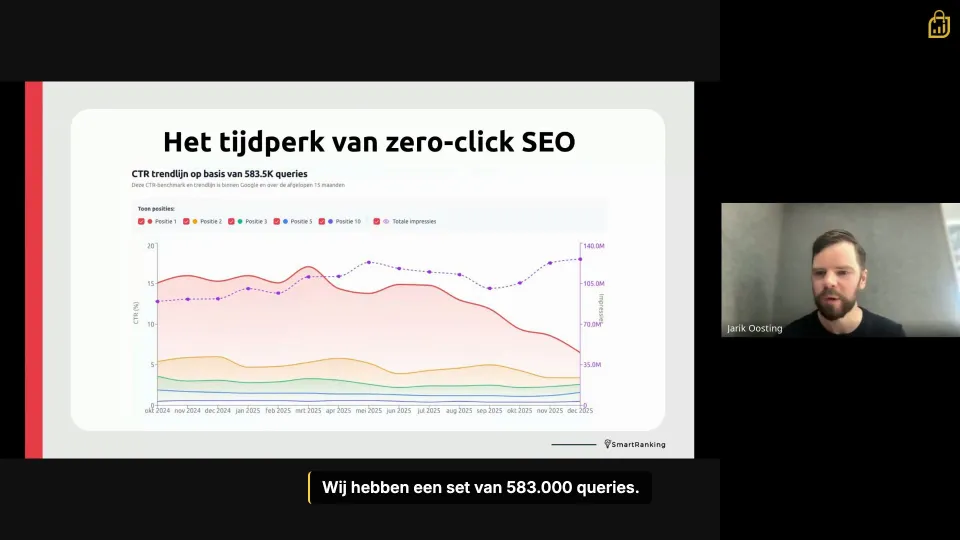
Zero-Click SEO
Jarik Oosting, Smart Ranking
De CTR voor positie 1 in Google is met meer dan de helft gedaald
 Duur 0:41
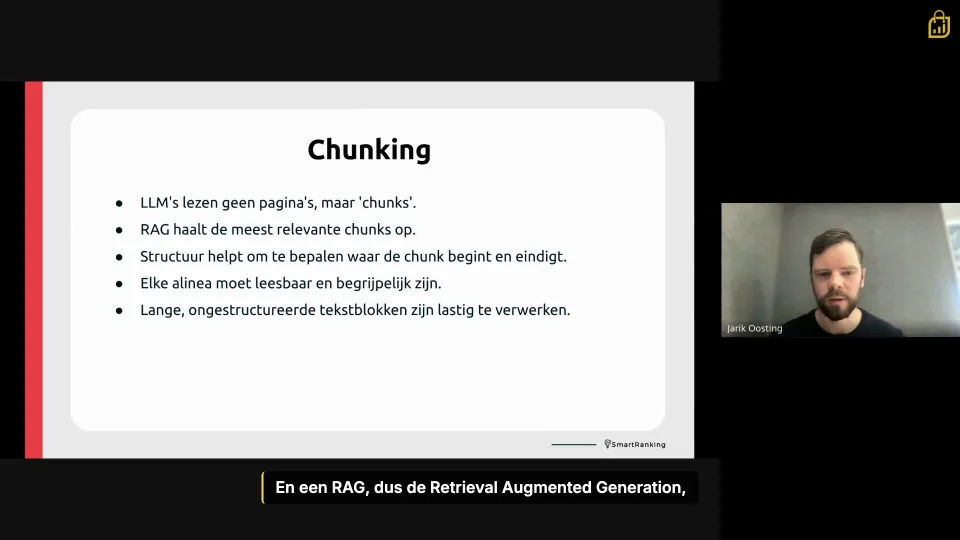
Zo leest een LLM jouw website
Jarik Oosting, Smart Ranking
Een LLM leest niet je hele pagina, alleen de relevante chunks