Eerst je feed verrijken of meteen titels testen?
Ruben Runneboom, Taskforce
Uit de sessie: Marketing: Advertising in the Age of AI
In de Q&A van de marketingsessie van april 2026 vraagt Tachmy Dilmy aan Ruben Runneboom van Taskforce wat eerst moet: je feed verbeteren of al titels laten genereren door AI. Ruben legt uit welke basisdata een taalmodel nodig heeft en hoe je met een kleine selectie producten begint. Voor iedereen met een feed die nog gaten heeft.
Voor wie: Je AI-titels wilt testen maar twijfelt of je feed daar al goed genoeg voor is.
Hetzelfde moment
- Hoofdstuk van 3:16 min: Feed op orde voor AI-titels? Vragen aan Taskforce
Waarom dit ertoe doet
Veel webshops willen AI-titels testen terwijl hun feed nog half leeg is. Een taalmodel kan alleen schrijven met wat het krijgt. Ontbreken merk, kleur of materiaal, dan blijft de titel vaag of gaat het model gokken. Google stelt voor elk product zeven velden verplicht, waaronder titel, beschrijving, link, afbeelding, beschikbaarheid en prijs. Voor kleding vraagt Google voor Shopping-advertenties in onder meer Duitsland, Frankrijk en het Verenigd Koninkrijk ook de kleur. Rubens antwoord is praktisch: je hoeft niet te wachten tot de hele feed perfect is. Begin met een productgroep die genoeg attributen heeft, vul gaten waar nodig met AI en schaal pas op als het werkt. Bij 10.000 SKU's tegelijk wordt het systeem te complex.
Belangrijkste inzichten
- Google verplicht 7 velden voor elk product: id, titel, beschrijving, link, afbeelding, beschikbaarheid en prijs; het merk is verplicht voor nieuwe producten.
- Een taalmodel heeft meer nodig dan het minimum; zonder kleur, maat of materiaal blijft de titelvariant uit attributen vaag.
- Channable kan met AI-verrijkte attributen onder meer kleur, materiaal en merk vullen uit bestaande importdata, op het Core Plus- of Core Pro-plan.
- De titelvariant uit organische zoektermen leunt minder op je feed, maar werkt alleen voor pagina's die al zoekverkeer krijgen.
- Begin met 1 productgroep die genoeg data heeft; Ruben raadt af om meteen met bijvoorbeeld 10.000 SKU's te starten.
Wat een taalmodel minimaal nodig heeft
Ruben vertelt dat Medisave een karige feed had, maar wel de basis die nodig was om titels te maken. Wat die basis is, verschilt per branche. Google houdt een vaste lijst aan. Verplicht voor elk product zijn id, title, description, link, image_link, availability en price. Het merk is verplicht voor alle nieuwe producten, behalve films, boeken en muziekopnames. Een GTIN is niet strikt verplicht, maar Google beveelt het sterk aan, en zonder GTIN vraagt Google een MPN. Voor een goede titel heb je meer nodig dan het verplichte minimum. Denk aan kleur, maat, materiaal of een kernspecificatie. Heeft een product alleen een naam en een prijs, dan heeft het model te weinig om mee te werken en levert de eerste titelvariant weinig op.
Gaten vullen met AI in je feedtool
Ontbreken attributen, dan kun je die volgens Ruben deels met AI aanvullen, bijvoorbeeld in je feedmanagementtool. Zijn voorbeeld: een tennisschoen waarvan de kleur ontbreekt, en een model dat die kleur uit de productfoto haalt. Channable heeft AI-verrijkte attributen die ontbrekende data vullen op basis van je bestaande importdata, zoals titels, URL's en beschrijvingen. De ondersteunde velden zijn onder meer leeftijdsgroep, merk, kleur, geslacht, materiaal, gewicht, afmetingen en zoekwoorden. Je hebt daar het Core Plus- of Core Pro-plan voor nodig, en je keurt de waarden goed voordat ze in je data komen. Kleur uit een foto halen beschrijft Channable in die documentatie niet; dat doe je met een model dat beelden kan lezen. Controleer de uitkomst steekproefsgewijs, want een verkeerde kleur in je feed leidt tot verkeerde verwachtingen bij de klant.
De tweede titel heeft minder feeddata nodig
In de opzet van Taskforce maakt het model twee varianten per SKU. De eerste komt uit de productattributen en heeft dus een gevulde feed nodig. De tweede komt uit de organische zoektermen die bij de landingspagina horen, opgehaald uit Search Console. Voor die variant is een volle feed minder belangrijk, omdat de woorden van de klant zelf komen. Ruben voegt eraan toe dat er wel altijd een aantal basiszaken aanwezig moeten zijn. Een pagina zonder organisch verkeer levert ook geen zoektermen op, dus voor nieuwe of onbekende producten werkt deze route minder goed.
Begin met een selectie
Tachmy vat het samen: je begint met een selectie van je belangrijkste producten, en die heb je waarschijnlijk al beter verrijkt. Ruben bevestigt dat. Medisave had maar twee of drie productgroepen, wat het eenvoudig maakte. Bij een groter assortiment kijk je per productgroep of de minimale gegevens aanwezig zijn, of je ontbrekende informatie uit andere bronnen kunt halen, en start je daar. Het hele assortiment tegelijk raadt hij af: met 10.000 SKU's wordt het systeem te complex. Dat getal is een voorbeeld van Ruben, geen harde grens. Het punt is dat je eerst bewijst dat de opzet werkt op een groep met genoeg data.
Probeer dit deze week
- Exporteer je feed en tel per productgroep hoeveel procent van de producten kleur, materiaal en merk gevuld heeft; kies de groep met de hoogste score als testgroep.
- Laat een taalmodel voor 20 producten zonder kleur de kleur bepalen uit de productfoto en controleer elk resultaat zelf voordat je iets importeert.
- Zoek in Search Console welke 10 productpagina's de meeste organische klikken hebben; dat zijn de beste kandidaten voor een titel op basis van zoektermen.
Begrippen
- Feedmanagementtool
- Software zoals Channable die je productdata ophaalt, aanpast met regels en per kanaal in het juiste formaat doorstuurt.
- Attribuut
- Een veld in je productfeed, zoals kleur, maat, materiaal of merk.
- GTIN
- Het wereldwijde productnummer onder de streepjescode, zoals een EAN; Google gebruikt het om je product te herkennen.
Verdiep je in de gids
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
Ja, Ruben, je gaf net aan van er zijn heel veel feeds waarbij product data eigenlijk nog ontbreekt. Dus dat de kwaliteit van die feed die aangeboden wordt, die niet goed genoeg is. De opzet die jullie gekozen hebben, is dit ook al in te zetten om met dat soort partijen aan de slag te gaan, waarbij feed optimalisatie eigenlijk nog moet gebeuren? of zeg je van, nou weet je wel, begin eerst met feedoptimalisatie voordat je begint met het optimaliseren van een titel, bewijzen van, wat is een beetje de volgeordelijkheid daarin, zeg maar. Ja, dat is een goede vraag. In dit geval was het bij Medisave hadden ze ook een vrij karige piep, als ik het zo mag zeggen. Maar, op basis van, ja, ligt het ook eventjes aan hoe je LLM in deze stap, eigenlijk in die n8n flow stap, hebt geprogrammeerd, Want zo'n LLM heeft wel data nodig om zo'n titel op te kunnen genereren. Je hebt wel een paar basiszaken voor nodig. Nou, dat heeft gelukkig al deze klant dat. Maar ja, als je dus echt heel weinig attributen hebt om mee te werken, dan zal het minder goed werken natuurlijk. En dan is het natuurlijk zaak om ervoor te zorgen dat je die attributen tot op een bepaalde hoogte kan vullen. En dan zou je weer eens kunnen gaan nadenken, oké, kan je bijvoorbeeld je Feed Management Tool gebruiken, waar een AI-functie in zit, dat hij bijvoorbeeld, nou, stel je voor je hebt een hele tennisschoen, ik zeg maar iets, dat hij bijvoorbeeld de color-attribuut kan vullen met de kleur van wat hij uit de foto kan halen met AI. Dus dat soort mogelijkheden zijn er ook allemaal. Dus je hebt wel echt wel een basisaantal zaken nodig om in ieder geval die titel in deze case te kunnen genereren op die attributen. anderzijds kan je natuurlijk wel die organic search term data kan je natuurlijk wel gebruiken in ieder geval om die tweede titel op te genereren dus daar is het dan al wat minder nodig voor maar ja je vind het moet wel een aantal basiszaak voldoen en wat die basis zaken zijn zal weer per branche verschillen en dat is dan niet voor je hele je hele feed hoeft ook niet perfect te zijn om dit te kunnen starten want je start natuurlijk ook met een selectie ervan met het meest belangrijke product en waarschijnlijk heb je die dan wel weer goed verrijkt. Ja, exact. Dus in dit geval hebben ze maar twee of drie verschillende productgroepen. Dus hier was het vrij eenvoudig. En waren er dus wel net genoeg attributen om een titel op te kunnen genereren. Voor die eerste variant titel. Anderzijds, ja, dan zou je moeten kunnen kijken, kunnen we een gedeelte van de productgroep pakken? Kijken of die de minimale vereisten hebben om zoiets op te kunnen laten draaien? Of kan ik misschien uit andere bronnen nog die informatie trekken om je fiets te verrijken om dit te kunnen neerzetten. Dat hoef je zeker niet met het hele productassortiment te doen. Dat zou ik ook zeker niet op het begin aanraden om het helemaal te doen aangezien het dan een vrij complex systeem wordt als je 10.000 SKU's hebt bij wijze van.
Spreker: Ruben Runneboom, Taskforce
Bronnen
Meer over Productdata & Feeds
 Duur 1:39
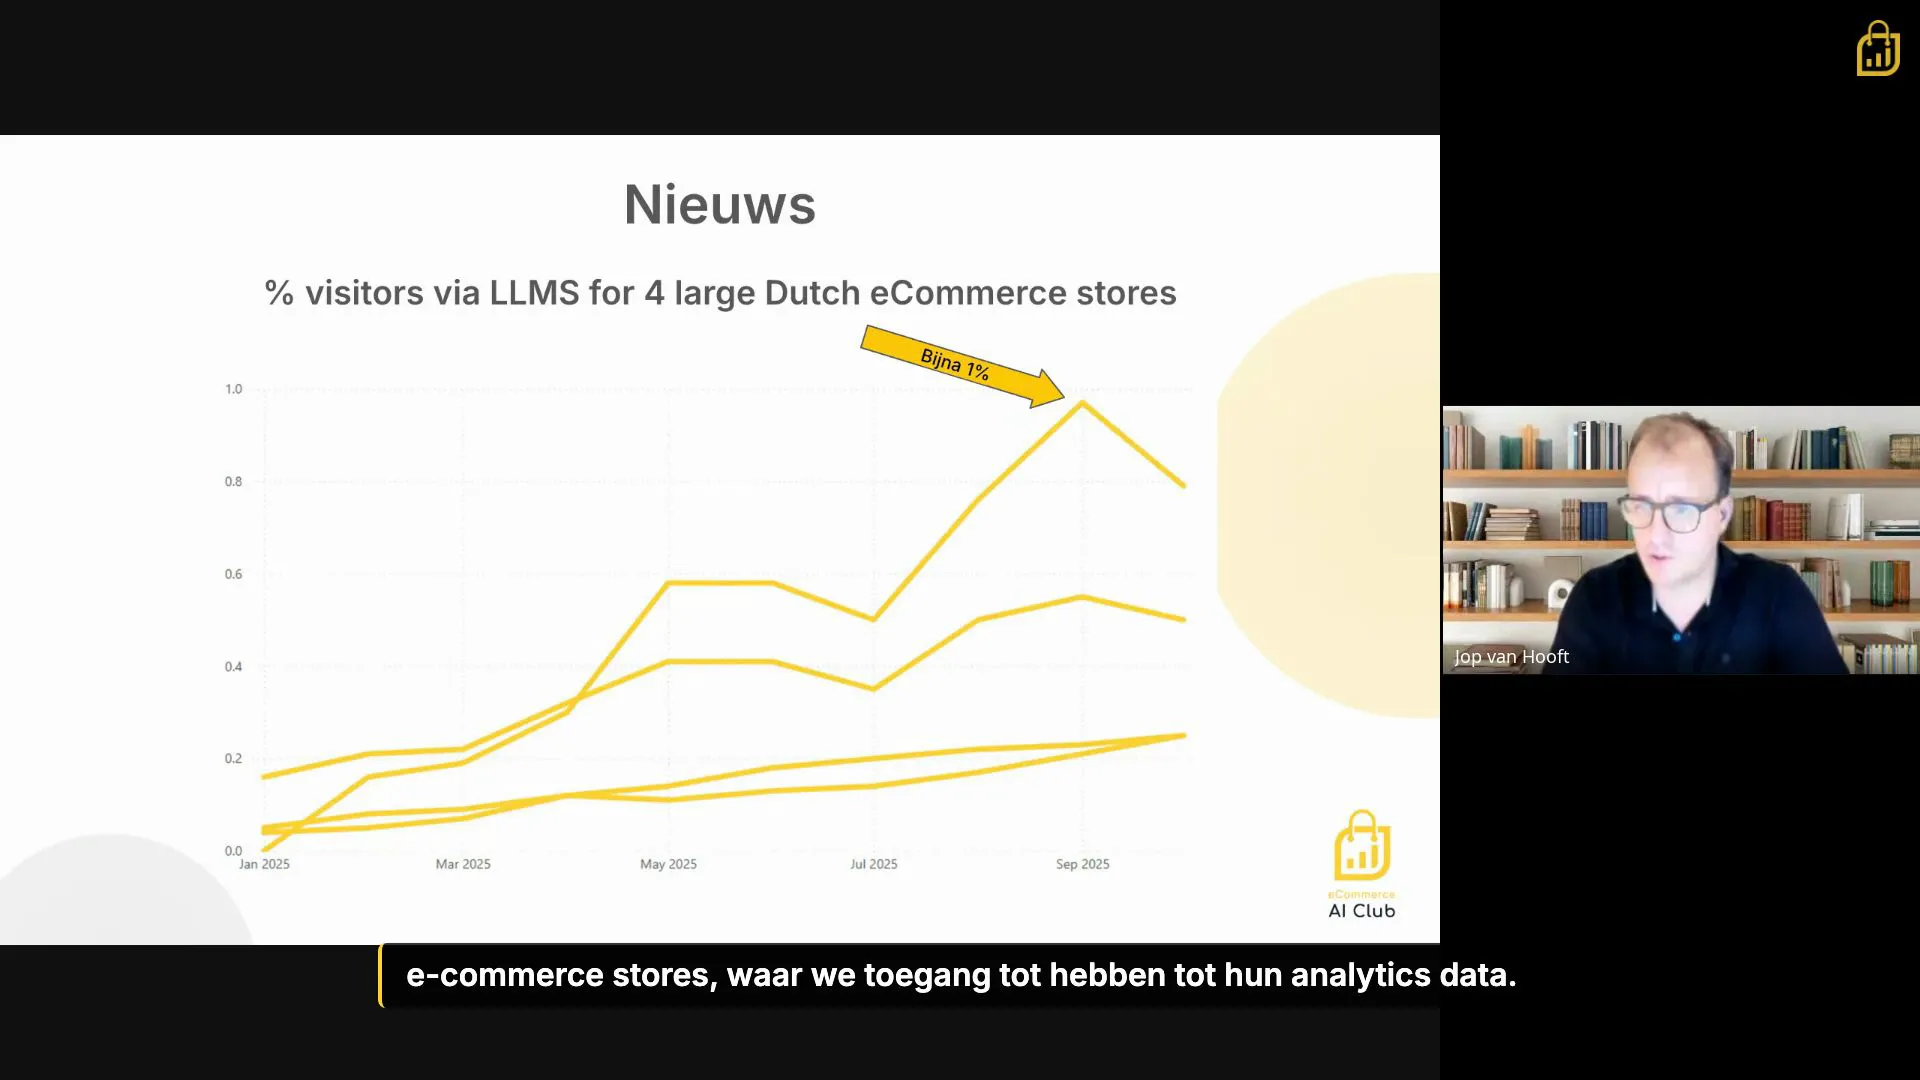
Hoeveel verkeer komt via LLMs bij Nederlandse webshops?
Jop van Hooft, eCommerce AI Club
Slechts 1% van je websiteverkeer komt via LLMs, maar het groeit exponentieel
 Duur 0:40
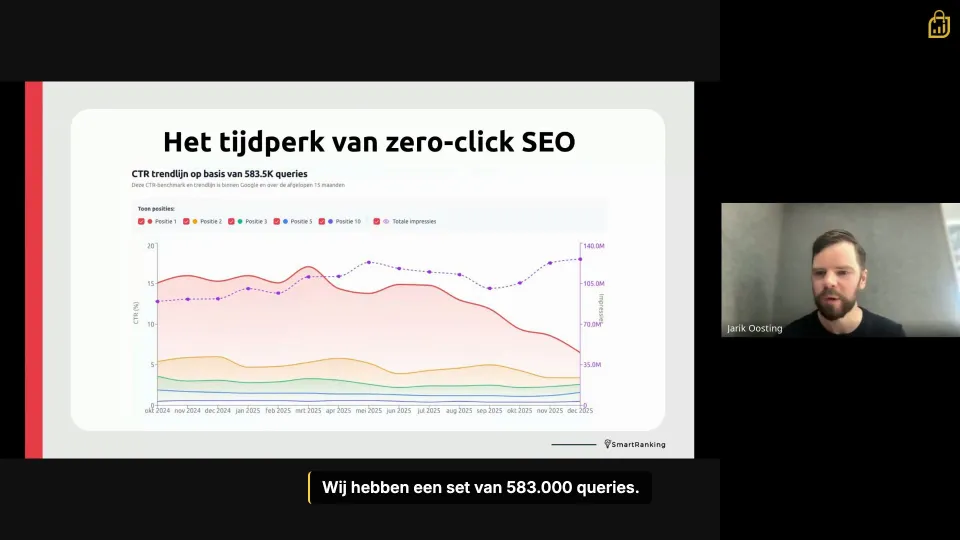
Zero-Click SEO
Jarik Oosting, Smart Ranking
De CTR voor positie 1 in Google is met meer dan de helft gedaald
 Duur 0:41
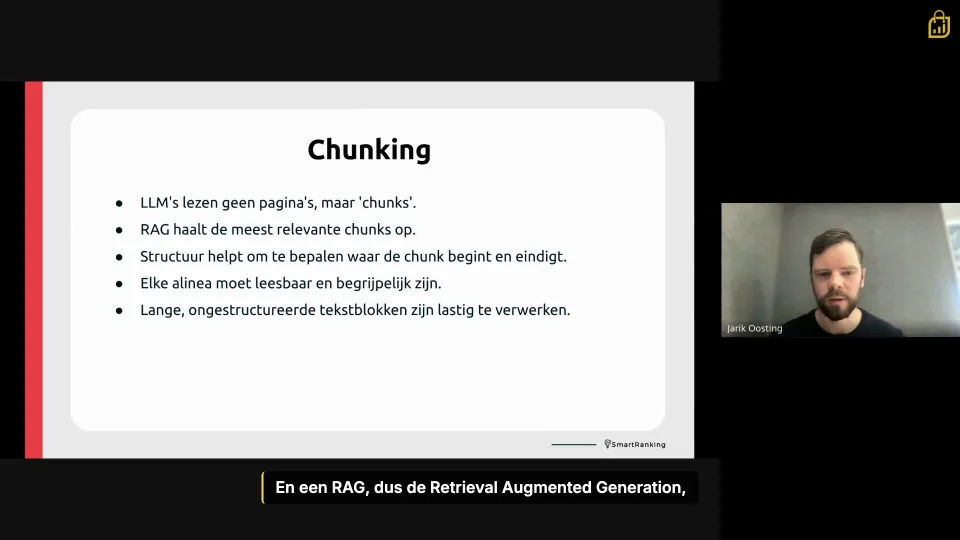
Zo leest een LLM jouw website
Jarik Oosting, Smart Ranking
Een LLM leest niet je hele pagina, alleen de relevante chunks