Beelden op schaal: scripts, Higgsfield en een contentstraat
Tachmy Dilmy, eCommerce AI Club
Uit de sessie: Training AI Literacy Basic (content)
Tachmy Dilmy laat in de basistraining AI Literacy zien hoe je van een paar beelden naar honderden gaat. Hij haalt productinformatie op met een EAN-nummer, laat Claude Code een koppeling met Higgsfield gebruiken en legt uit waarom controle nodig blijft. Jop van Hooft stelt vragen en vat samen.
Voor wie: Je wilt AI-beelden voor een heel assortiment laten maken en weet niet waar je moet beginnen.
Hetzelfde moment
- Clip van 2:12 min: Honderden AI-beelden: wanneer heb je een script nodig?
Waarom dit ertoe doet
Voor 5 of 10 beelden volstaat een chat. Voor een heel assortiment heb je een script nodig, en dan komen de randgevallen. Tachmy heeft batches van 1000 en 2000 beelden gedraaid en zag vreemde dingen gebeuren, omdat AI-modellen niet deterministisch zijn. Zijn oplossing is controle, door een model of door een mens. Jop vraagt of dit voor iemand zonder codeerervaring te doen is; Tachmy denkt van wel, met een collega die kan coderen. Het blijft nodig om te bepalen waar je content vandaan komt en welk model je gebruikt.
Belangrijkste inzichten
- Een EAN-nummer kan via een API productinformatie en afbeeldingen ophalen voor het beeldscript.
- Voor 5 tot 10 beelden volstaat ChatGPT; bij volume heb je scripting nodig.
- Tachmy draaide batches van 1000 en 2000 beelden en zag vreemde dingen door het niet-deterministische gedrag.
- Laat een model de beelden controleren en een mens ze beoordelen voor publicatie.
- De Higgsfield-koppeling in Claude Code is volgens Tachmy een kwestie van 3 commando's.
Van EAN naar beeld
Tachmy schakelt naar een technischer deel en gebruikt dezelfde slaaptrainer als eerder. Hij heeft een software-API waarmee een EAN-nummer de productinformatie ophaalt uit Google Shopping, met beschrijving, specificaties en afbeeldingen. In Claude Code heeft hij Higgsfield geïnstalleerd, zodat hij daarmee beelden kan laten maken, bijvoorbeeld met Nano Banana 2. Met een lijst van 100 EAN's zou hij de data in 1 keer ophalen en door Higgsfield beelden laten genereren. Zijn credits waren net op, maar een eerder gemaakt voorbeeld laat zien dat het werkt.
Eenmalig of op schaal
Heb je een eenmalige flow, dan is stuk voor stuk werken prima, en 5 of 10 beelden kan ChatGPT in de gewone omgeving. Bij groot volume houdt het op, omdat het gemaximaliseerd is op het aantal tokens. Dan heb je scripting nodig en moet je alle edge cases behandelen. Tachmy zag bij batches van 1000 en 2000 beelden vreemde dingen, en verklaart dat uit het niet-deterministische karakter van AI-modellen. Daarom laat je een model de beelden controleren op je stijl, en beoordeelt een mens ze voor publicatie. Direct publiceren zonder controle is volgens hem vandaag nog niet goed.
Drie commando's en een contentstraat
Op Jops vraag of dit zonder codeerervaring kan, zegt Tachmy dat het in een paar uurtjes draait, of sneller. Het Higgsfield-MCP is een kwestie van 3 commando's en 1 keer verbinden met je account; je creditcard moet gekoppeld zijn. Vroeger kostte een Google Gemini-koppeling hem een paar uur. Het grootste probleem is nu waar je de content vandaan haalt: een goede basis in je PIM, Shopify of Magento kan als bron dienen. Verbind je bron, bronbeelden en model, dan heb je een contentstraat.
Probeer dit deze week
- Kies 10 producten uit 1 categorie en laat per product 2 beelden genereren met een script of koppeling.
- Zet een controlestap op: eerst een model, dan een mens, dan pas publiceren.
Begrippen
- MCP
- Model Context Protocol, een standaard om een AI-tool aan andere diensten te koppelen.
- Edge case
- Een uitzonderlijke situatie die een script niet verwacht.
- Contentstraat
- De keten van bron, model en controle waarmee je beelden op schaal maakt.
Verdiep je in de gids
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
Als je eenmaal een stijl hebt ontwikkeld, dan heb je je prompting goed te pakken en kan je dat eigenlijk makkelijk doorkopiëren middels een Claude Code om dat te doen. Dat is eigenlijk de laatste stap ik je nog even wilde laten zien, is dat als je plaatjes wil laten maken op schaal, dan is op een gegeven moment een script of een Claude, als je dat nou in een Claude Code maakt of iets anders, is noodzakelijk. waarbij je uiteraard je eigen feed kan gebruiken als de source van de data. Of je kan een externe bron gaan gebruiken. En dat kan dan de link van de fabrikant zijn die je dan doorkrijgt. De plaatjes database van je fabrikant die je opgeeft in een lijst om aan te maken. Of je gaat daadwerkelijk aan de slag met een externe API waar je die data vandaan haalt. Ik zal even dit laten zien. Ik switch even naar een wellicht wat technischer onderdeel, maar wel leuk om te laten zien. Als we hetzelfde product even erbij pakken, ga ik even op een ander scherm, zodat jullie dan niet mee kunnen kijken. Zul ik even de EIN-code op van die Zazu slaaptrainer die we net hadden. Dat is deze. En wat we dan eigenlijk kunnen zeggen is, wat ik hier gedaan heb, is goed om te vertellen. Ik heb een software API waarbij je een EAN code erin kan stoppen en dat we dan de productinformatie eruit halen. En als we dan deze vragen om product information van Google Shopping voor dit, dan zou je dat moeten aanroepen en dan zou je eigenlijk die productinformatie gelijk moeten krijgen. dit is dan de slaaptrainer heeft deze de scripting deze specificaties en het heeft deze plaatjes wat je dan kan doen is als je Higgsfield als eigenlijk dat programma waarbij je eigenlijk meerdere modellen tegelijkertijd kan laten uitdraaien en ii plaatsen kan laten maken kan je eigenlijk vragen van nee als je dan Higgsfield hebt dat eenmaal installeert binnen je Claude Code, dan heb je daar eigenlijk toegang toe om daar gelijk plaatjes van te laten maken. Als je dan vraagt aan zou je een infographic kunnen maken met deze informatie in Higgsfield met Nano Banana 2. En natuurlijk is dit nog niet de juiste prompting, nog niet de juiste afstemming, stijl en dat soort zaken. Maar wat hij dus nu wel kan doen is eigenlijk, zonder dat je dus, je zou natuurlijk ook een URL als input kunnen gebruiken, maar als je een lijst hebt met bijvoorbeeld 100 AN's, dan zou je die 100 AN's de data daarvan kunnen ophalen in één keer. Die geef je dan eigenlijk hierin mee en laat je door Higgsfield een plaatje genereren. en hij is nu bezig, hij heeft dan iets uit een eigen prompt verzonnen, dus als je natuurlijk geen informatie verder meegeeft, dan maakt hij er zelf wat van maar het is echt puur ter informatie dat hij het zo moet doen en dan zegt hij natuurlijk dat er niet genoeg credits zijn ik kijk of er nog ah, jammer, ik heb dan net mijn laatste credits denk ik verspeeld, ik had hierboven wel een plaatje laten maken als ik dan even teruggaan in de historie met een ander product en dat was dit, Haribo Persica heeft hij hetzelfde voor gedaan en daar is dan een palaatje uitgekomen en die kan ik wel even laten zien deze en dan moet ik even mijn schermsuitje om dat te laten zien en dat is deze geworden Dus dat geeft eigenlijk aan dat je, als je dit dan echt programmatically zou willen doen, zodat je dus eigenlijk je eisen feed, als je eenmaal door hebt welke prompting heel goed werkt, dan zou je dus eigenlijk met een Claude code ervoor kunnen zorgen dat je dus een end-to-end script maakt wat van de oorsprong, en of dat nou een feed is, of dat nou een AAN-code is, of dat nou een website-URL is, kan je eigenlijk met de juiste stap en de juiste prompting en ervoor zorgen dat je een plaatje genereert die eenmaal in jouw stijl zit. Vervolgens heb je een lijst met plaatjes gegenereerd, dan kan je die nog een keer door het model laten controleren bijvoorbeeld, om dan te checken van, is dit volledig binnen onze stijl of niet? En vervolgens kan je ze dan ook nog met een handmatige check bekijken van, ik zou dit toch nog willen aanpassen, zodat je daarna wel het plaatje hebt wat je op je website zou willen publiceren. Dat moet je alsof heel even samenpakken. Je liet nou eigenlijk een... In eerste instantie heb je een methode zien waar je één of twee plaatjes gewoon heel goed kan genereren. En wat je zojuist liet zien is eigenlijk een methode wat je kan inzetten als je honderden plaatjes wil genereren. Dat is ook zo'n nieuwsgild. Ja, dat is eigenlijk... Ja, precies. Dus zodra je echt hier een... Als je een eenmalige flow hebt, is dat eigenlijk gewoon prima om dat stuk voor stuk te doen. Sterker nog, als je vijf of tien plaatjes, dan kan zo'n ChatGPT dat prima vanuit de reguliere ChatGPT-omgeving maken. Op een gegeven moment, als je een groot volume er doorheen wil doen, dan houdt ChatGPT gewoon op. Omdat dat gemaximaliseerd is op het aantal tokens wat hij kan verwerken. En dan moet je eigenlijk echt met de scripting aan de slag gaan, om dan plaatjes te laten genereren met een wat groter volume. Daarvoor moet je dus wel echt heel goed al die edge cases ook goed hebben behandeld. Want vaak wat wij zien is dat we, ik heb dat vaker gedaan voor plaatjes, Dus als je er 10 maakt, werkt het prima. Maak je er 50, gaat het ook prima. We hebben ook batches gedaan van 1000, 2000 plaatjes. En dan zie je wel echt dat er hele vreemde dingen ook weer gebeuren. Omdat AI-modellen zijn non-deterministisch, heet dat dan. Dus een plaatje, als je dat 10 keer draait, dan kan die 10 keer een goed resultaat geven. En de elke keer misschien net wat anders. En dat zijn dan echt de cases waar je dan toch wellicht het AI-model weer moet gebruiken om controle te doen. omdat er gewoon nog steeds direct publiceren naar een site, zonder naar gekeken te hebben, of door het AI-model, of door jezelf, is vandaag gewoon nog niet goed. Ja, precies. En als je nou helemaal geen ervaring hebt met coderen, en je zoekt een collega op die goed kan coderen, dan is het niet overdreven moeilijk om dit te doen, toch? Dan moet je in een paar uurtjes toch wel draaiend kunnen krijgen. Ja, ik denk nog wel veel sneller. Maar dat Higgsfield MCP, dat is echt een kwestie van drie commando's, enter en dan één keer connecten met je account. En je creditcard moet daar natuurlijk wel aan gekoppeld zijn. Maar dan kan je eigenlijk al direct plaatjes maken vanuit die Claude Code omgeving. En dat is wel echt, ja. In de vorige versies moet je eigenlijk zelf een koppeling maken met de Google Gemini API. En daar was ik voorheen echt gewoon een paar uur mee kwijt om dat echt werken te krijgen. En nu, doordat die MCP's ook steeds meer er zijn, is het veel makkelijker om het connecten naar het genereren van plaatjes, is veel makkelijker geworden. En eigenlijk is dan nog het grote probleem, waar hou je de content vandaan om jouw eigen plaatjes te genereren. En als je dat zelf al hebt, is dat wel prima. Als je een hele goede basis hebt in jouw PIM, in jouw eigen Shopify-omgeving, in jouw eigen Magento. dan kan je die als bronplaatjes natuurlijk gebruiken. Maar heb je dat niet, dan moet je daar ook nog een oplossing voor maken. Dus dat zijn eigenlijk de twee dingen om op te lossen. Waar hou je de content vandaan? Dan is het wat voor bronting doe je? En dan is het door welk model laat je het genereren. En als je die drie dingen met elkaar koppelt, dan heb je eigenlijk een soort van contentstraat gecreëerd.
Spreker: Tachmy Dilmy, eCommerce AI Club
Meer over AI Implementatie
 Duur 1:09
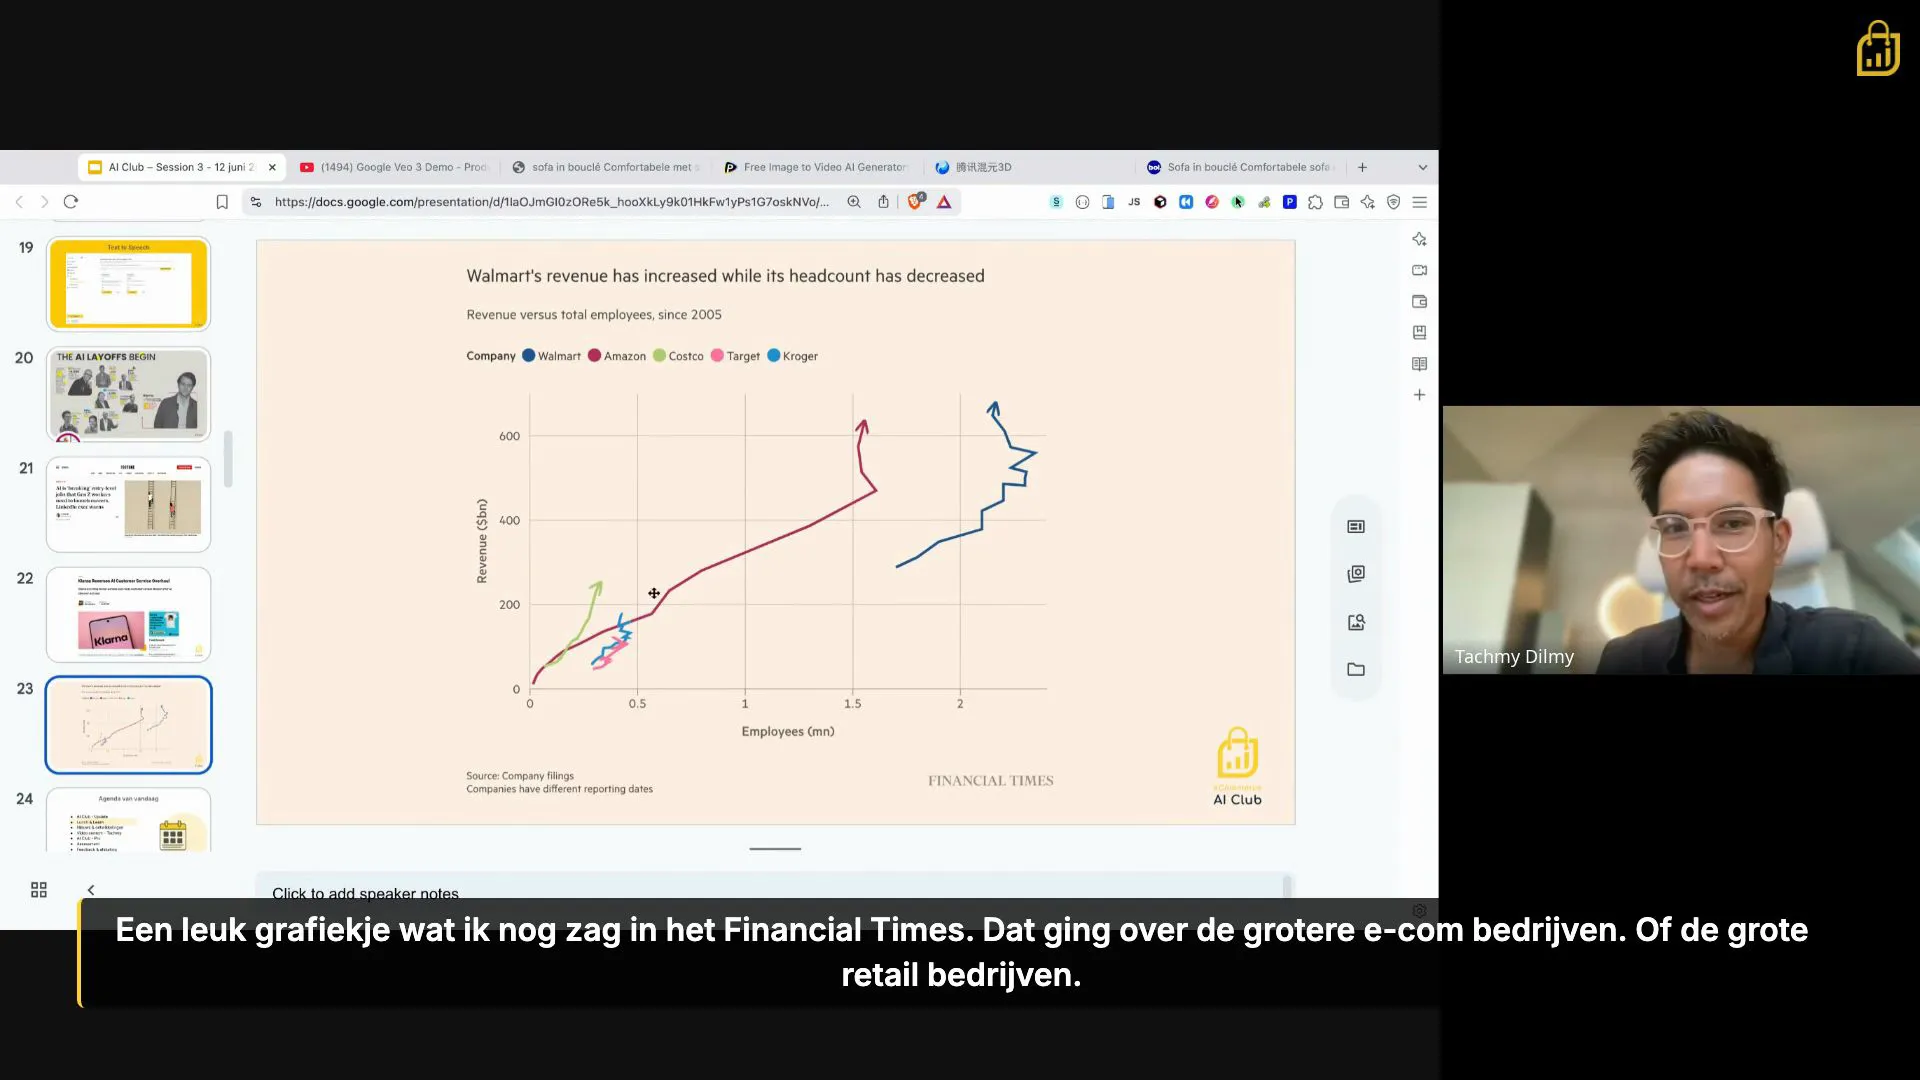
Walmart: meer omzet, minder mensen
Tachmy Dilmy, eCommerce AI Club
Walmart draait 600 miljard omzet, met steeds minder mensen
 Duur 0:57
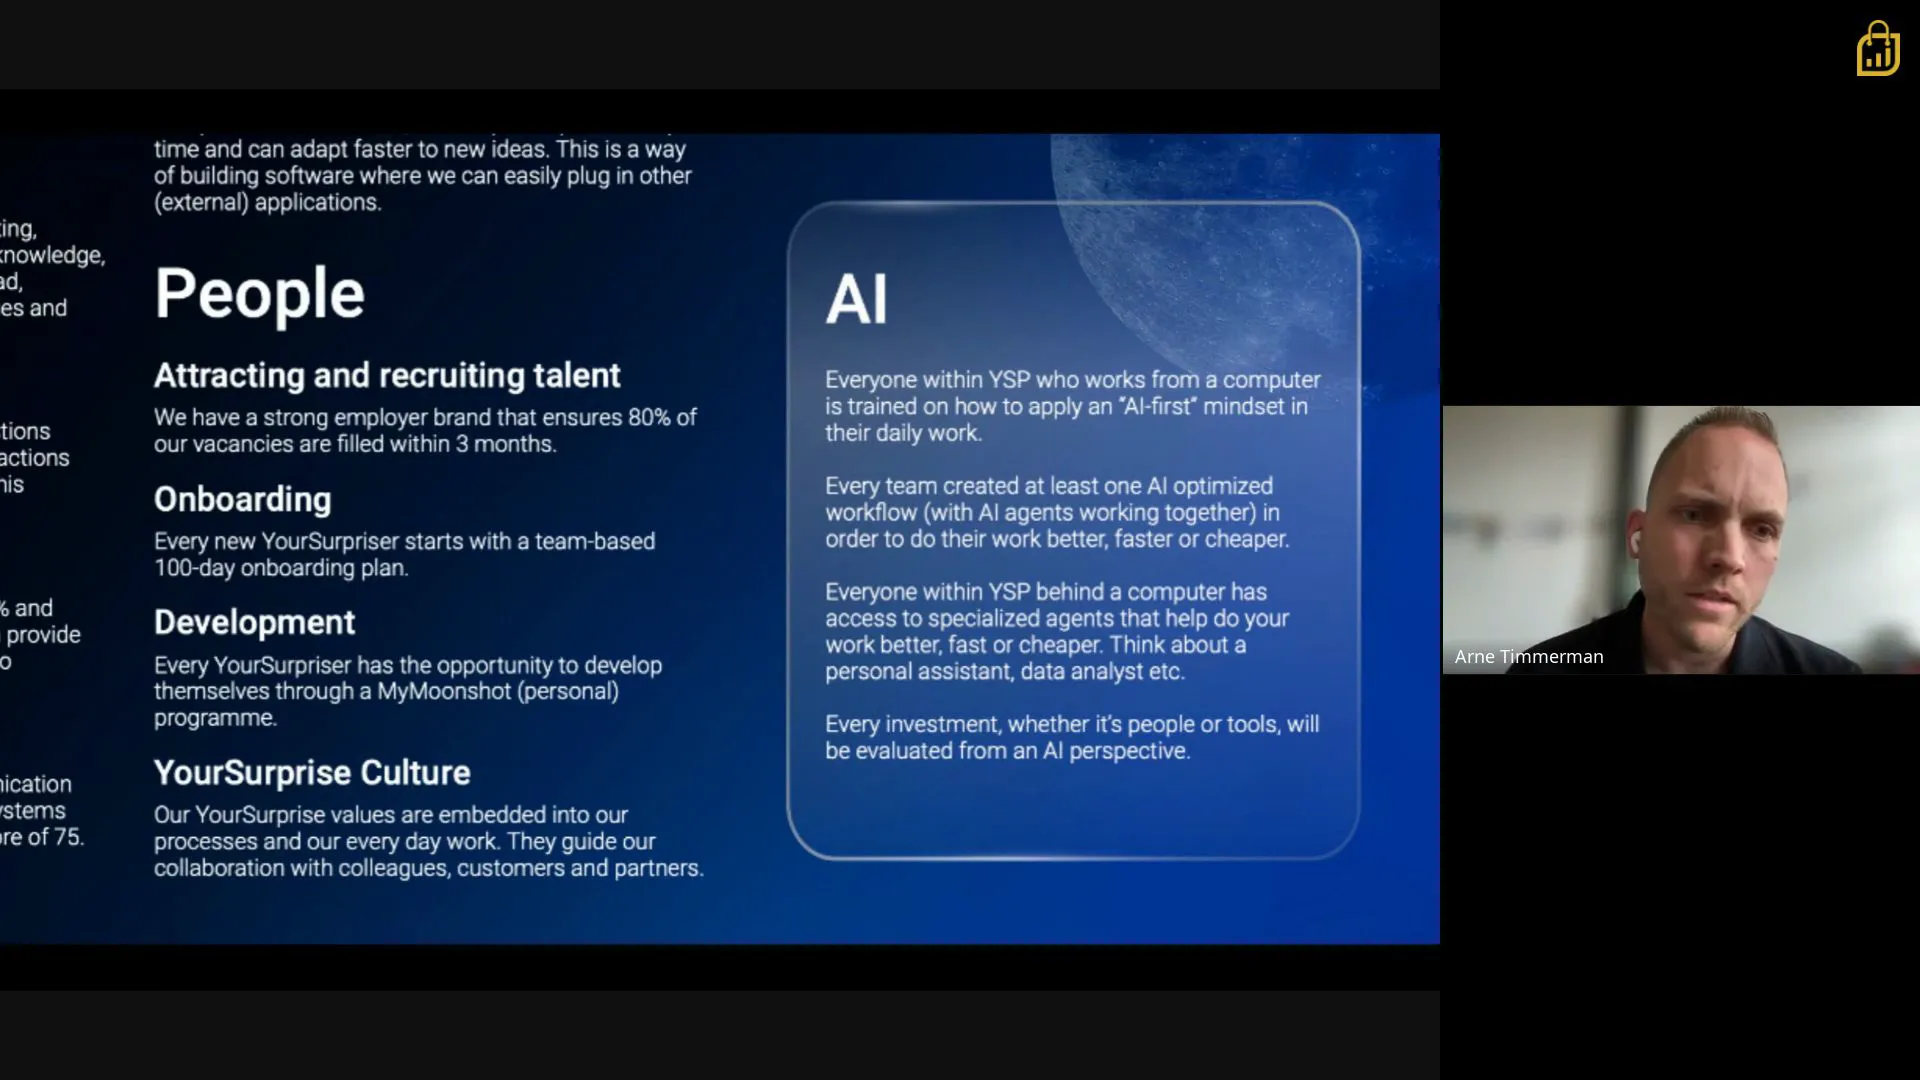
YourSurprise: vier AI-doelen voor het hele bedrijf
Arne Timmerman, YourSurprise
Vier bedrijfsbrede AI-doelen, zo pakt YourSurprise het aan
 Duur 1:40
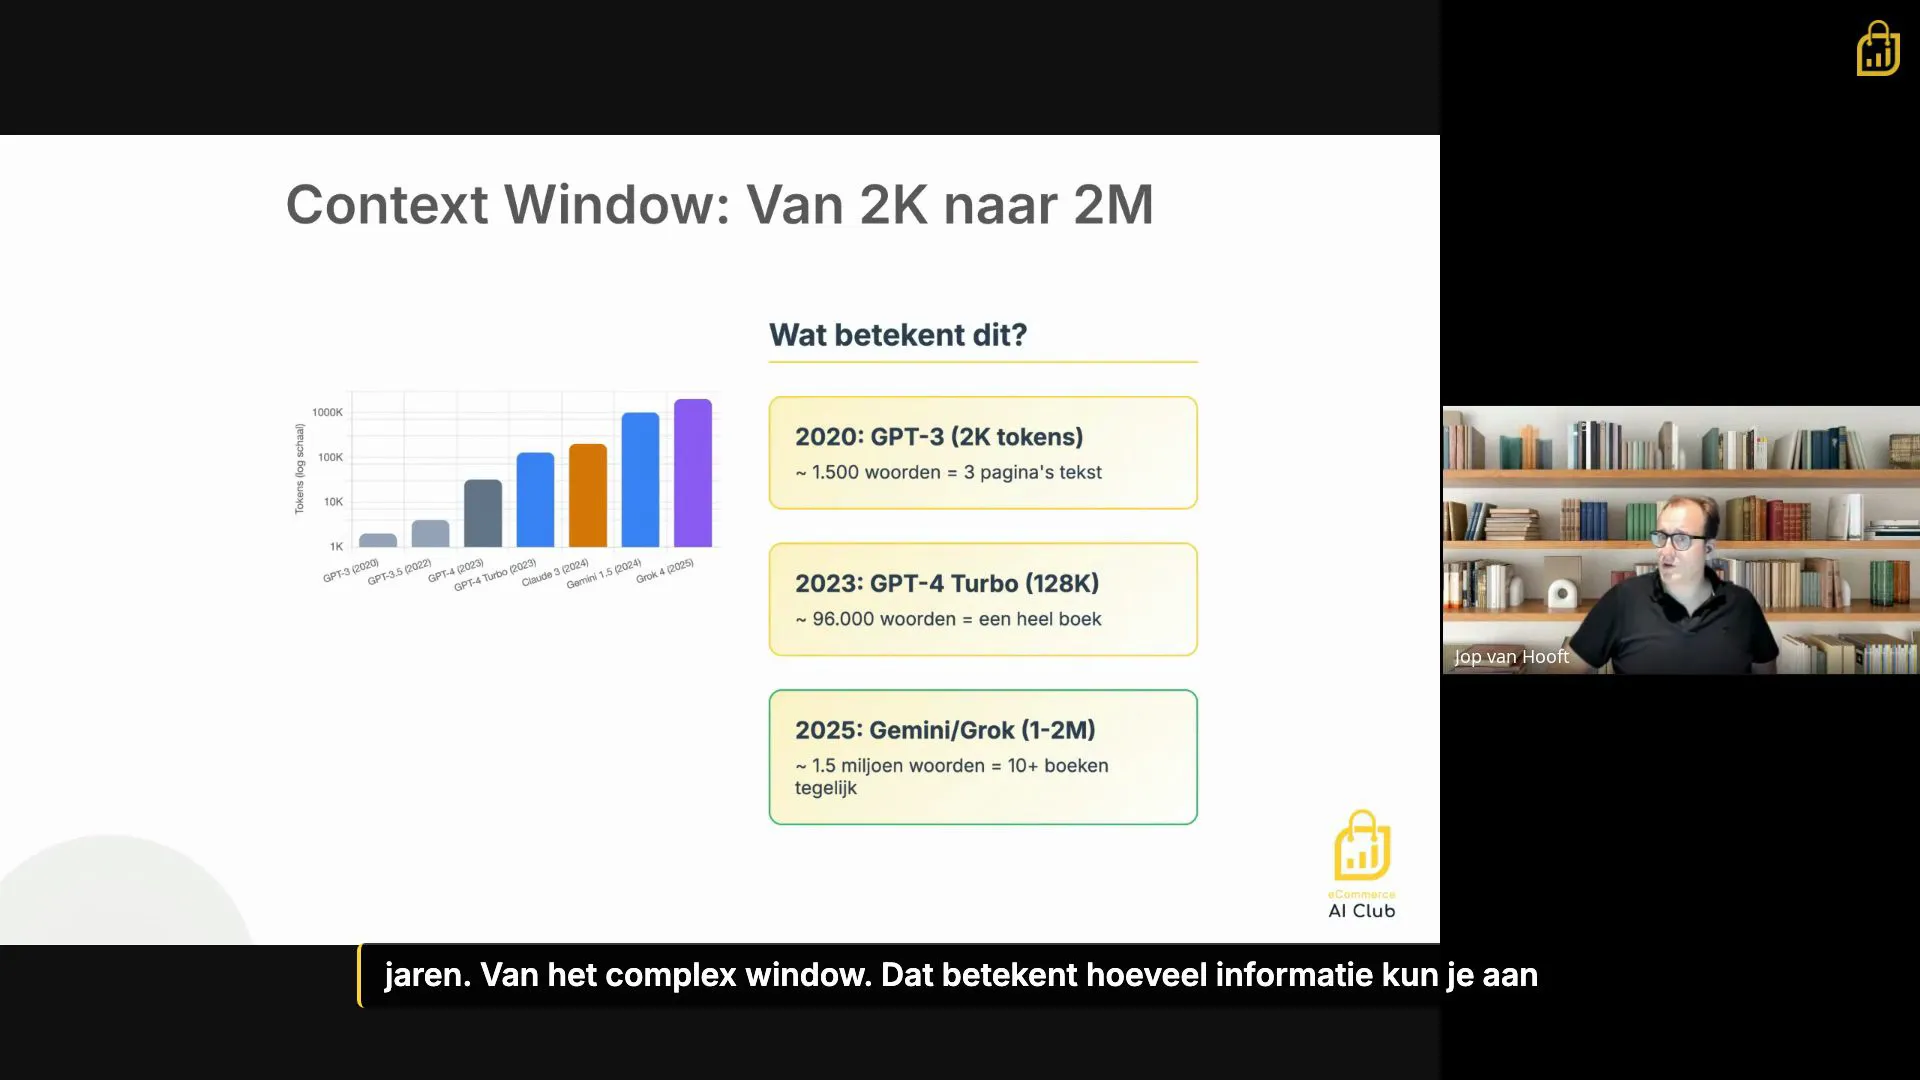
Context Window: van 2K naar 2 miljoen tokens
Jop van Hooft, eCommerce AI Club
Van enkele pagina's naar 10 boeken tegelijk in je AI-model, en dat verandert alles