Context Window: van 2K naar 2 miljoen tokens
Jop van Hooft, eCommerce AI Club
Uit de sessie: Maandelijkse Meeting dec 2025
In dit korte stuk schetst Jop van Hooft hoe groot het geheugen van een AI-model geworden is. Je ziet de sprong van een paar pagina's tekst naar miljoenen tokens en wat dat betekent als je een hele catalogus of kennisbank in een keer wilt meegeven. Het is bedoeld voor managers die AI inzetten op eigen bedrijfsdata.
Voor wie: Je wilt weten waarom AI-modellen ineens hele catalogi kunnen verwerken en waar de grens ligt.
Waarom dit ertoe doet
Als je een AI-model iets laat doen met jouw data, moet die data in het context window passen. Was dat vroeger twee pagina's, dan moest je alles zelf knippen, samenvatten en selecteren, en ging er onderweg informatie verloren. Bij een window van een miljoen tokens of meer past een complete productfeed, een jaar aan klantenservicemails of je hele handleidingenmap in een prompt. Dat scheelt bouwwerk: minder koppelingen, minder zoeklogica, sneller een werkend prototype. Er is een prijskaartje: elke token die je meestuurt kost geld en tijd, en Google waarschuwt zelf dat de nauwkeurigheid daalt als het model meerdere details tegelijk moet terugvinden. Wie dit begrijpt, kiest bewuster tussen alles meegeven en slim selecteren.
Belangrijkste inzichten
- GPT-3 had in 2020 een context window van 2.048 tokens; Gemini 1.5 Pro haalde in 2024 2 miljoen tokens, ruim 970 keer zoveel.
- Google rekent bij 1 miljoen tokens op ongeveer acht romans of 50.000 regels code, dus de tien boeken uit de clip zijn een ruwe schatting.
- Alles wat buiten het context window valt, ziet het model niet, ook al heb je het eerder gedeeld.
- Vindt het model meerdere gegevens tegelijk terug, dan daalt volgens Google de nauwkeurigheid; test dus met je eigen data.
- Elke meegestuurde token kost geld en wachttijd; context caching kan herhaalde kosten drukken.
Wat is een token en een context window?
Een token is het stukje tekst waarin een taalmodel rekent. Dat is vaak een woord of een deel van een woord, dus geen vast aantal letters. Het context window is de hoeveelheid tokens die het model in een keer kan zien: jouw vraag, de documenten die je meegeeft en het antwoord dat het zelf schrijft. Wat buiten het window valt, bestaat voor het model niet. Een grotere window betekent dus niet dat het model slimmer is, maar dat het meer tegelijk kan overzien.
De cijfers: van 2.048 naar 2 miljoen
Het startpunt dat Jop noemt, 2.000 tokens, klopt met de oorspronkelijke GPT-3 uit 2020: die had een window van 2.048 tokens. Het eindpunt is Gemini 1.5 Pro van Google. Google kondigde in mei 2024 een window van 2 miljoen tokens aan en stelde dat eind juni 2024 beschikbaar voor alle ontwikkelaars. Dat is ruim 970 keer zoveel als GPT-3. Google zelf rekent bij 1 miljoen tokens op ongeveer acht romans, ofwel zo'n 50.000 regels code. Jop spreekt van tien boeken bij 2 miljoen. Dat is volgens Jop van Hooft een ruwe vergelijking: het hangt af van de lengte van de boeken, en op basis van Google's eigen rekensom zou 2 miljoen eerder richting zestien gemiddelde romans gaan.
Wat de clip niet zegt: de grenzen
Meer past niet automatisch beter. De documentatie van Google noemt drie kanttekeningen. Het model vindt een enkel gegeven in een grote stapel goed terug, maar de nauwkeurigheid daalt als het er meerdere tegelijk moet vinden. Een lange prompt verhoogt de wachttijd voor het eerste woord van het antwoord. En je betaalt voor de tokens die je meestuurt; context caching, waarbij je dezelfde grote bundel hergebruikt, kan die kosten drukken. Ook handig: zet je vraag aan het einde van de prompt, dat werkt volgens Google over het algemeen beter.
Wat dit betekent voor een webshop
De stelling dat dit transformatief is voor eCommerce is een mening van Jop van Hooft, maar de basis is feitelijk: een catalogus van een paar duizend producten past in zo'n window, net als je retourbeleid, tone of voice en de laatste honderd klantvragen. Het is vooral nuttig voor analyse en prototypes. Voor een live chatbot met duizenden gebruikers per dag blijft het per vraag meesturen van alles duur, en dan loont selectie van alleen de relevante stukken nog steeds. Begin dus met de grote window om te ontdekken wat het model met je data kan, en optimaliseer daarna.
Probeer dit deze week
- Laad je volledige productfeed of retourbeleid in een model met groot window en stel vijf vragen waarvan je het antwoord al weet. Tel hoeveel er klopt.
- Vraag je leverancier of tool hoeveel tokens je per vraag meestuurt en wat dat per maand kost bij je huidige volume.
- Zet bij elke prompt met veel documenten je eigenlijke vraag onderaan en vergelijk het resultaat met de oude volgorde.
Begrippen
- Token
- Het stukje tekst, vaak een woord of woorddeel, waarin een taalmodel rekent en waarop je betaalt.
- Context window
- De hoeveelheid tokens die een model in een keer kan zien, inclusief je vraag, je documenten en het antwoord.
- Context caching
- Een techniek waarbij een grote, steeds terugkerende bundel tekst wordt hergebruikt zodat je er minder vaak voor betaalt.
Verdiep je in de gids
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
Wat zien we dan in die nieuwe modellen? Onder andere ontzettende groei die door blijft zetten over de afgelopen jaren van het context window. Dat betekent: hoeveel informatie kun je aan zo'n model meegeven? Waar je een paar jaar geleden nog enkele pagina's en informatie mee kon nemen, twee jaar geleden aan je een heel boek tegelijkertijd kan nemen, daar kan je nu anderhalf miljoen woorden meesturen. Twee miljoen tokens. En dat betekent dat je tien boeken in één keer in kan lezen in je prompt. En dan kun je vragen van: op welke bladzijde in Harry Potter heet Harry Potter een blauwe draai aan? En dan geef je de hele Harry Potter series als input mee.
[onverstaanbaar] En dan is heel veel Harry Potter meegeven natuurlijk niet het doel, maar heel veel grote codebase meegeven kan natuurlijk ook. Of images, of wat voor context je dan ook hebt op dat moment.
Ik heb ze hier heel even op een rijtje gezet, de modellen die er momenteel uit zijn, en wat er nou bijzonder aan is. Ik heb twee vragen gesteld: wat is er nou nieuw aan dit model? En waar is het ontzettend goed in? Dan zie je het model van OpenAI, waar Tom geroemd werd, is dat het een soort van adaptive reasoning heeft. Wat ze daarmee willen zeggen, is dat het de denktijd aanpast naarmate je de query stelt. Stel jij een makkelijke vraag, denk je kort, maar geeft hij je snel antwoord. Want stel jij een moeilijke vraag, dan gaat er nog een wat reasoningstap overheen. En dan duurt het de tijdje voordat je anders kijkt, maar dan heeft hij wat dieper nagedacht. Ook hier hebben ze de acht persoonlijkheid presets geïntroduceerd.
Spreker: Jop van Hooft, eCommerce AI Club
Bronnen
Meer over AI Implementatie
 Duur 1:09
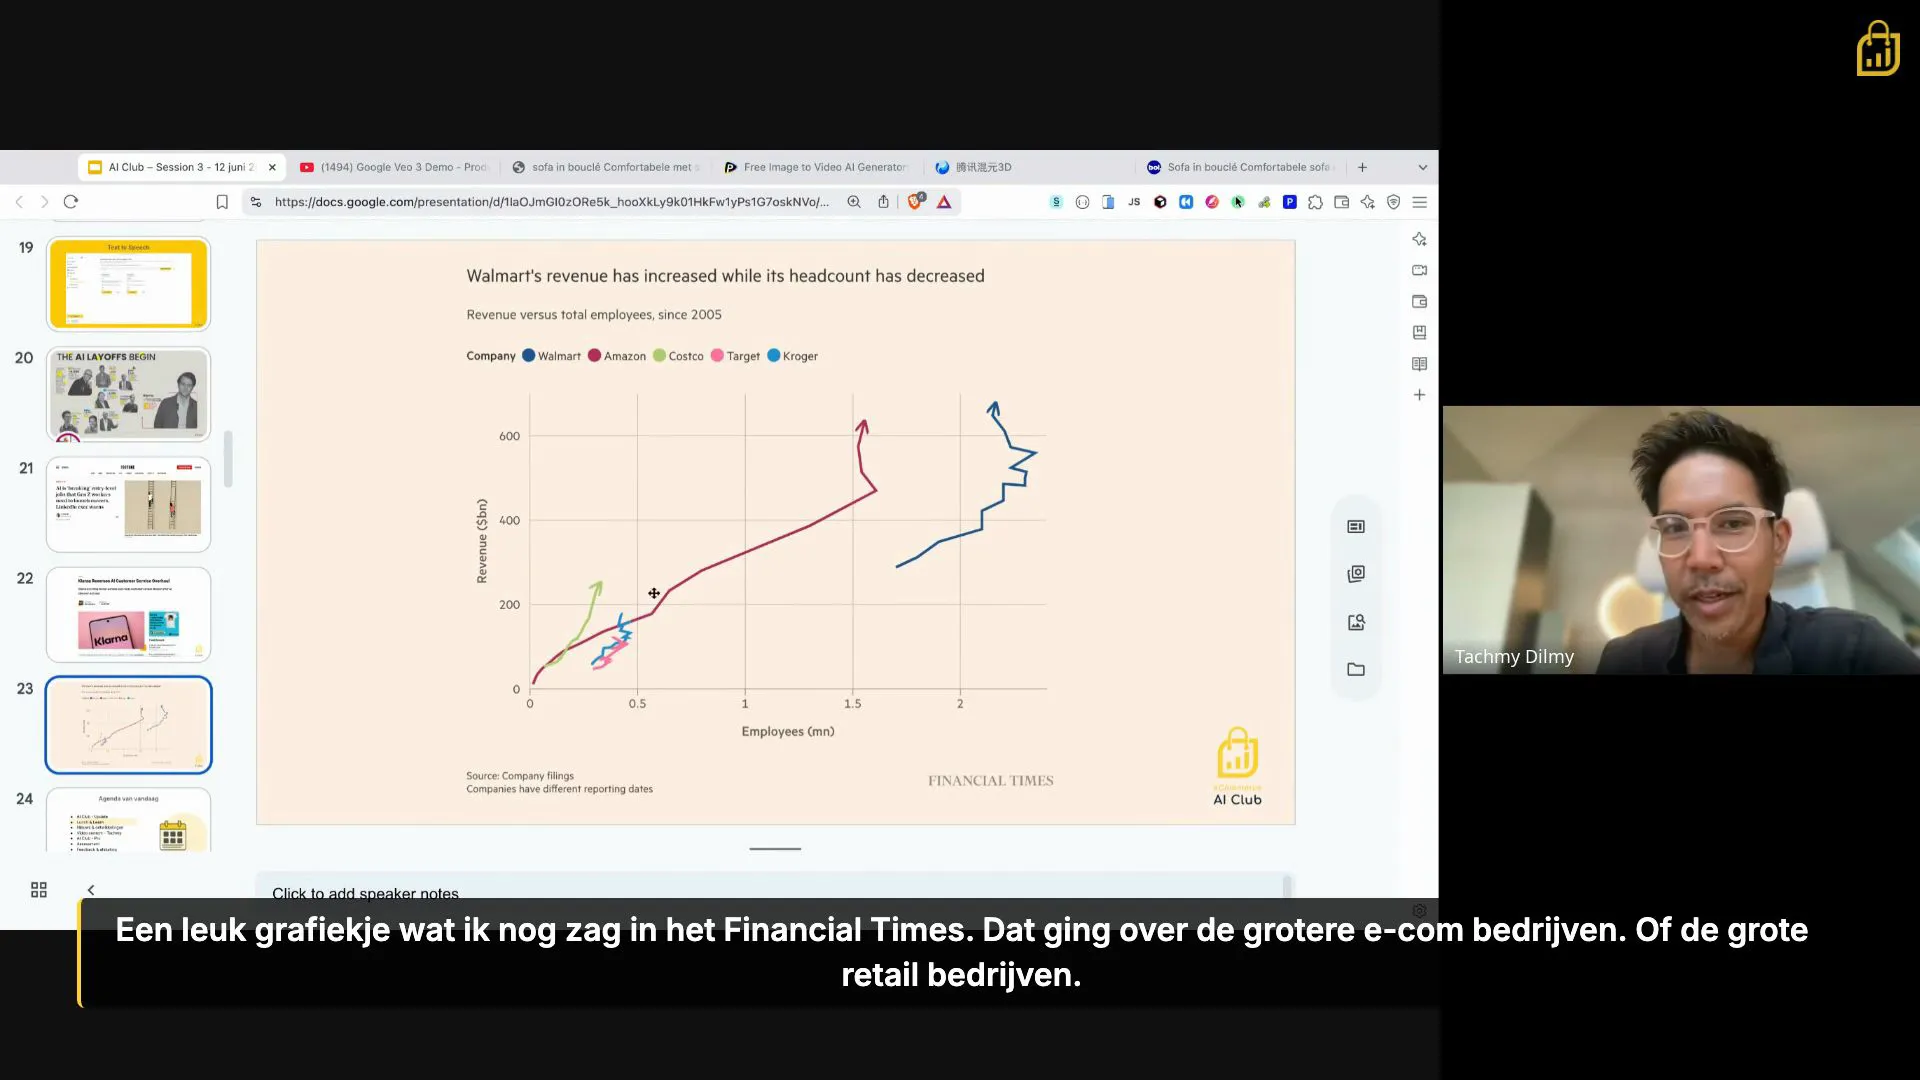
Walmart: meer omzet, minder mensen
Tachmy Dilmy, eCommerce AI Club
Walmart draait 600 miljard omzet, met steeds minder mensen
 Duur 0:57
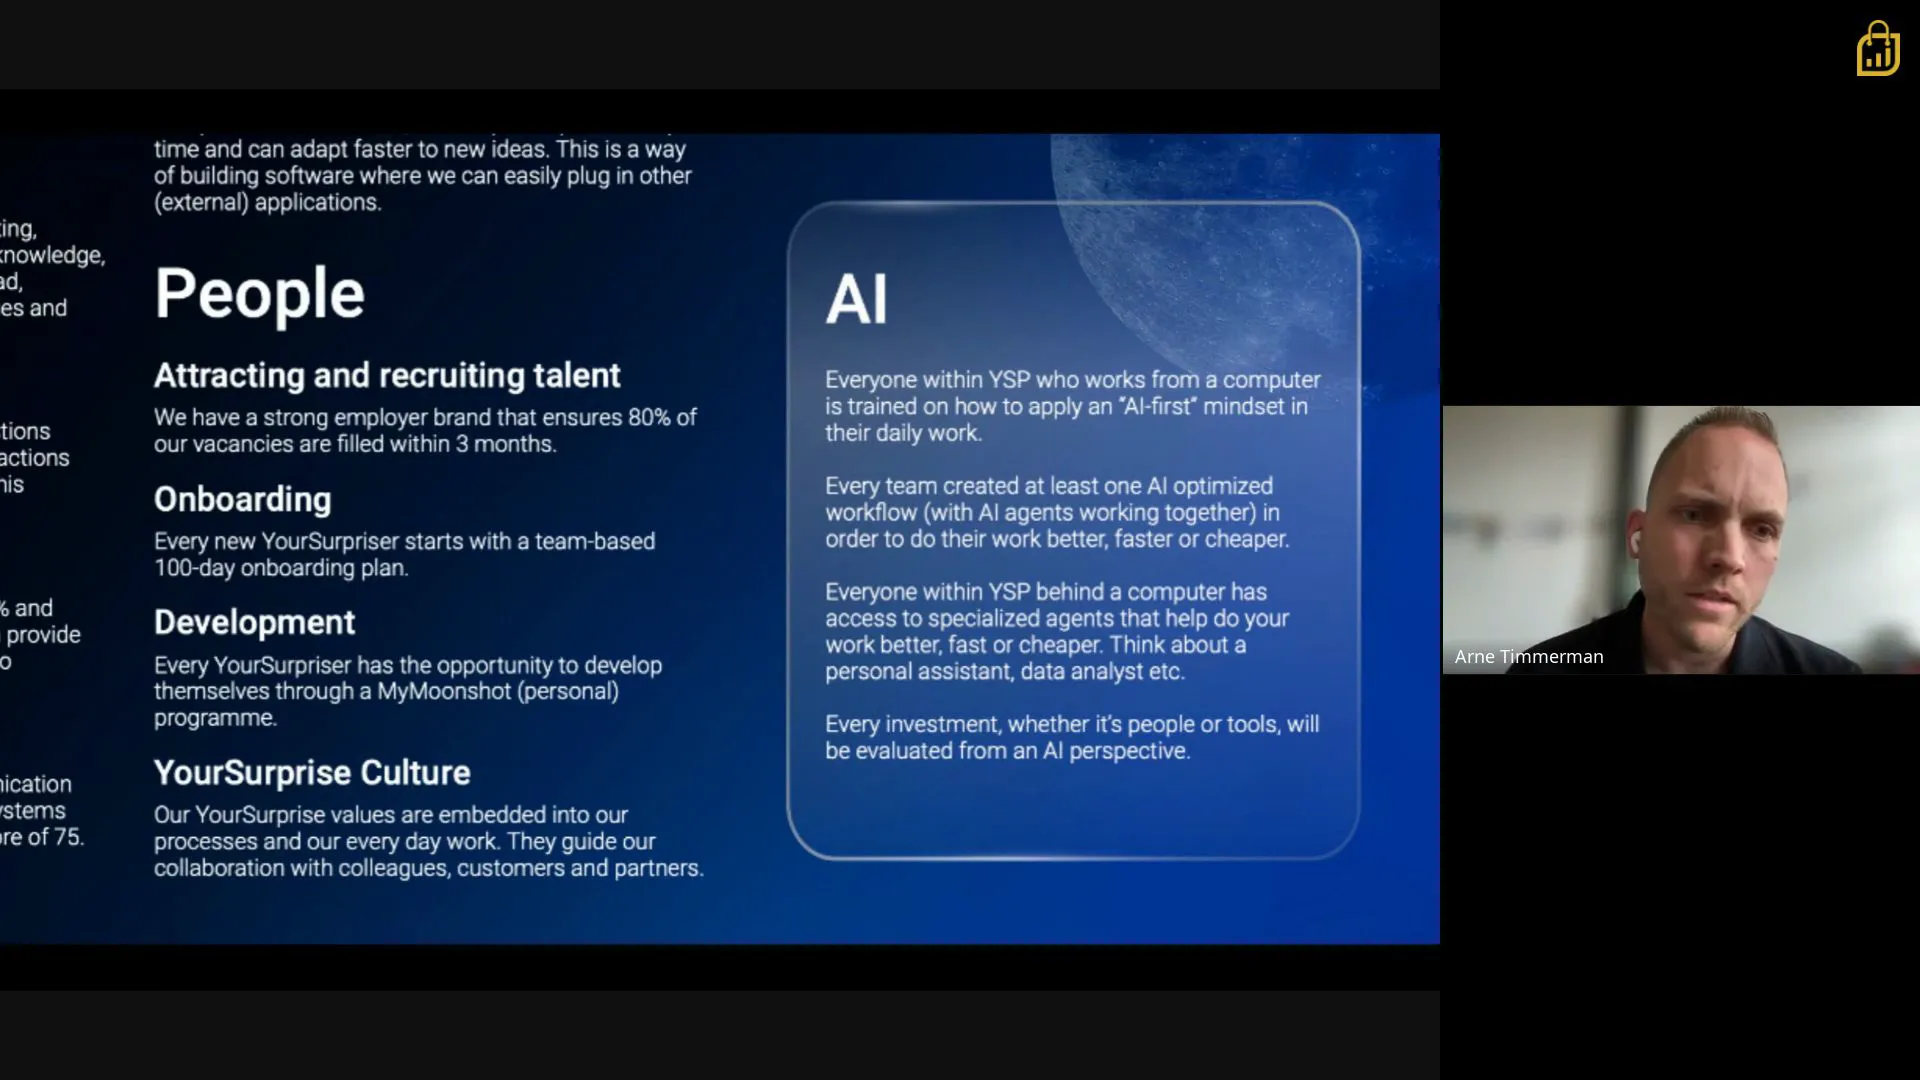
YourSurprise: vier AI-doelen voor het hele bedrijf
Arne Timmerman, YourSurprise
Vier bedrijfsbrede AI-doelen, zo pakt YourSurprise het aan
 Duur 0:42
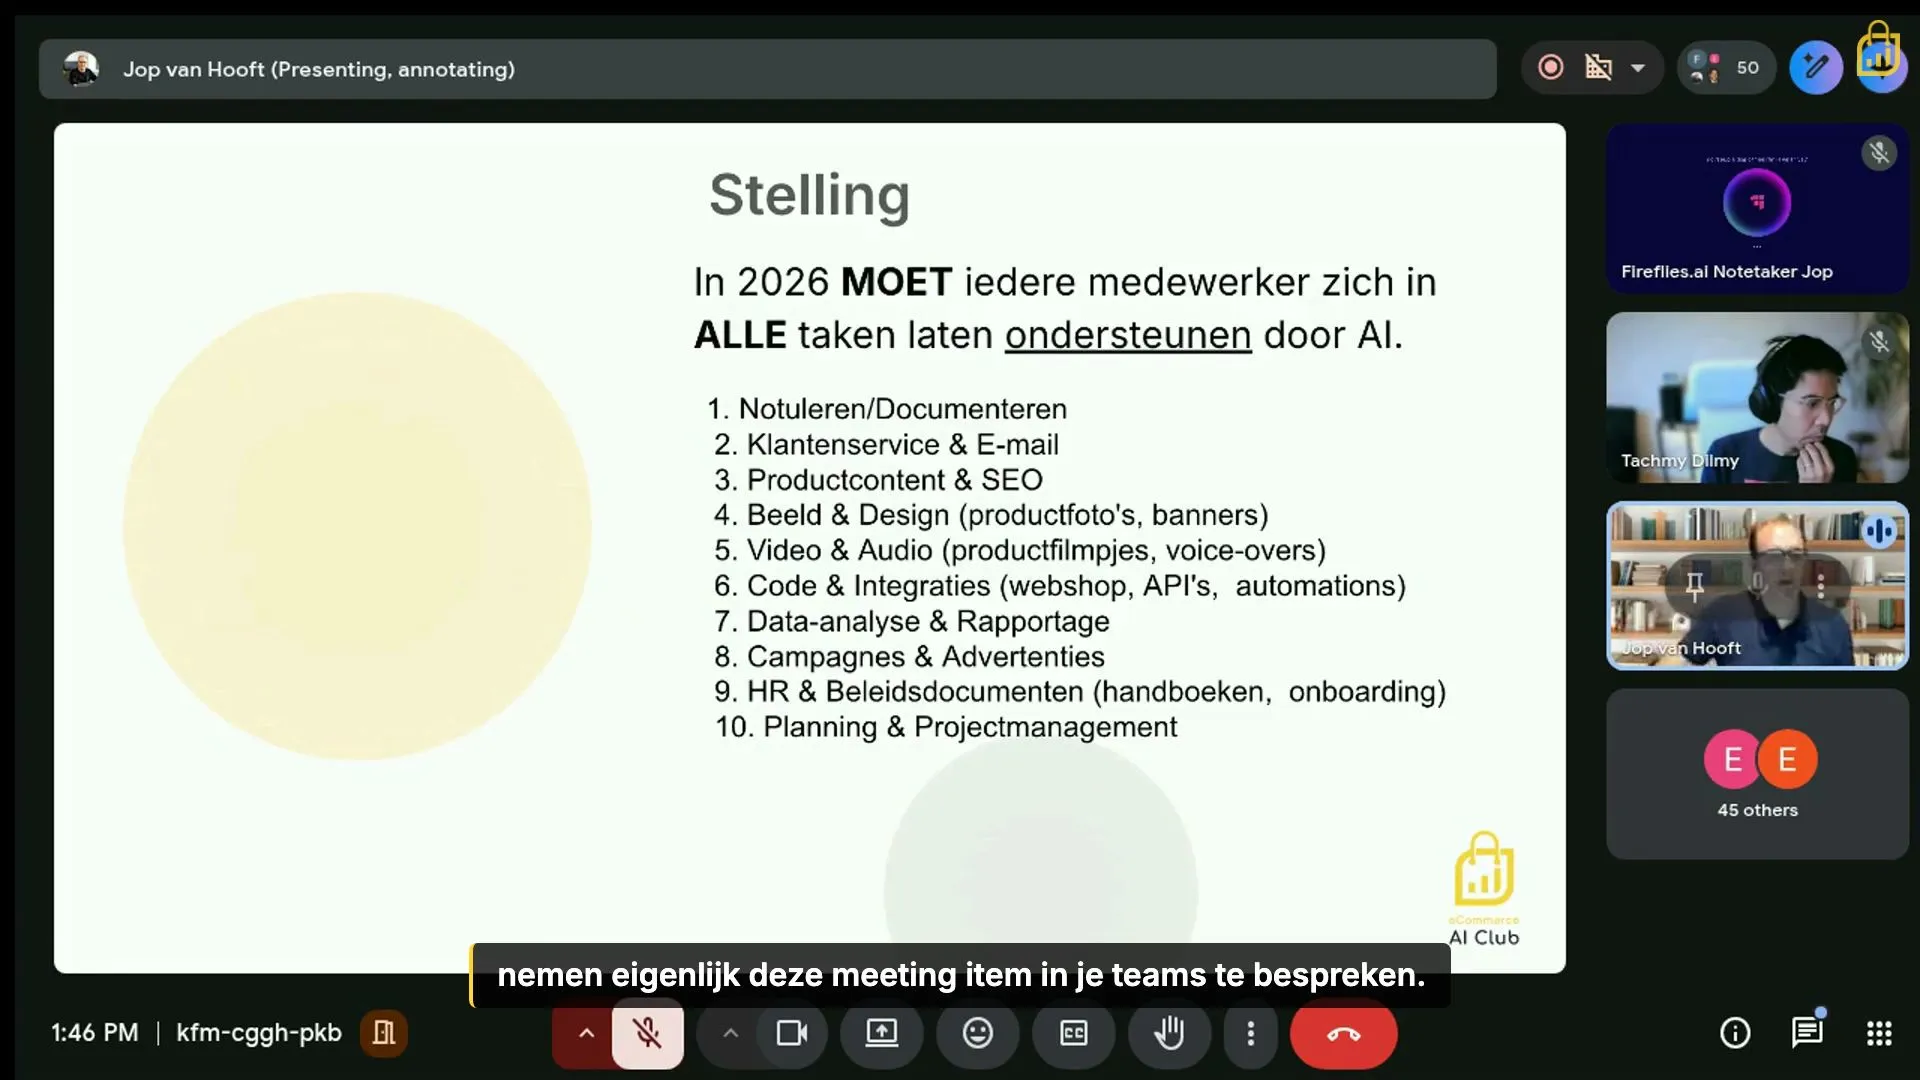
Stelling: iedere medewerker moet AI gebruiken in 2026
Jop van Hooft, eCommerce AI Club
In 2026 moet iedere medewerker AI gebruiken, in 2027 stuur je een team van AI agents aan