AI-vertalingen met een glossary en tone of voice
Steven Emmink, Veneta
Uit de sessie: AI Champion meeting feb 2026
In de AI Champion-meeting van februari 2026 vertelt Steven Emmink van Veneta, een webwinkel in raamdecoratie op maat, hoe hij een eigen vertaaltool bouwt. Je hoort hoe een glossary en een tone of voice de woordkeuze vastleggen, welke modellen hij test en hoe collega's de kwaliteit bewaken.
Voor wie: Je vertaalt productcontent met AI naar nieuwe markten en wilt je vaktermen consistent houden.
Waarom dit ertoe doet
Een webshop die naar een nieuw land gaat, moet honderden productpagina's, filters en hulpteksten vertalen. Een taalmodel vertaalt vlot, maar kiest zijn eigen woorden. Bij Veneta wordt 'houtlook' dan 'wood-like', terwijl de branche 'faux wood' zegt. Dat raakt je vindbaarheid, je filters en de herkenning bij de klant. Veneta verkoopt volgens de eigen site in Nederland, België en Denemarken en heeft meer dan 5,8 miljoen ramen bekleed. Een glossary met vaste vertalingen en een beschreven tone of voice zijn goedkope maatregelen die elke vertaling consistent maken. Steven combineert dat met een score van een tweede model en een controle door collega's die de taal spreken.
Belangrijkste inzichten
- Een taalmodel kiest eigen woorden; bij Veneta werd houtlook wood-like in plaats van faux wood.
- Veneta stuurt de vertaling met een tone of voice en een glossary met vaste termen in de prompt.
- De tool draaide op GPT-4.1 (april 2025); GPT-5.2 (11 december 2025) is volgens Steven trager maar beter gestructureerd.
- Kwaliteit wordt deels gescoord door een model en gecontroleerd door collega's die de taal spreken, met iteratieve verbeteringen.
- Veneta verkoopt volgens de eigen site in 3 landen: Nederland, België en Denemarken.
Waarom een model je vaktermen verandert
Een taalmodel kiest per zin de meest waarschijnlijke formulering. Voor algemene tekst werkt dat goed. Steven Emmink ziet dat de modellen 'best wel goed' vertalen, maar een eigen voorkeur voor woorden hebben. In een vakgebied als raamdecoratie heeft een webshop termen die vast moeten liggen. Zijn voorbeeld is houtlook: het model maakt er wood-like van, Veneta wil faux wood. Wordt dat per pagina anders vertaald, dan klopt je assortiment niet meer met je filters en zoekwoorden.
Tone of voice en glossary in de prompt
Veneta geeft het model twee dingen mee. Een tone of voice beschrijft de schrijfstijl: hoe formeel, hoe lang de zinnen, welke aanspreekvorm. Een glossary is een lijst met bronwoorden en de vertaling die altijd gebruikt moet worden. Zo dwing je af dat dezelfde term overal hetzelfde heet. Hetzelfde principe kennen vertaaltools als DeepL en vertaalbureaus als termbase. Het verschil is dat je het hier zelf in de instructie van je eigen tool zet, zodat je het per taal kunt beheren.
Modelkeuze en snelheid
Steven testte verschillende GPT-modellen. Ten tijde van de sessie draaide de tool op GPT-4.1, dat OpenAI in april 2025 uitbracht en inmiddels als verouderd markeert. Hij had net toegang tot GPT-5.2, dat OpenAI op 11 december 2025 lanceerde. Dat model is volgens hem trager, maar geeft beter gestructureerde antwoorden. Hij wil het nog testen voor vertalingen. Op een tip uit de chat over Claude zegt hij later dat wisselen van model vooral 'een endpoint switchen' is. De basis moet eerst staan.
Kwaliteit bewaken met score en mens
Jop van Hooft vraagt of er een feedbackloop in zit, waarbij model A vertaalt en model B een score van 0 tot 10 geeft met verbeterpunten. Veneta doet dat deels. Daarnaast controleren collega's die de doeltaal spreken de teksten, en de prompt wordt stap voor stap verbeterd tot de vertalingen goed genoeg zijn om te gebruiken. Dat is een gangbare aanpak: een model als beoordelaar vangt grove fouten, een moedertaalspreker beoordeelt toon en vakjargon. Steven noemt geen percentages of tijdwinst; die zijn er in de sessie niet. Wil je het zelf proberen, begin dan klein: kies een taal, bouw de glossary uit de termen die klanten in je filters zien en laat een collega vijftig zinnen nalezen voordat je de rest vertaalt.
Probeer dit deze week
- Maak een glossary van je 30 belangrijkste vaktermen en filterwaarden met per taal de vaste vertaling.
- Schrijf je tone of voice in 5 regels en zet die samen met de glossary in je vertaalprompt.
- Laat 20 vertaalde productteksten door een moedertaalspreker beoordelen en noteer welke termen afwijken.
Begrippen
- Glossary
- Lijst met vaste vertalingen van vaktermen die het model altijd moet gebruiken.
- Tone of voice
- Beschrijving van de schrijfstijl van een merk: toon, aanspreekvorm en zinslengte.
- Faux wood
- Engelse branchenaam voor jaloezieën met een houtlook van kunststof.
- Feedbackloop
- Een tweede stap die de uitkomst beoordeelt en verbeterpunten teruggeeft aan de eerste stap.
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
Daarnaast zijn we ook bezig met vertalingen. Dus ik ben bezig met een vertaal tool te maken, zodat we onze content makkelijk kunnen vertalen naar andere talen, voor onder andere bijvoorbeeld Deens of Engels. En in de tussentijd zijn we ook bezig met het verbeteren van de chatbots met bijvoorbeeld bronaanlevering, bewijs voor hetgene wat ze ook daadwerkelijk zeggen. Dus ze kunnen duidelijk zien, oké, hier baseer je je antwoord op. En al die andere kleine nitpickjes, maar wel belangrijke dingen zoals prompt refactoring en integraties met andere platformen. [onverstaanbaar] En bijvoorbeeld naar het deenstvertalen, hebben jullie ook deenstalige collega's in dienst, of partijen waarmee we samenwerken, die dat ook wat meer kunnen controleren voor je? Want ik ben heel nieuwsgierig, wat de kwaliteit is van de vertalingen die je momenteel ervaart, en waar je tegenaan loopt daarin. Ja, klopt. Dus wat we eigenlijk hebben gezien, is dat we op dit moment best wel goed zijn in het vertalen naar een andere taal. Alleen ze zijn wel best wel geneigd om een bepaalde formulering of een bepaalde woordkeuze te hebben. Alleen in ons, ik noem het, vakgebied hebben wij ook onze eigen set met termen die wij gewoon ergens in willen hebben. Dus wat we dan ook doen is we geven een tone of voice mee dat eigenlijk aangeeft van hé, we willen dat je teksten genereert in dit soort stijl. En tegelijkertijd geven we ook een glossary mee, waarbij we eigenlijk zeggen, als we dit soort woorden hebben, dit willen we dan ook echt zo geformuleerd hebben in plaats van dat je bijvoorbeeld... Nou, bijvoorbeeld we hebben houtlook. En zo'n LLM zouden er bijvoorbeeld wood-like van kunnen maken, maar dat willen wij niet. We willen dat het faux wood wordt. [onverstaanbaar] Het is belangrijk dat wij dat consistent hebben. En ook in die vertaling. Dus dat zijn eigenlijk de dingen die wij dan moeten doen. Zodat het ook goed gebeurt. Ja, precies. En nog bepaalde modellen die daar beter in scoren dan andere? Ja, wat wij hebben gedaan is, we hebben heel veel GPT-modellen getest. En gekeken van oké, hoe goed zijn ze hierin? Op dit moment zitten we op de 4.1, GPT-4.1. Sinds kort hebben we ook toegang tot 5.2, die ook heel goed zijn. Die is wat trager, maar daarvoor in plaats krijg je wel een veel beter gestructureerd antwoord. Dus die zal ook wel beter zijn voor vertaal, dus je moet toch nog even testen. Top. En bouw je ook al feedback loops in? Dus dat je de teksten weer... AI A maakt de tekst en AI B geeft er een score aan tussen de 0 en de 10 hoe goed die is. Of die heeft suggesties om het weer te verbeteren. [onverstaanbaar] Ja, eigenlijk wat wij doen is we laten het vertalen. Deels laten we... We scoren deels of het antwoord is, of het maar goed is. Maar daarnaast kijken we ook via onze collega's die het ook spreken... die checken dan na of het ook qua kwaliteit ook geschikt is. En iteratief verbeteren wij dan bijvoorbeeld dat we dan de vertalingen op een goed genoeg niveau krijgen, zodat het ook gebruik kan worden.
Spreker: Steven Emmink, Veneta
Bronnen
Meer over Productdata & Feeds
 Duur 1:39
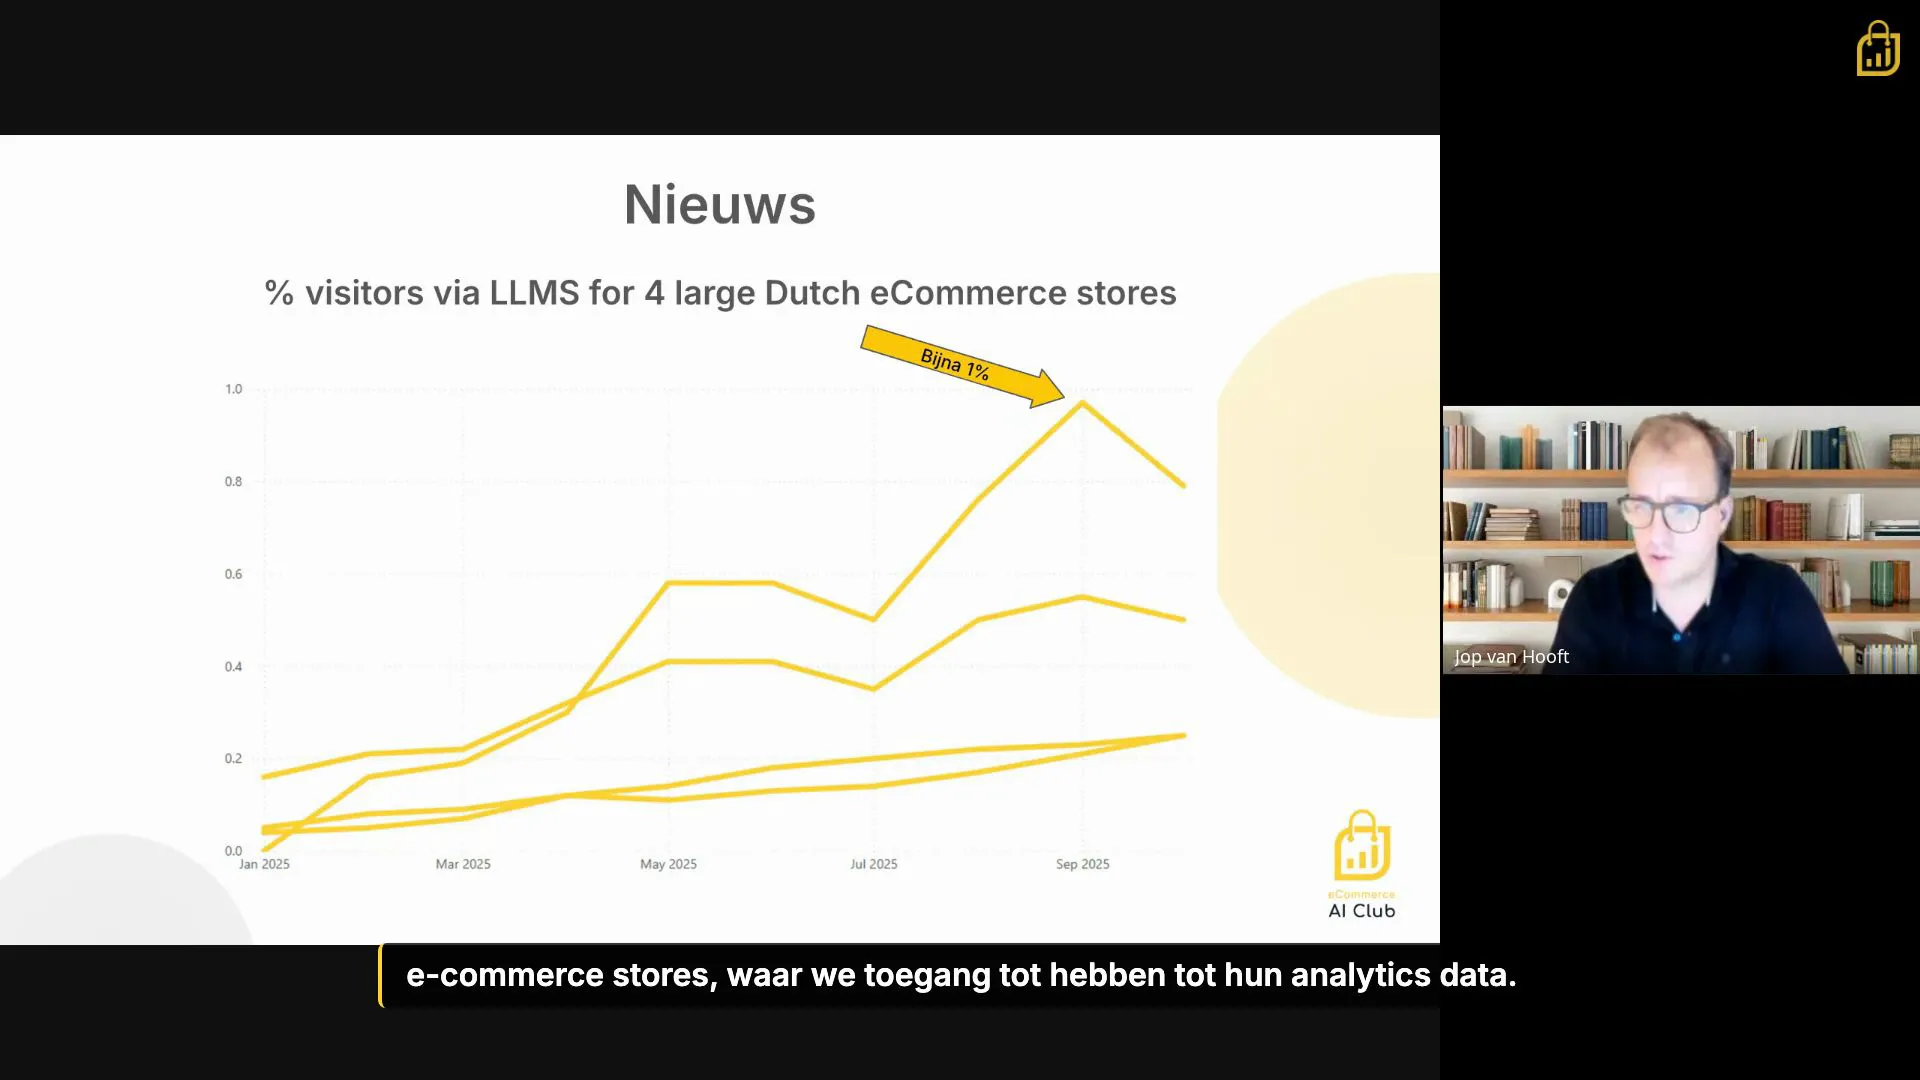
Hoeveel verkeer komt via LLMs bij Nederlandse webshops?
Jop van Hooft, eCommerce AI Club
Slechts 1% van je websiteverkeer komt via LLMs, maar het groeit exponentieel
 Duur 0:40
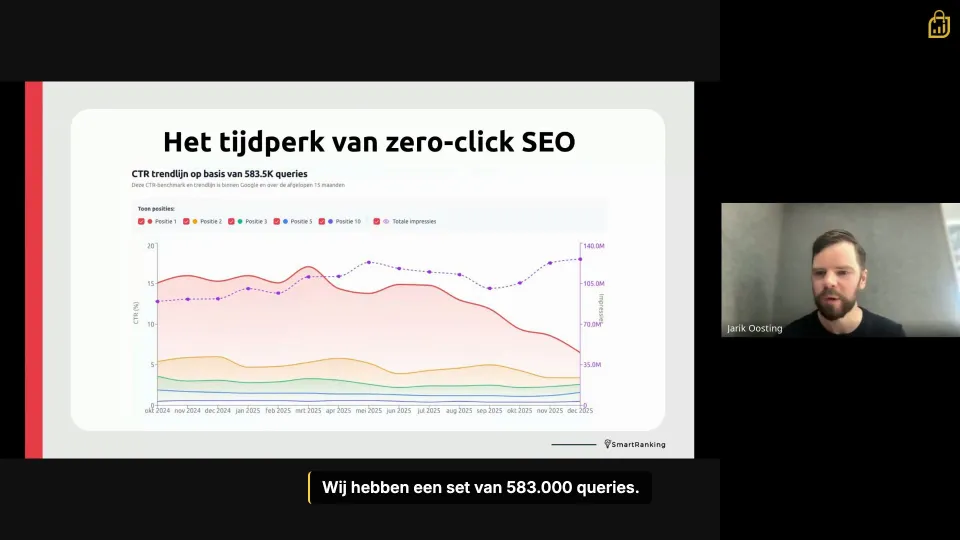
Zero-Click SEO
Jarik Oosting, Smart Ranking
De CTR voor positie 1 in Google is met meer dan de helft gedaald
 Duur 0:41
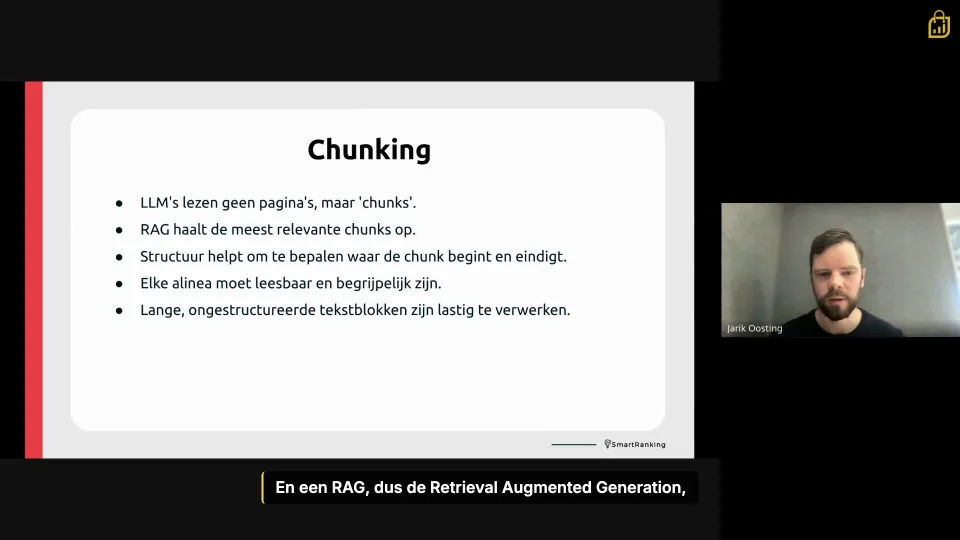
Zo leest een LLM jouw website
Jarik Oosting, Smart Ranking
Een LLM leest niet je hele pagina, alleen de relevante chunks