Welke AI-bots blokkeer je in robots.txt?
Tachmy Dilmy, eCommerce AI Club
Uit de sessie: Maandelijkse Meeting mrt 2026
Na het verhaal van Jarik Oosting over de LLM-ready website laat Tachmy Dilmy de uitkomst zien van een eigen analyse: wat doen 250 Nederlandse webshops met AI-bots in hun robots.txt? Je ziet de cijfers, een paar bekende namen en een indeling in drie soorten bots met per soort een advies.
Voor wie: Je wilt bepalen welke AI-bots je webshop mogen bezoeken zonder je zichtbaarheid in AI-antwoorden te verliezen.
Waarom dit ertoe doet
Of ChatGPT, Gemini of Perplexity jouw producten kan tonen, hangt mede af van welke bots je binnenlaat. Uit de analyse van de club blijkt dat 76,7% van de 250 onderzochte webshops geen enkele AI-bot blokkeert, 2,0% alles blokkeert en maar 6,0% onderscheid maakt tussen trainingsbots en zoekbots. Cloudflare meet dat bijna 80% van het AI-crawlen bedoeld is voor training. In juli 2025 kwamen er volgens Cloudflare 1.091 pagina-opvragingen van OpenAI op één doorverwijzing, tegen 5,4 bij Google. Trainingsbots kosten serverlast en leveren weinig bezoekers op. Zoekbots kunnen je juist in een AI-antwoord met bronvermelding zetten.
Belangrijkste inzichten
- Van 250 Nederlandse webshops blokkeert 76,7% geen enkele AI-bot, 2,0% blokkeert alles en 6,0% maakt onderscheid.
- Trainingsbots zoals GPTBot en ClaudeBot halen content op voor modeltraining; zoekbots zoals OAI-SearchBot zetten je in AI-antwoorden met bronvermelding.
- Cloudflare mat in juli 2025 1.091 pagina-opvragingen per doorverwijzing bij OpenAI tegen 5,4 bij Google.
- Amazon.nl blokkeerde volgens de slide 18 AI-bots; op 11 november 2026 stond ook ClaudeBot daar op Disallow.
- Google-Extended raakt Google Search niet, maar regelt naast training ook grounding in Gemini.
Wat robots.txt is
Robots.txt is een tekstbestand in de hoofdmap van je website waarin je per bot aangeeft welke pagina's die niet mag bezoeken. De standaard staat sinds september 2022 beschreven in RFC 9309. Daarin staat dat de regels geen vorm van toegangsbeveiliging zijn: het is een verzoek dat crawlers 'gevraagd worden te respecteren'. Tachmy zegt het in de clip ook zo: het is een vraag aan de bot of die zich eraan wil houden. Grote partijen als OpenAI, Google en Anthropic publiceren de namen van hun bots, zodat je ze apart kunt aanspreken.
Drie soorten AI-bots
De slide deelt AI-bots in drie groepen. De eerste noemt Tachmy de 'vampire trainers': GPTBot, ClaudeBot, Google-Extended, CCBot en Bytespider halen content op om modellen te trainen. Het advies is die te blokkeren. De tweede groep zijn zoek- en citatiebots zoals OAI-SearchBot, PerplexityBot en Claude-SearchBot. Die tonen je producten in AI-zoekresultaten met een bronvermelding en die laat je toe. De derde groep haalt een pagina op op het moment dat een gebruiker erom vraagt, zoals ChatGPT-User, Claude-Web en Perplexity-User. Ook die laat je toe. OpenAI bevestigt het onderscheid: GPTBot is voor training, OAI-SearchBot bepaalt of je in ChatGPT-zoekresultaten verschijnt, en bij ChatGPT-User gelden robots.txt-regels mogelijk niet omdat een gebruiker de actie start. Let bij Google-Extended op: volgens Google heeft het geen invloed op Google Search, maar het regelt naast training ook of je content wordt gebruikt voor grounding in Gemini.
De cijfers uit de analyse
Van de 250 Nederlandse webshops blokkeert 76,7% geen enkele AI-bot, hanteert 6,0% de aanpak 'training blokkeren, zoeken toelaten' en blokkeert 2,0% alles. Volgens de slide is Amazon.nl het strengst met 18 geblokkeerde AI-bots, terwijl Coolblue, Zalando en IKEA geen enkele AI-bot blokkeren. Tachmy zegt dat Amazon alleen Claude toelaat vanwege een strategisch partnership. Amazon heeft inderdaad in totaal 8 miljard dollar in Anthropic, de maker van Claude, geïnvesteerd. Maar toen wij op 11 november 2026 de robots.txt van amazon.nl bekeken, stonden ClaudeBot, Claude-SearchBot en Claude-User daar ook op 'Disallow'. Dat kan na maart veranderd zijn; houd er rekening mee dat zo'n bestand regelmatig wijzigt.
Hoeveel trainingsbots teruggeven
Op de slide staat een verhouding van 198 gecrawlde pagina's per doorverwijzing voor OpenAI, tegen 6 voor Google. Dat precieze getal hebben we niet teruggevonden. Cloudflare publiceert zelf de crawl-to-refer ratio: hoeveel pagina's een platform ophaalt tegenover hoe vaak het bezoekers stuurt. In juli 2025 was dat 38.066 voor Anthropic, 1.091 voor OpenAI, 194,8 voor Perplexity en 5,4 voor Google. De cijfers schommelen sterk per maand en per meetmethode, maar de richting is steeds dezelfde. Tachmy plaatst er wel een kanttekening bij: blokkeer je trainingsbots volledig, dan kom je niet meer in toekomstige trainingsdata. Heb je last van serverbelasting of snelheid, dan is het blokkeren van deze bots volgens hem een logische eerste stap. De club heeft de analyse online gezet, zodat je je eigen domein kunt vergelijken met de rest.
Probeer dit deze week
- Open jouwdomein.nl/robots.txt en noteer welke van de 3 groepen bots je nu blokkeert of toelaat.
- Bespreek met je team of je trainingsbots (GPTBot, ClaudeBot, CCBot) wilt blokkeren en zoekbots (OAI-SearchBot, PerplexityBot, Claude-SearchBot) wilt toelaten, en leg de keuze vast.
- Kijk in je serverlogs van de afgelopen 7 dagen hoeveel verzoeken van AI-bots komen en welke bots de meeste last veroorzaken.
Begrippen
- robots.txt
- Een tekstbestand op je website waarin je bots vraagt bepaalde pagina's niet te bezoeken.
- Trainingsbot
- Een crawler die webpagina's ophaalt om AI-modellen mee te trainen, zoals GPTBot of ClaudeBot.
- Zoekbot
- Een crawler die pagina's ophaalt om ze in AI-zoekresultaten te tonen, meestal met een link naar de bron.
- Crawl-to-refer ratio
- Het aantal pagina's dat een platform ophaalt per bezoeker die het naar je site doorstuurt.
Verdiep je in de gids
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
We hebben zelf een korte analyse gedaan naar 250 verschillende webshops, wat zij doen met hun robots.txt. Misschien een heel suf onderwerp aan de ene kant, tegelijkertijd sluit het wel een beetje aan wat er allemaal besproken is over de LLM-ready website. Robots.txt is een bestand wat je op je website plaatst waar AI-crawlers naar kijken, maar ook de Google-crawler en eigenlijk allerlei bots die het web afgaan voor interessante content. Je ziet dat er steeds meer... De robots betekent steeds die wordt eigenlijk ook gebruikt door al die AI-agents. In principe kijken ze ernaar, is het een vraag aan de bot: zou je je hieraan willen conformeren? Wat we zagen is dat over die 250 Nederlandse webshops, dat meer dan 75% eigenlijk in enkele AI-bot blokkeert. Amazon, die blokkeert alles. Het enige wat ze openlaten is voor Claude om langs te komen, omdat ze daar een strategisch partnership mee hebben. Maar zij blokkeren ook ChatGPT en dat soort zaken. Je ziet de Coolblue's al aan de IKEA bijvoorbeeld, die blokkeren helemaal niemand. En eigenlijk zou je hiervoor een keuze kunnen maken dat je de grote trainingbots bijvoorbeeld blokkeert, maar de zoekbots, die dus op de user intent, die op het laatste moment dus zo'n zoekopdracht doen om het RAG aan te vullen, waar ik net over hadden, dat je die dan wel toelaat. Want wat je namelijk ziet, er is volgens mij één slide die ik erbij moet pakken, er zijn van die, ze worden een beetje de vampire trainers genoemd, de GPT-bots, de Claude-bots en de Google-bots, die dan langskomen, die eigenlijk alleen maar puur voor het AI-model te trainen zijn. En wat je ziet is dat zij 198 pagina's ongeveer crawlen, voordat ze een keer eens een referral doen naar jou toe als merk. zijn. Terwijl Google dat eigenlijk op 1 op 6 doet. Voor iedere 6 pagina's niet zo crawlen, krijg je één bezoeker terug. Om ze volledig te blokkeren is natuurlijk ook weer een ding en dan kom je eigenlijk nooit meer in die trainingsdata voor. Maar mocht je nou met verkeerissues zitten, met snelheid, dan kan je ook altijd kijken naar dit soort bots om die eventueel tegen te houden vanuit je robots.txt. Oké.
Spreker: Tachmy Dilmy, eCommerce AI Club
Bronnen
- rfc-editor.org/rfc/rfc9309.html
- developers.openai.com/api/docs/bots
- developers.google.com/search/docs/crawling-indexing/google-common-crawlers
- blog.cloudflare.com/crawlers-click-ai-bots-training/
- nbcnews.com/business/business-news/amazon-invest-another-4-billion-anthropic-openais-biggest-rival-rcna181360
- amazon.nl/robots.txt
Meer over AI Agents & Shopping
 Duur 0:48
Desktop Commander, Claude ruimt je bureaublad op
Jop van Hooft, eCommerce AI Club
Claude ruimt zelfstandig je bureaublad op, en controleert zichzelf
 Duur 1:35
MCP: koppel al je tools aan AI
Jop van Hooft, eCommerce AI Club
Na een jaar MCP kun je nu Shopify, Moneybird en Gmail aan je AI koppelen
 Duur 1:46
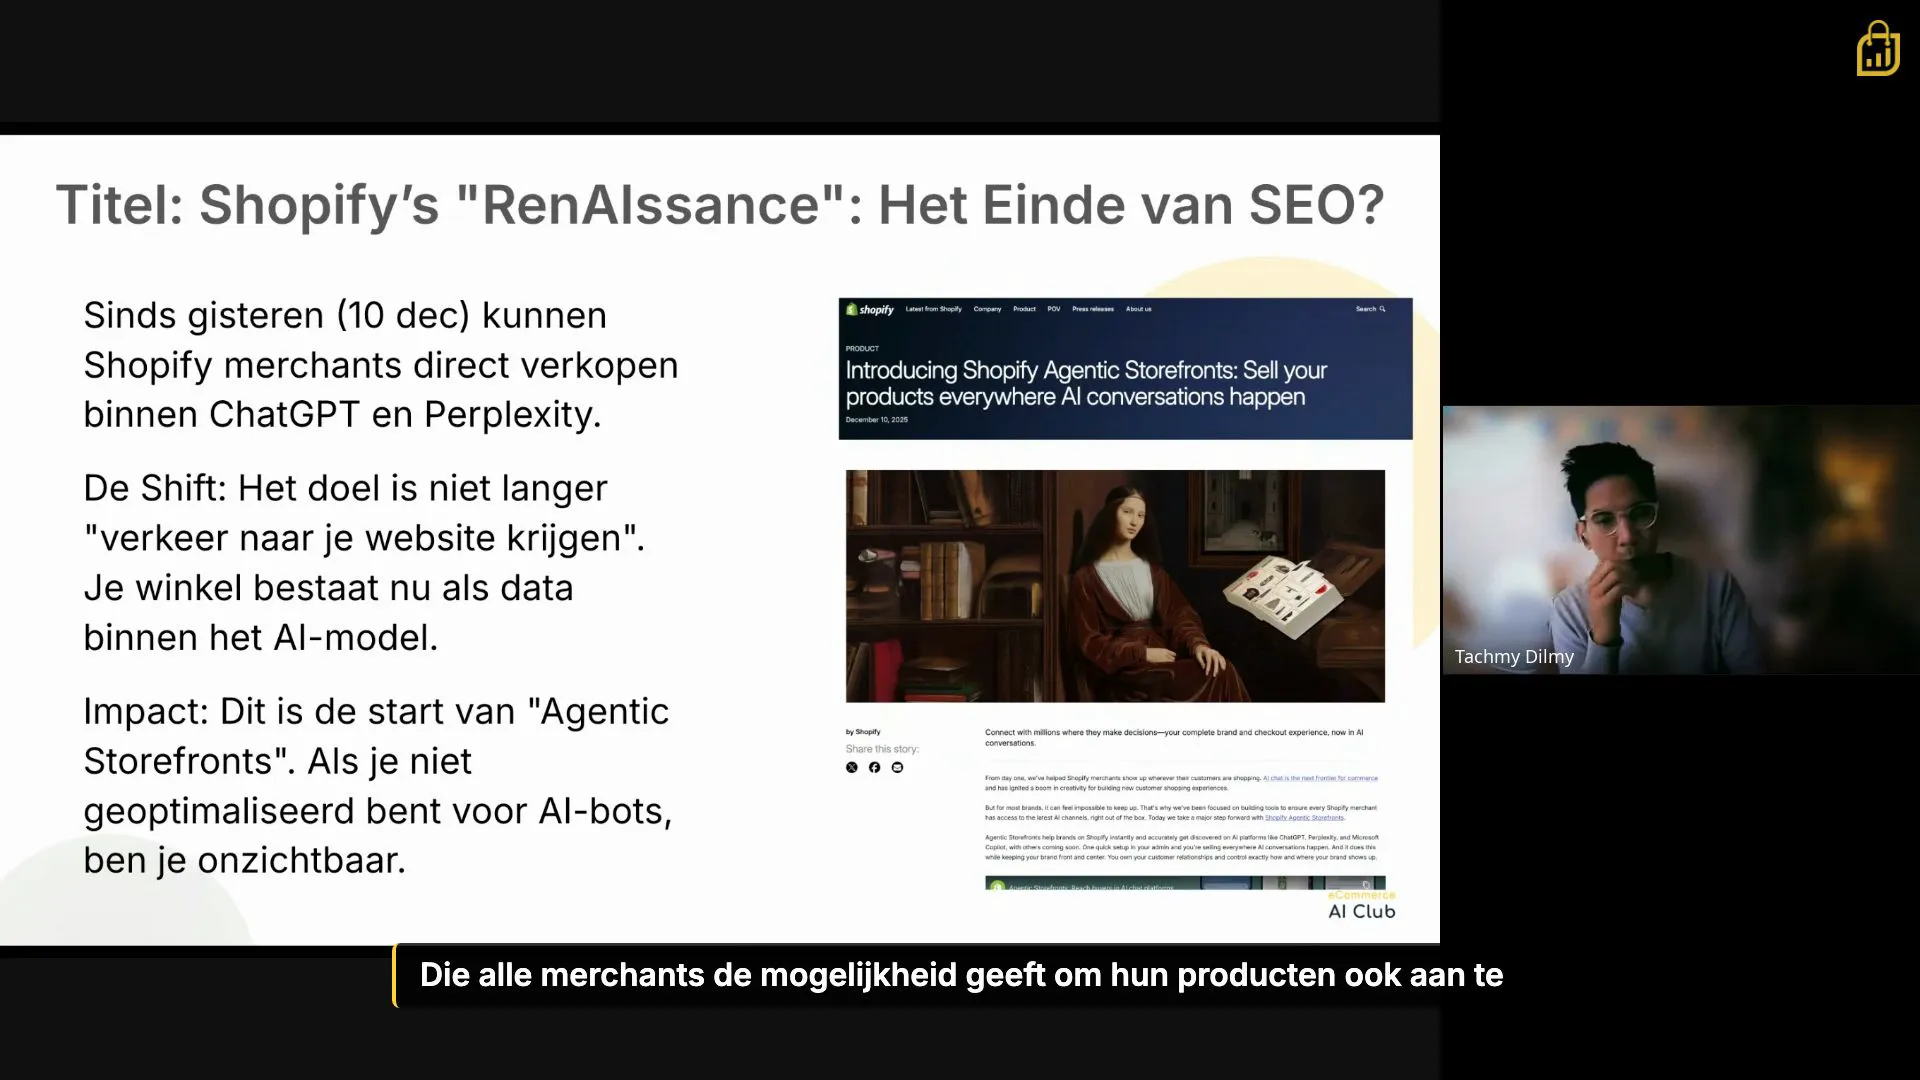
Shopify Agentic Storefronts: het einde van SEO?
Tachmy Dilmy, eCommerce AI Club
Shopify opent je checkout voor AI-bots, is dit het einde van je eigen webshop?