Sleak-vragen: chats nakijken en wanneer naar een mens
Tom Rijnen, Sleak
Uit de sessie: Maandelijkse Update okt 2026
Na de PLNTS-case stelt Jop van Hooft vragen aan Tom Rijnen van Sleak. Hoe kijk je gesprekken van de AI-chat achteraf na en stuur je bij? En hoe bepaal je wanneer de chat een klant doorzet naar een formulier of een medewerker? Tom legt uit waarom Sleak het model niet traint en wat hij in plaats daarvan adviseert.
Voor wie: Je een AI-chat gebruikt of overweegt en wilt weten hoe je bijstuurt en wanneer je naar een mens doorzet.
Hetzelfde moment
- Clip van 1:43 min: Train je chatbot niet, zet je bronnen op orde
Waarom dit ertoe doet
Wie een AI-chat inzet, wil weten hoe je fouten achteraf herstelt. Tom zegt dat trainen van een model snel tegenstrijdige uitkomsten geeft, en dat je beter de bron aanpast. Daarnaast is doorzetten naar een mens een afweging tussen klantvriendelijkheid en de werkdruk van je team. Tom noemt dat een spectrum waarop je zelf een plek kiest, en raadt aan snel live te gaan en dan te leren.
Belangrijkste inzichten
- In de Sleak-inbox zie je gesprekken, uitgevoerde acties en welke bronnen boven kwamen; de AI is transparant als receptioniste.
- Sleak traint het model niet per bedrijf; je past de databron aan en maakt zo nodig een nieuw kennisbankartikel.
- Volgens Tom is fine-tunen met handmatige duimpjes per bedrijf een druppel op een gloeiende plaat.
- Wanneer de chat doorzet naar een mens is een spectrum dat je zelf instelt, van vier keer herformuleren tot altijd een mens aanbieden.
- Tom raadt aan snel live te gaan en daarna je instellingen bij te sturen.
Gesprekken nakijken en bijsturen
Jop vraagt of je achteraf kunt zien welke gesprekken er waren en kunt bijsturen. Tom laat de inbox zien: de AI is daar de receptioniste, en Sleak is transparant dat het AI is. Je ziet wanneer acties zijn uitgevoerd en welke informatie uit de zoekmachine naar boven kwam, bijvoorbeeld pagina's over kapotte planten en het retourbeleid. De gesprekken worden kwalitatief gelogd. Kwantitatief zijn er analytics, insights en agents die helpen.
Waarom Sleak het model niet traint
Tom zegt dat het model trainen snel tegenstrijdige dingen oplevert. Zijn advies: vul het aan in de databron. Zie het als beter structureren van de zoekmachine, zodat de volgende keer de juiste informatie boven komt. Zorg dat er geen dubbelzinnige informatie is en maak zo nodig een nieuw kennisbankartikel. Fine-tunen kan Sleak wel, op basis van tienduizenden geanonimiseerd geanalyseerde gesprekken, om het taalmodel overall te verbeteren. Fine-tunen met handmatige duimpjes omhoog of omlaag per bedrijf is volgens hem een druppel op een gloeiende plaat en mist context.
Wanneer naar een mens of formulier
Op de vraag hoe je bepaalt wanneer de chat doorzet, zegt Tom dat dit programmeerbaar is in een actie. Het is een oneindig spectrum. Aan de ene kant laat je de chat de vraag bijvoorbeeld vier keer herformuleren voordat je doorzet, bij een lage marge en weinig medewerkers. Aan de andere kant stel je bij elke vraag voor dat er een mens beschikbaar kan zijn, ook als de chat wel een antwoord had. Zijn kernadvies: structureer je data goed, ga snel live, leer ervan en zoek je sweet spot.
Probeer dit deze week
- Lees 10 gesprekken van je chat of helpdesk en markeer 3 antwoorden waar de bron onduidelijk of tegenstrijdig was.
- Bepaal na hoeveel pogingen je chat een klant naar een medewerker mag doorzetten en noteer waarom.
Begrippen
- Fine-tunen
- Een bestaand taalmodel bijtrainen op eigen voorbeelden, zodat het anders antwoordt.
- Kennisbank
- De verzameling artikelen en pagina's waaruit een chat zijn antwoorden haalt.
Verdiep je in de gids
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
Goed, dankjewel Tom. Leuk om zo even een kijkje aan de achterkant te krijgen. We hebben wel ruimte voor wat vragen eventueel. Ik ben gewoon brutaal en ik start gewoon zelf met de eerste vraag. Wat ik me heel erg afvraag, is er een mogelijkheid om na afloop terug te kijken wat voor gesprekken er zijn geweest en daar ook eventueel nog op bij te sturen voor future reference. Kijk, op dat moment is het natuurlijk een berichtje verstuurd, maar als je dan denkt van, goh, dit antwoord had net eens anders gemogen of... Nee, zeker. Dus als ik even mijn scherm heel kort ga delen, dat is eigenlijk een hele overzichtelijke inbox in feite, zoals je het kent. Alleen wat je hier ziet is dat eigenlijk altijd AI een soort van de receptioniste is die gewoon gaat kijken. Daar zijn we ook heel transparant over. We zeggen ook altijd van, deze heet het aan jullie, ik heb mezelf niet gemaakt natuurlijk, dat hebben ze zelf gedaan, maar gewoon heel transparant over het feit dat je AI gebruikt. En dan zie je hier gewoon heel netjes wat er gebeurt. Zie je wanneer er acties zijn uitgevoerd. Zie je natuurlijk ook in die zoekmachine van, hé, welke informatie komt nou wanneer naar boven. Dus waar is het op gebaseerd? En dus in dit geval zie je dat hier gewoon pagina's omhoog komen die lijken op artikelen die kapot zijn. En een retourbeleid, dat heeft in dit geval uit die duizenden pagina's gewoon statistisch gezien dezelfde betekenis. En hier log je dus eigenlijk kwalitatief gezien de gesprekken. Anderzijds heb je kwantitatief gezien natuurlijk ook overal analytics en insights en agents die daarbij helpen. Alleen, ik denk dat dit hetgeen is wat jij hierin bedoelt. Ja precies, en je kunt hier nou ook nog aangeven van, goh, ik zag terug dat je in dit gesprek drie tips hebt gegeven, maar tip drie klopte eigenlijk niet helemaal. De volgende keer moet je maar zeggen dat ze beter dit kunnen doen. Dat je daar nog een beetje op kan bijsturen? Ja, ik denk fundamenteel wat wij anders proberen te doen, is dat we heel duidelijk zijn over het feit dat we dus een AI niet gaan trainen. Kijk, trainen van een model, dan ga je hem echt een soort van, dan ga je heel snel ook tegenstrijdige dingen krijgen. En wat wij zeggen is van, als je hem nou wil gaan aanvullen met informatie, doe dat dan gewoon in die databond. Dus in plaats van dat je hem traint, hij traint wel, het systeem wordt beter over tijd. Mensen vinden het fijn om dat metafoorisch te beschrijven. Maar wat wij eigenlijk zeggen is van, zie het meer als het beter structureren van die zoekmachine. Zodat de volgende keer de juiste informatie wordt geraad gelegd. Dus het is meer een soort van aanpakken bij de kern. En dat zorgen ervoor dat die data goed gestructureerd is, zodat die de juiste informatie krijgt. Dat er geen dubbelzinnige informatie is. Maar het trainen ervan, en dat zie je vaak bij andere tools. Wij hebben er echt gezien niet voor gekozen, omdat je dan heel vaak... heel veel tegenstrijdigheden en dubbelzinnigheden krijgt. En dat dat vaak een dubbelzinnige plaat is. Duidelijk. Dus het achterlijke idee is dat je je brondata gewoon op orde hebt. En als die niet staat, hoef je ook niks te kunstelen. Exact. En uiteindelijk, om het maar even te vergelijken met het trainen ervan. Het komt op hetzelfde manier, maak gewoon een nieuw kennisbank artikel in je kennisbank. Alleen zorg er even voor dat je er goed over nadenkt. En we proberen het ook, het is ook vrij contextloos om bijvoorbeeld met duimels omhoog en omlaag te trainen. Wij zeggen van dat fine-tunen van zo'n model, dat kan wel. Dat kunnen wij ook wel doen om het overall taalmodel te optimaliseren op basis van de tienduizenden gesprekken die wij geanonymiseerd analyseren. Alleen het fine-tunen van gesprekken met handmatige plusjes en minnetjes. Op bedrijfsniveau. Dat is gewoon een druppel op een gloeiende plaat. En dan proberen we het liever bij de bron aan te pakken. En het fundamenteel beter te doen eigenlijk. Tof. Is er iemand toevallig die een vraag wil stellen aan Tom? Die geen handen omhoog gaan of niet? Ja Tom, misschien nog net mijn kant een vraag over de breakout. zeg maar naar een of echte medewerker of naar een formulier. Het is denk ik een soort van, in dit geval kon je best wel snel naar een formulier toe gaan. Het is een soort van afweging als customer, contact, verantwoordelijke, stel ik hem heel scherp af, dan krijg ik steeds minder vragen in mijn breakout, wat goed is voor hoeveel minder mensen op mijn afdeling te hebben. Hoe maak je die afweging tussen hoe snel laat je hem zeg maar linksaf naar een human gaan, naar een formulier of helemaal niet? Heb je daar nog wat? Ja, goede vraag. Ik denk de kracht van ons platform is vooral echt de modulariteit en dat is dus waar je ook dus in een actie echt kunt gaan programmeren hoe je wil dat hij, in dit geval wanneer je wil dat hij een mens aanroept. En je kunt het eigenlijk zien als een soort van spectrum. Dus het is eigenlijk een oneindig spectrum waarin je kunt gaan zitten waar je wil. Enerzijds kun je gaan zeggen van hé, herformuleer vier keer je vraag voordat je iemand doorgewijst naar een mens. Nou, wanneer kies je daarvoor? Als je een hele lage marge hebt, heel weinig headcount, niemand goed kunt helpen, dan ben je iets minder klantvriendelijk misschien, dan ga je iets meer de klant eigenlijk moeite laten doen voor het zoeken van het antwoord. Anderzijds heb je aan de andere kant van het spectrum, zou je hier kunnen zeggen van hé, je gaat bij iedere vraag, ongeacht of jij het antwoord wel of niet hebt kunnen geven, stel je voor dat er een mens beschikbaar kan zijn. Dat hoef je niet meteen aan te roepen, maar je stelt het in ieder geval voor. En ja, je gaat ergens in dat spectrum gaan je zitten, dus je kunt dat ook prominent naar voorbrengen, als Dat was het verkeerde knopje van Tom, denk ik. Ik denk dat hij over enkele seconden terugkomt. Dan ben je weer Tom. We horen jou nog niet. Je bent nog gemute. Kijk, nu wel dan. Ja, nu wel zeker. Je klikt de verkeerde website aan. Maar als je bijvoorbeeld gaat kijken naar een soort gelijkbedrijf, dan werkt dat eigenlijk op een manier waarin ze zeggen van dat ze ook dat heel prominent naar voren kunnen brengen buiten dat tijdens het chat gebeurt. Dus ik denk dat de kern van het verhaal is structureer je data goed aan de achterkant stel het in zoals je zelf wil. Ik zeg altijd vooral, ga vooral snel live omdat wij werken met die zoekmachine en dat eigenlijk omdat wij hele simpele vragen stellen aan een AI en hem niet trainen. Probeer vooral gewoon een basis neer te zetten. Ga live en zie dan dat die misschien meer kan automatiseren dan kon. maar ga er dan van leren en ga dan op een gegeven moment een sweet spot vinden waarin de instructies gewoon passen bij hoe jij het in wil zetten en dat is afhankelijk van heel veel factoren in hoeverre jij wel of niet mensen achter de hand wil hebben en hoe prominent je dat naar voren wil brengen nice, dank voor de uitleg leuk Tom, dankjewel dat je onze kijkt zou laten nemen in PLNTS.com die daar draait een mooi praktijkvoorbeeld van AI in Ecoverse dan pak ik er vanaf hier over succes dankjewel
Spreker: Tom Rijnen, Sleak
Meer over Klantenservice & Sales
 Duur 1:09
Salesforce: 100 miljoen leads eindelijk opvolgen
Tachmy Dilmy, eCommerce AI Club
100 miljoen leads in 26 jaar nooit opvolgd, tot AI kwam
 Duur 1:37
Waarom AI niet kan verkopen zonder domeinkennis
Marja Silvertant, Aiden
LLMs zijn getraind op 30 jaar internet zonder verkoopadvies, dat merk je
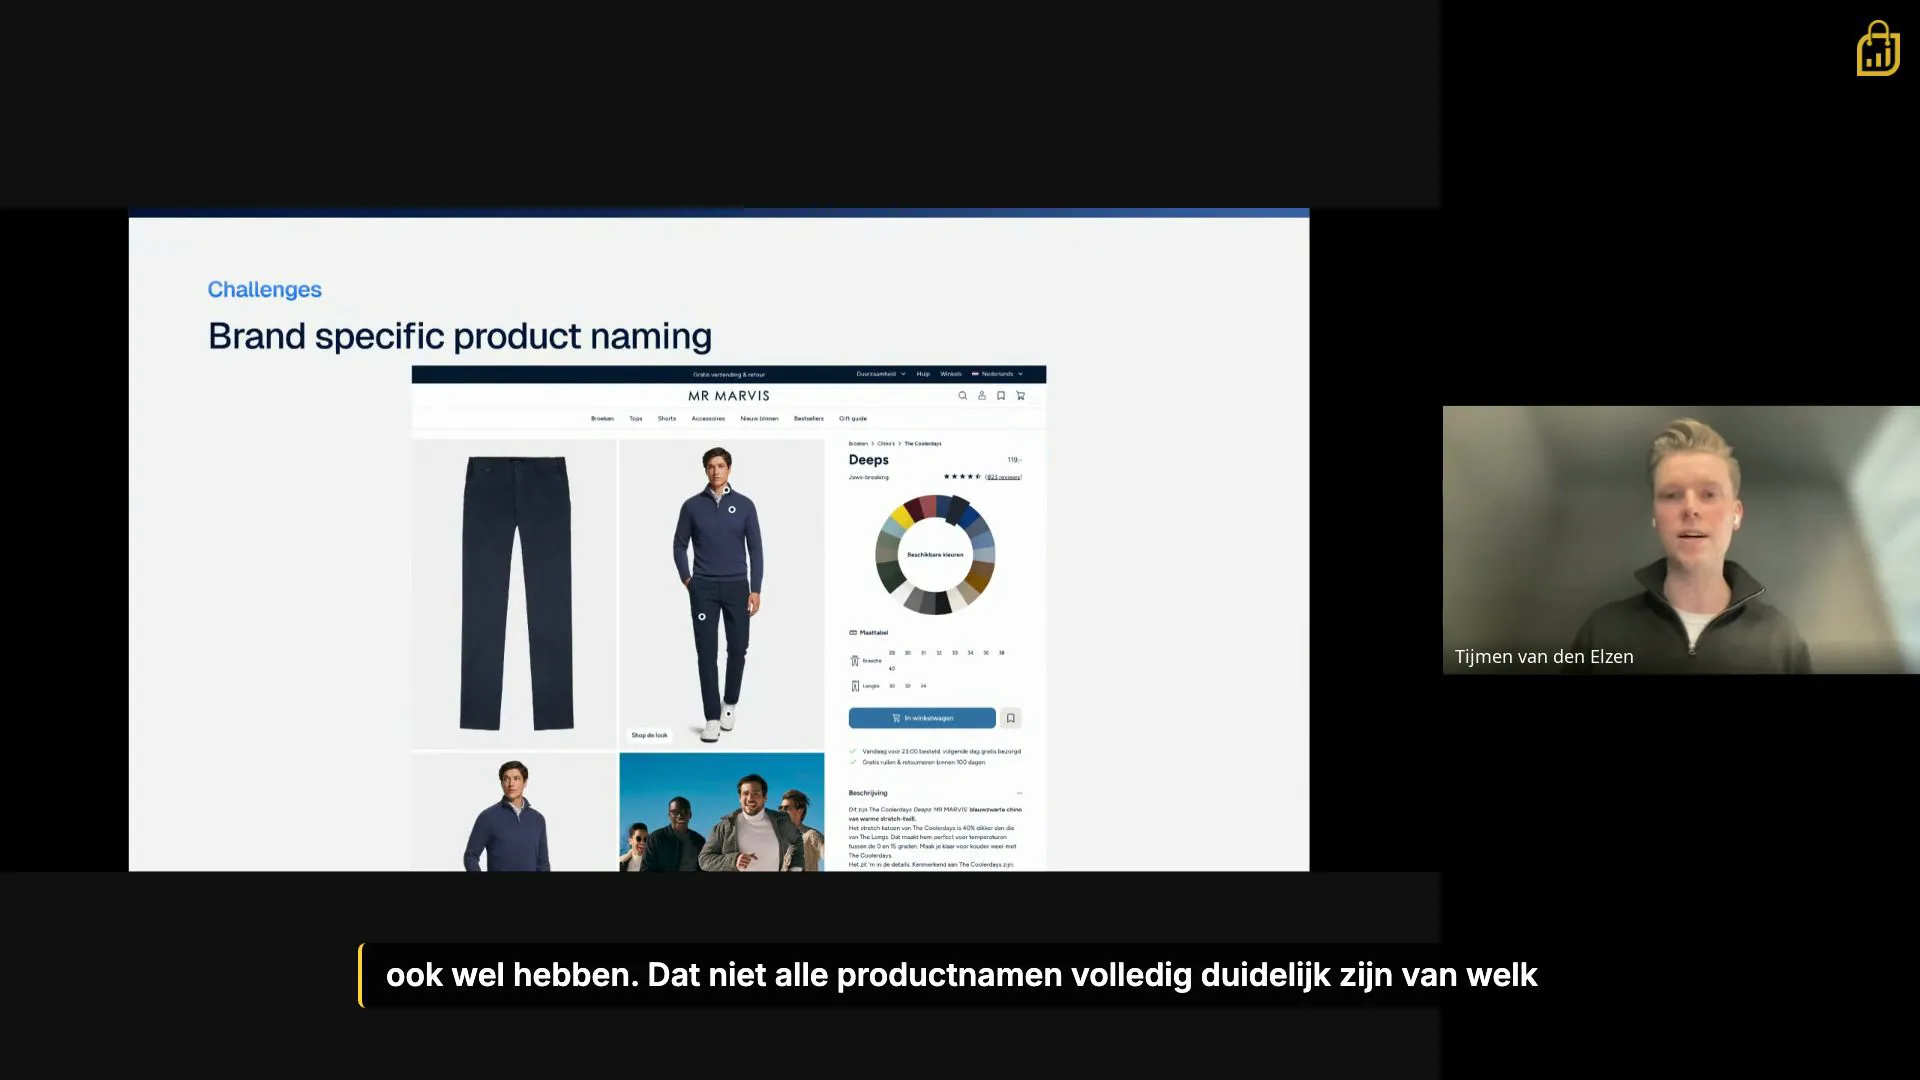 Duur 1:37
Hoe Mr. Marvis AI trainde op merkspecifieke productnamen
Tijmen van den Elzen, Engaige
AI snapt je productnamen niet, en dat kost je klanten