Self-healing pipelines en AI als controleur van je cijfers
Jop van Hooft, eCommerce AI Club
Uit de sessie: Specialists: Dashboards
In de Specialists-sessie over dashboards van december 2025 laat Jop van Hooft van de eCommerce AI Club zien waar AI hem helpt bij data-analyse buiten het schrijven van code. Je hoort over meldingen bij veranderende datastructuren, over documentatie en over AI als tweede paar ogen voor je berekeningen.
Voor wie: Je werkt met dashboards en wilt fouten in je data eerder vinden.
Waarom dit ertoe doet
Een dashboard is zo betrouwbaar als de berekening eronder. Jop merkt dat hij zelf soms de laatste controlestap overslaat. Als hij een AI vraagt of een berekening klopt, snijdt het model die volgens hem op alle mogelijke manieren door en vindt het eerder een outlier of een fout dan hij zelf. Dat maakt het toevoegen van nieuwe berekeningen sneller. Voor een webshop is dat relevant, omdat een fout in omzet, marge of voorraad direct tot verkeerde besluiten leidt. Het tweede punt is schema-drift: een veld dat van type verandert, bijvoorbeeld een product-ID dat van getal naar tekst gaat, kan een rapport stil laten breken. Een melding op dat moment scheelt je een week verkeerde cijfers.
Belangrijkste inzichten
- Jop van Hooft krijgt via een n8n-automatisering een melding als een product-ID ineens een tekst is terwijl het altijd een getal was.
- Schema-drift, velden die toegevoegd of verwijderd worden, maakt analyses stuk die steeds dezelfde structuur verwachten.
- Volgens Jop snijdt een AI een berekening op alle mogelijke manieren door en vindt eerder een outlier of fout dan hijzelf.
- Hij controleert zelf een paar getallen op hoofdlijnen en laat de AI de rest nalopen.
- Hij documenteert zoveel mogelijk, omdat modellen steeds beter worden en die documentatie later bruikbaar blijft.
Van schema-drift naar self-healing pipelines
Jop beschrijft in het deel hiervoor dat de structuur van binnenkomende data over tijd kan veranderen, doordat velden worden toegevoegd of verwijderd. Je analyse verwacht steeds dezelfde structuur. In zijn voorbeeld krijgt hij via een n8n-automatisering een melding dat op een account een nieuw product is aangemaakt waarvan het product-ID ineens een tekst is, terwijl het altijd een getal was. Van daaruit gaat het volgens hem richting self-healing pipelines: dataverwerking die afwijkingen zelf signaleert en liefst herstelt. De volgende stap, het zelf laten oplossen, noemt hij niet als bestaand resultaat.
Documentatie als bijproduct
Jop probeert zoveel mogelijk te documenteren en laat daar AI bij helpen. Een deel van de zin is slecht verstaanbaar, dus de precieze verdeling tussen schrijven en lezen laten we open. De gedachte erachter is duidelijk: de modellen worden steeds beter, dus goed gedocumenteerde informatie kun je later steeds beter gebruiken om de volgende stappen te zetten. Voor een dataproject betekent dit: beschrijf wat elke tabel, kolom en berekening doet.
AI als controleur
Aan de voorkant, bij het visualiseren, komt volgens Jop het meeste werk neer op coderen: zorg dat de juiste berekeningen in je data staan. Hij geeft toe dat hij soms lui is en de laatste stap overslaat, namelijk je data controleren nadat je een berekening hebt gedaan. Hij controleert zelf een paar getallen op hoofdlijnen. Vraag je een AI om te controleren of de berekening klopt, dan snijdt die hem op alle mogelijke manieren door en vindt vaker een outlier of fout dan hij zelf. Dat is zijn ervaring, geen meting; er zijn geen aantallen genoemd.
Zo pas je het toe
Begin met één rapport dat je vaak gebruikt. Laat een AI de berekening stap voor stap uitleggen en vraag welke randgevallen kunnen misgaan, zoals lege waarden, dubbele orders of een andere valuta. Laat het model de uitkomst op meerdere manieren narekenen en vergelijk die met je eigen steekproef. Zet een eenvoudige melding op de belangrijkste invoer, bijvoorbeeld via n8n, zodat een gewijzigd veldtype opvalt voor je rapport het overneemt. Gebruik hiervoor testdata en geen productiegegevens. Evalueer na 4 weken hoeveel meldingen terecht waren.
Probeer dit deze week
- Kies 1 rapport en laat een AI de belangrijkste berekening op 3 manieren narekenen.
- Maak voor je 5 belangrijkste datavelden een melding als het type of de naam verandert.
- Schrijf voor je 3 meest gebruikte KPI's op in 2 zinnen hoe ze zijn berekend.
Begrippen
- Schema-drift
- De structuur van je data verandert over tijd, doordat velden worden toegevoegd, verwijderd of van type wisselen.
- Self-healing pipeline
- Dataverwerking die afwijkingen zelf signaleert en probeert te herstellen.
- Outlier
- Een waarde die ver buiten het verwachte patroon valt en vaak op een fout wijst.
Verdiep je in de gids
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
en dat gaat eigenlijk een beetje verder richting een stukje self-healing pipelines. Dat je dus ook veel beter kan monitoren en [onverstaanbaar]. En als laatste puntje zit er gewoon heel veel documentatie en informatie. Ik probeer zoveel mogelijk te documenteren. Ik schrijf het [onverstaanbaar], dat laat ik AI doen. Ik lees het [onverstaanbaar], dat laat ik ook AI doen. Maar ik wil het wel hebben, anders je merkt: die modellen worden steeds beter. En dan kun je die documentatie ook steeds beter gebruiken om daar weer de volgende stappen in te zetten. Dat is het stukje back-end. En als we het dan over een stukje front-end hebben, dus het wat meer visualiseren van data, dan is het weer een stukje coderen wat daar aan de grondslag komt. Zorg dat je de juiste berekeningen in je data hebt. Wat ik ook heel even daarin merk, is dat ik wat lui ben en soms de laatste stappen oversla. Maar de laatste stap is altijd dat je je data heel goed controleren. Dan dat je een bepaalde berekening hebt gedaan. En ik controleer altijd wel een paar getallen of ze kloppen op hoofdlijnen. Maar je merkt als je AI vraagt om dat te controleren. Klopt deze berekening wel? Dat hij hem op alle mogelijke manieren doorsnijdt. En daar nog eerder een outlier of een fout in de berekening uit weet te halen. Dan dat ik dat zelf voor elkaar krijg. En daardoor gaat het dus ook veel sneller om dat soort calculaties toe te voegen. Je merkt ook dat [onverstaanbaar] samenvattingen creëren met AI. Dat het heel goed te doen is.
Spreker: Jop van Hooft, eCommerce AI Club
Bronnen
Meer over Data & Dashboards
 Duur 1:47
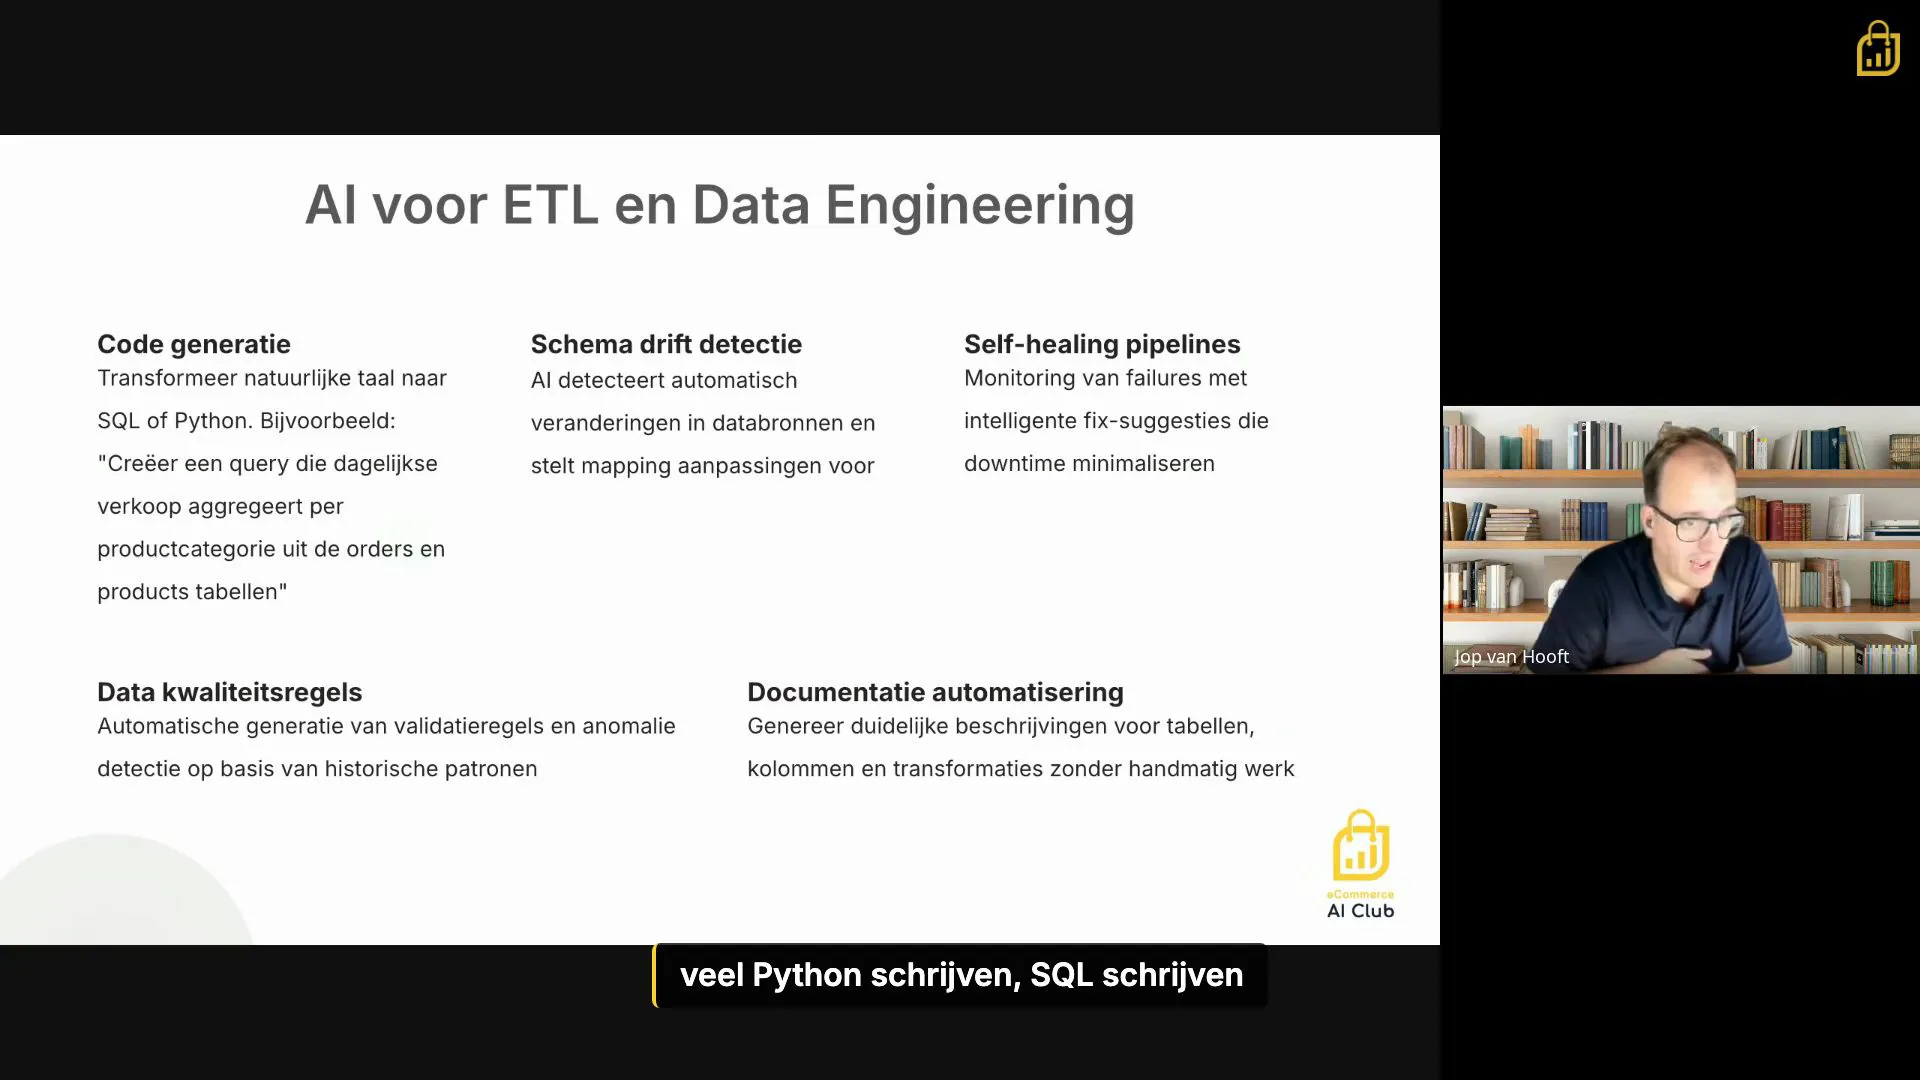
AI Code Generatie: van SQL tot DAX in seconden
Jop van Hooft, eCommerce AI Club
AI schrijft je SQL, Python en DAX in één keer goed, en waarschuwt als je data verandert
 Duur 1:48
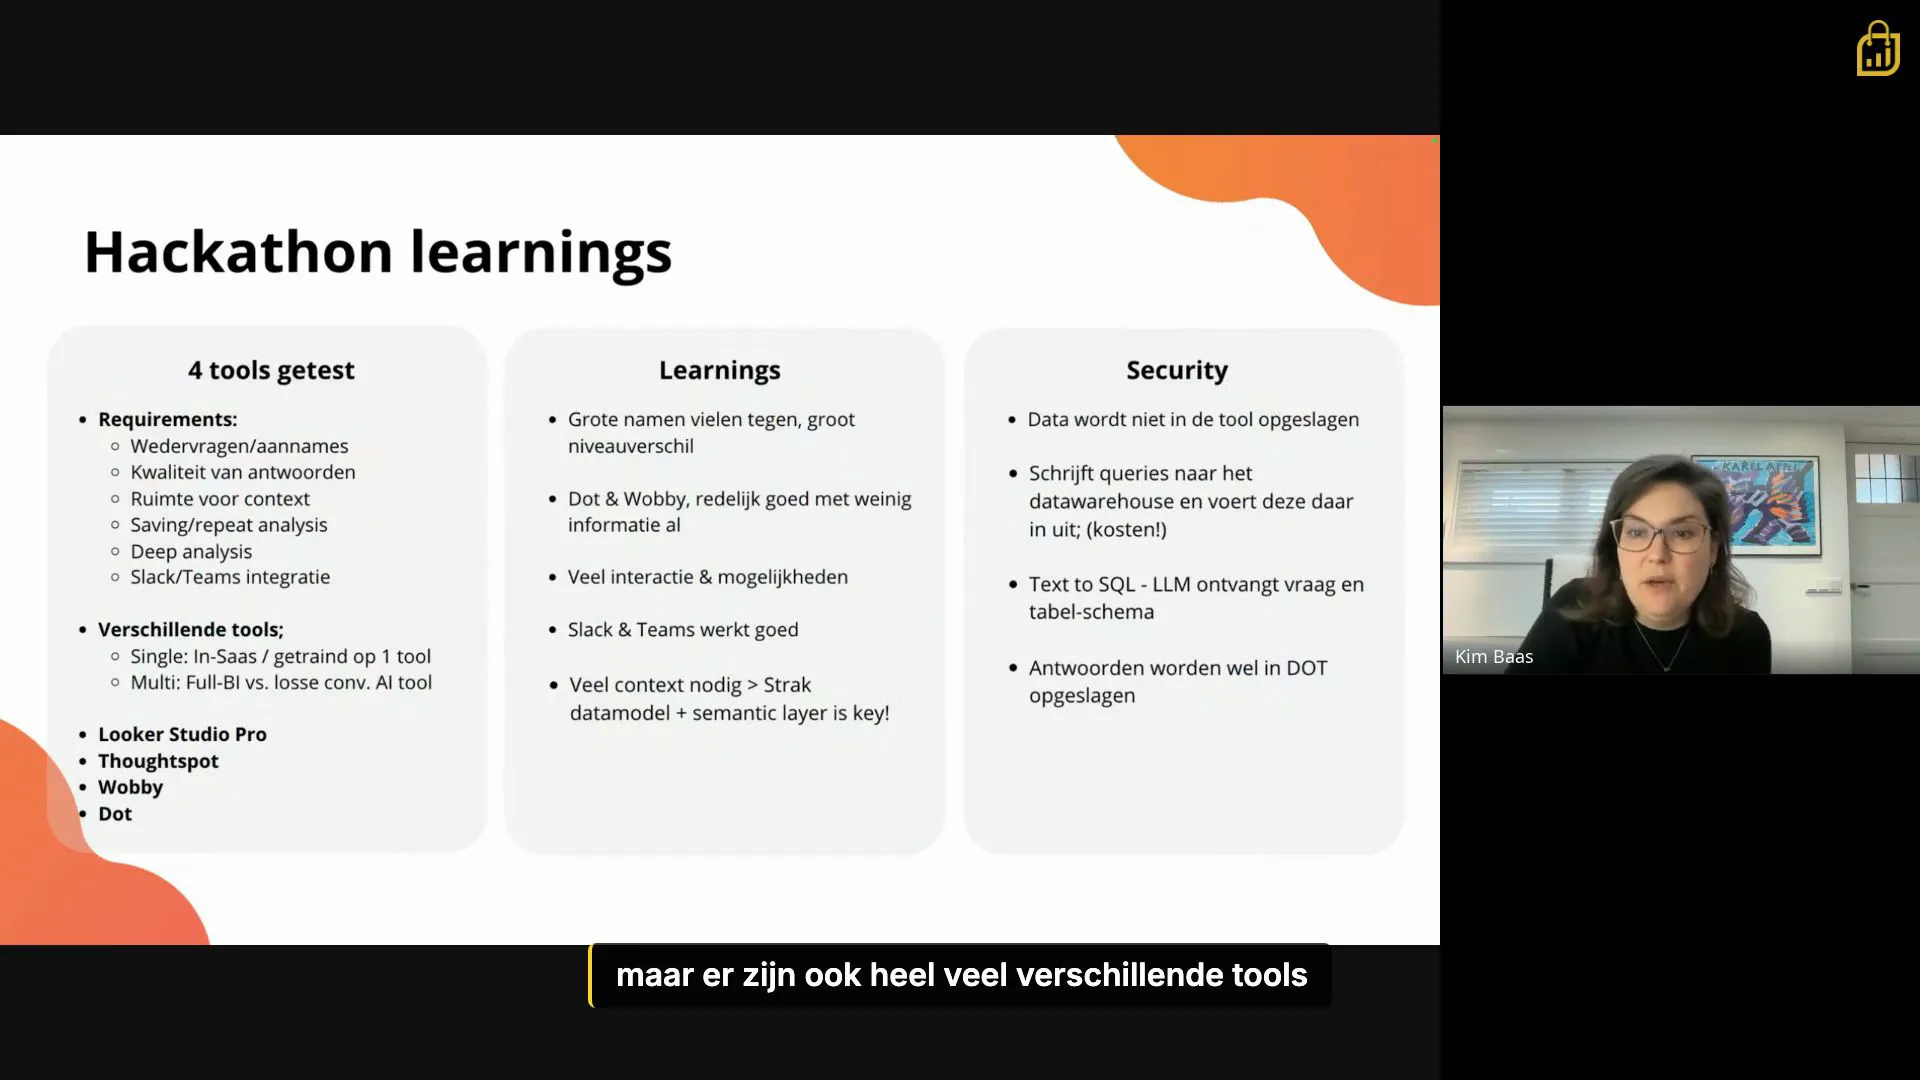
4 conversational analytics tools getest
Kim Baas, Insight First
Vier AI analytics tools getest, dit zijn de requirements die er echt toe doen
 Duur 1:50
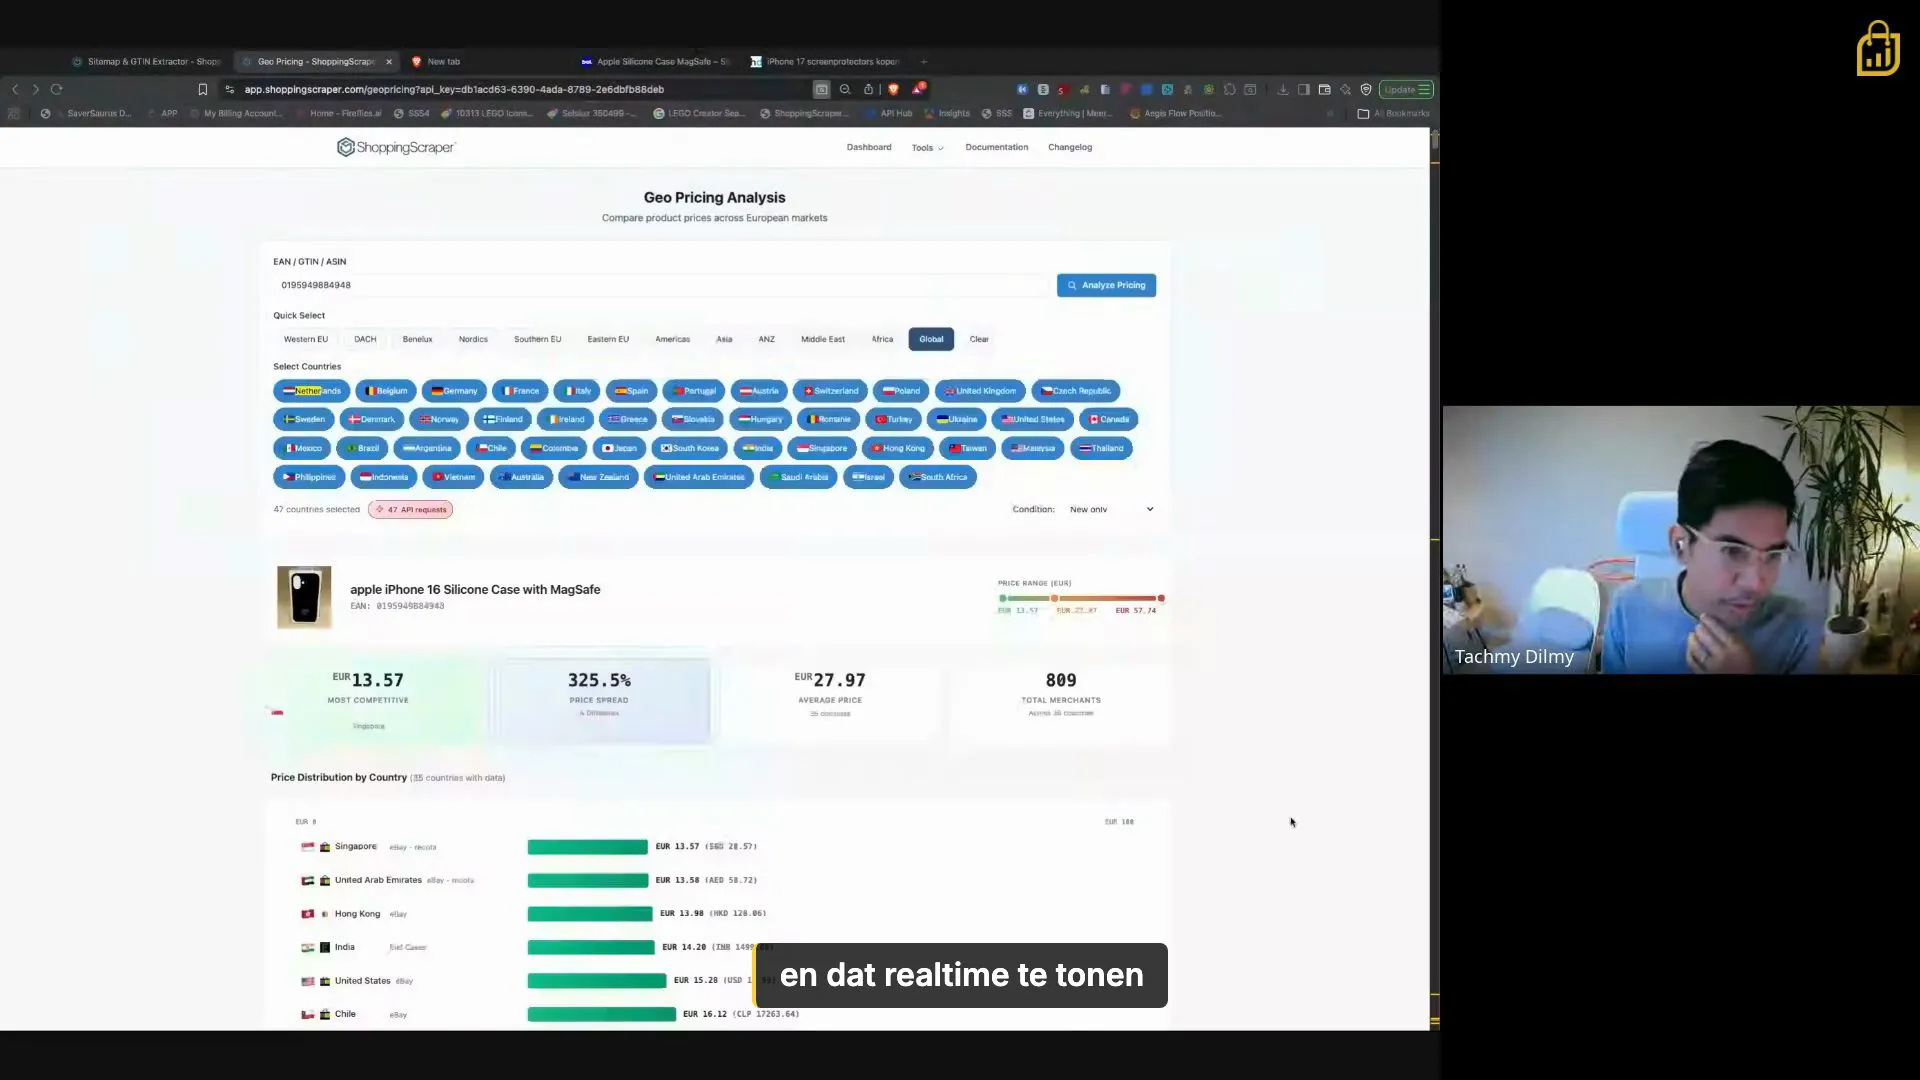
Real-time prijsvergelijking via Google Shopping API
Tachmy Dilmy, eCommerce AI Club
Live Google Shopping prijzen direct in je dashboard, zonder data warehouse ertussen