Vragen stellen aan je data in Looker
Arne Timmerman, YourSurprise
Uit de sessie: Maandelijkse Meeting sep 2025
Arne Timmerman, CTO van YourSurprise, sluit zijn presentatie in de maandelijkse meeting van september 2025 af met een voorbeeld uit Looker. Hij stelt in gewone taal een vraag over het aantal orders op de Duitse website. Daarna legt hij uit wat zijn team doet om de antwoorden van zo'n AI-laag betrouwbaar te maken.
Voor wie: Je wilt collega's zelf vragen laten stellen aan je data en zoekt waar je moet beginnen om de antwoorden te kunnen vertrouwen.
Waarom dit ertoe doet
In veel webshops hangt elke cijfervraag af van één analist of van een dashboard dat net niet het juiste filter heeft. Vragen stellen in gewone taal klinkt als de oplossing, maar een taalmodel weet niet wat jouw kolom 'ord_net_v2' betekent. Arne Timmerman ziet bij YourSurprise dat de antwoorden 'vele malen beter' worden zodra velden een beschrijving hebben. Google zegt hetzelfde in de documentatie van Conversational Analytics in Looker: het model gebruikt naam, label en beschrijving van een veld om termen uit je vraag aan de juiste data te koppelen. Het werk dat AI-analyse bruikbaar maakt, zit dus vooral in je datadefinities en minder in de tool zelf.
Belangrijkste inzichten
- Looker beantwoordt een vraag in gewone taal, zoals het aantal orders op de Duitse site, door zelf de tabel, de velden en de query te kiezen.
- YourSurprise ziet veel betere antwoorden zodra datavelden een beschrijving en uitleg hebben.
- Conversational Analytics in Looker werd in april 2025 aangekondigd en is sinds 14 november 2025 algemeen beschikbaar.
- De AI leest naam, label, beschrijving en type van LookML-velden en negeert verborgen velden.
- Bij GA kwamen vervolgvragen, analyses over maximaal vijf Explores en een uitleg van hoe een cijfer is berekend erbij.
Wat je in de clip ziet
Looker is het business intelligence-platform van Google Cloud. In het screenshot vraagt Arne hoeveel orders er op de Duitse website zijn geplaatst. Looker schrijft daar zelf een query voor en geeft het aantal terug. Daaronder vraagt hij om een grafiek van orders per uur, vergeleken met vorig jaar. Achter de schermen bepaalt het model eerst wat de vraag is, welke data nodig is, in welke tabel het moet kijken en welke velden relevant zijn. Arne noemt het 'echt de toekomst van analytics': je gaat in gesprek met je data in plaats van een rapport te bouwen.
Van beta naar algemeen beschikbaar
Toen Arne dit liet zien, was de functie nog een beta. Google maakte Conversational Analytics in Looker in april 2025 bekend tijdens Google Cloud Next en meldde op 14 november 2025 dat het algemeen beschikbaar is voor alle gebruikers van het Looker-platform. Een beheerder moet het wel aanzetten. Bij de lancering kwamen er functies bij: vervolgvragen in hetzelfde gesprek, vragen over maximaal vijf Explores tegelijk, agents met vaste vragen en filters die je met collega's deelt, en een knop die in gewone taal uitlegt hoe een cijfer is berekend.
Waarom veldbeschrijvingen het verschil maken
Looker heeft een semantische laag, LookML. Daarin staat centraal gedefinieerd wat elke maatstaf en elk veld betekent. Google noemt die laag de context voor de AI. De documentatie zegt dat de agent onder meer de naam, het label, de beschrijving en het type van een veld leest om woorden uit je vraag aan velden te koppelen. Velden die verborgen zijn, negeert hij. Google raadt aan beschrijvingen kort en specifiek te houden en geen overbodige velden zoals interne id's of tussenberekeningen te tonen. Dat is precies wat Arne bedoelt: een model kan niet weten wat jij met een attribuut bedoelt als je het niet beschrijft. In de vragenronde na de clip tipte een deelnemer de knop Describe data in BigQuery, waarmee Gemini voorstellen doet voor tabel- en kolombeschrijvingen.
Wat feit is en wat ervaring
De beschikbaarheid en de rol van LookML-beschrijvingen staan in bronnen van Google. Dat de antwoorden 'vele malen beter' worden, is de ervaring van YourSurprise en niet gemeten in de clip. Google publiceert zelf geen nauwkeurigheidscijfers. Arne zegt zelf dat het een oud screenshot is. Gebruik je geen Looker, dan geldt hetzelfde principe voor andere BI-tools met een AI-laag: zonder heldere definities van omzet, order en retour krijg je per vraag een ander antwoord.
Probeer dit deze week
- Maak een lijst van de tien velden die je team het vaakst gebruikt en schrijf bij elk in één zin wat het betekent, inclusief btw, retouren en valuta.
- Stel je AI-tool drie vragen waarvan je het antwoord al weet en noteer waar het misgaat.
- Verberg in je BI-model interne id's en tussenberekeningen die niemand in een vraag nodig heeft.
Begrippen
- Conversational analytics
- Vragen in gewone taal aan je data stellen, waarna het systeem zelf de query bouwt en het antwoord of de grafiek toont.
- Semantische laag
- Een centrale plek waar staat wat elke maatstaf en elk veld betekent, zodat iedereen hetzelfde cijfer krijgt.
- LookML
- De modeltaal van Looker waarin je velden, maatstaven en hun beschrijvingen vastlegt.
- Explore
- Een afgebakende dataset in Looker waarin je velden combineert om vragen te beantwoorden.
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
Dit is binnen Looker. Looker is een business intelligence platform. Het heeft recent conversational analytics toegevoegd. Het is nog een beta. Ik weet niet of andere systemen dit ook hebben. Maar wat je hier ziet is dat je vragen kan stellen aan je data. Dus ik had hier, dit is al een oude screenshot, gevraagd. Hoeveel orders zijn er gisteren op onze Duitse website besteld? En dan bepaalt Looker in dit geval, oké, wat is de vraag? Welke data heb ik nodig? Welke tabel moet ik kijken? Welke velden zijn dan relevant? Ik denk dat dit super interessant is. En echt wel de toekomst is ook van analytics. Dat je veel meer vragen gestuurd met je data in gesprek gaat. Wat wij wel zien hier, dat het heel erg belangrijk is. Dat je data rijk is voorzien van ontgrijvingen en uitleg. Zodat die modellen ook snappen wat een veld betekent. Dus die zijn we nu op steeds meer plek aan het toevoegen. En we zien dat de antwoorden dan vele malen beter zijn dan wanneer je dat niet doet. Want dan is het op zich ook logisch. Je kan zo'n model weten wat jij met een bepaald attribuut bedoelt, maar je het niet beschrijft. Dus dit is iets waar wij op dit moment ook mee bezig zijn.
Spreker: Arne Timmerman, YourSurprise
Bronnen
Meer over Data & Dashboards
 Duur 1:47
AI Code Generatie: van SQL tot DAX in seconden
Jop van Hooft, eCommerce AI Club
AI schrijft je SQL, Python en DAX in één keer goed, en waarschuwt als je data verandert
 Duur 1:48
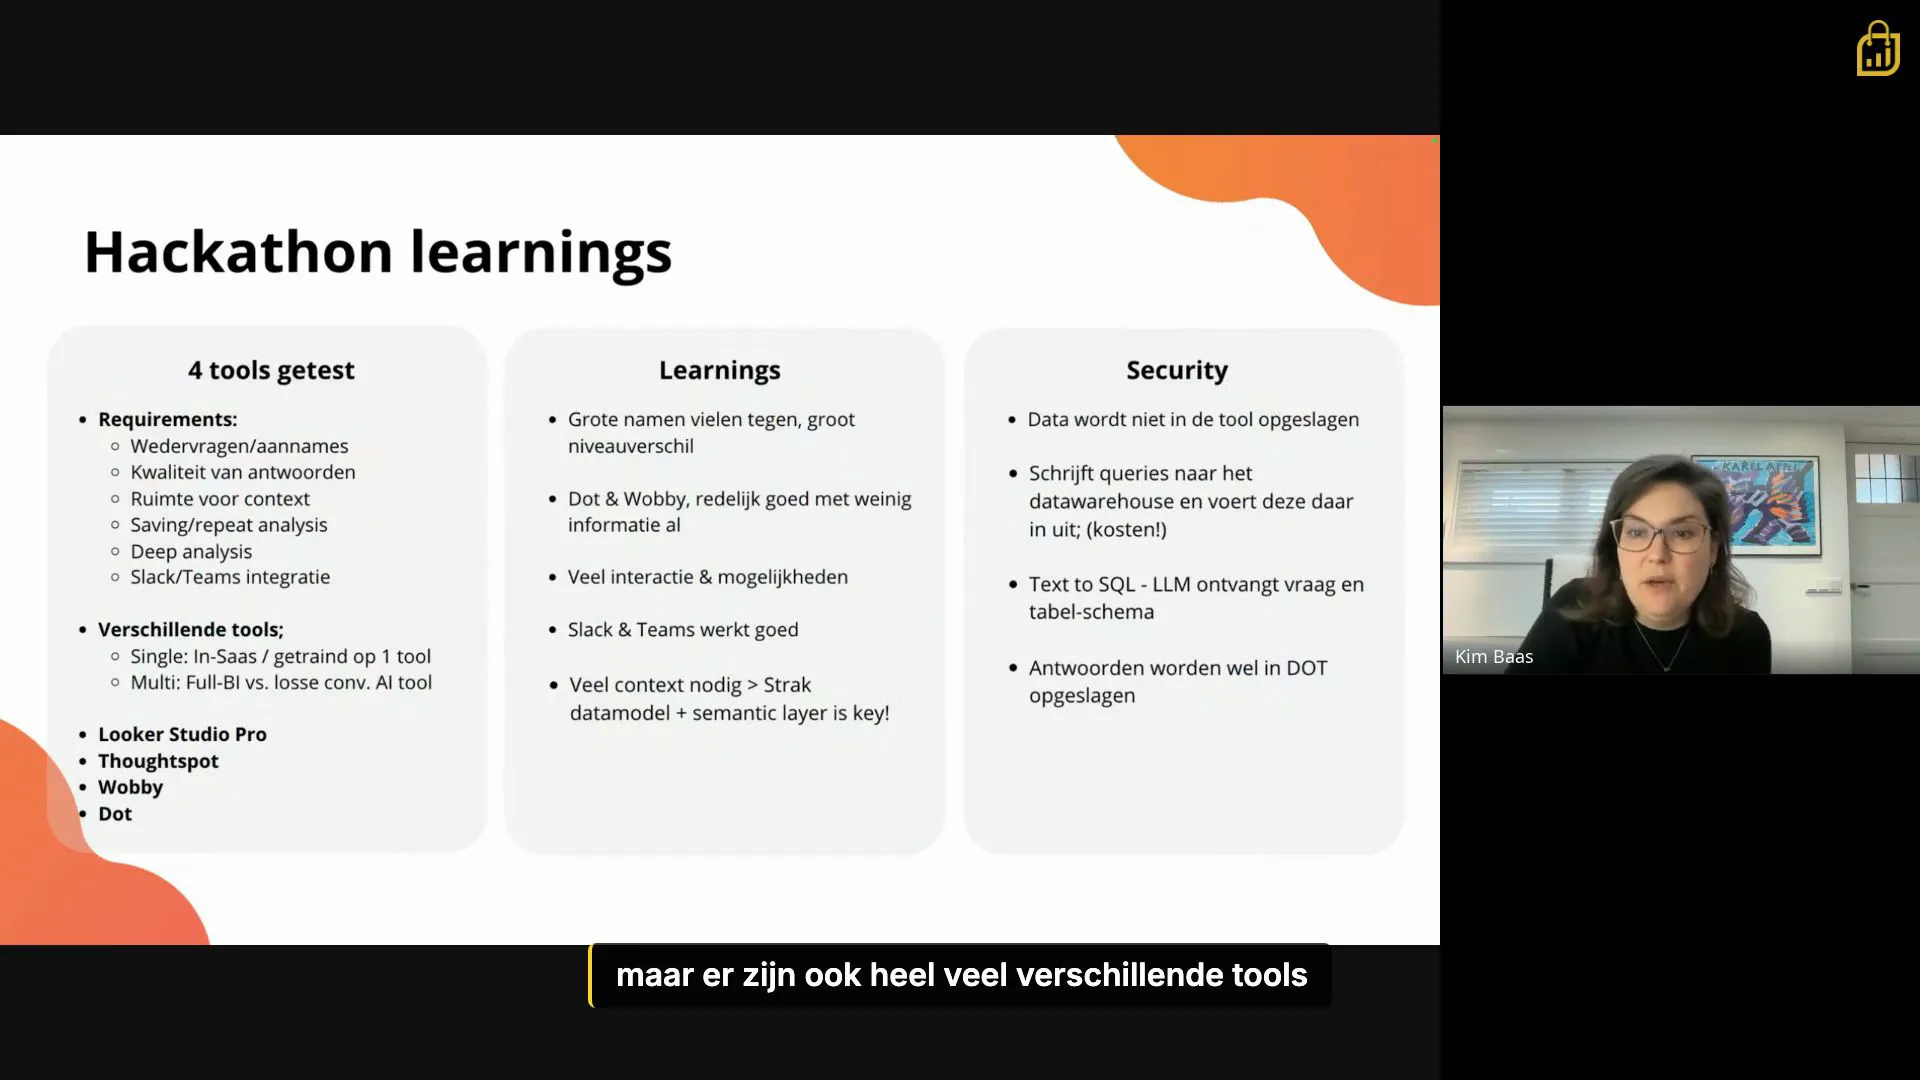
4 conversational analytics tools getest
Kim Baas, Insight First
Vier AI analytics tools getest, dit zijn de requirements die er echt toe doen
 Duur 1:50
Real-time prijsvergelijking via Google Shopping API
Tachmy Dilmy, eCommerce AI Club
Live Google Shopping prijzen direct in je dashboard, zonder data warehouse ertussen