Een fotoprompt is geen videoprompt
Tachmy Dilmy, eCommerce AI Club
Uit de sessie: Maandelijkse Meeting jun 2025
Tachmy Dilmy van de eCommerce AI Club laat in juni 2025 zien waarom AI-video van producten soms misgaat. De kwaliteit hangt af van wat je meestuurt, complexe producten geven meer fouten, en een prompt voor een foto werkt niet als videoprompt. Je ziet voorbeelden met een Lego-set, zonnebrand en een deegkneder.
Voor wie: Je wilt AI-video maken van je producten en wilt vooraf weten waar het meestal misgaat.
Waarom dit ertoe doet
Wie een productvideo met AI wil maken, begint meestal met dezelfde prompt als voor de foto. Tachmy laat zien dat dat niet werkt: bij een deegkneder gaf de fotoprompt een prima beeld, maar dezelfde prompt gaf een video zonder samenhang. Hij noemt ook een tweede les. Hoe meer tekst, logo's of ingrediënten op je product, hoe meer artifacts, dat zijn fouten in het beeld, zoals een doos die ineens dunner wordt. Voor webshops met veel verpakte producten is dat belangrijk, want logo's en tekst zijn juist wat een klant controleert. De uitkomst: begin met eenvoudige scènes, schrijf een aparte videoprompt en controleer elk resultaat. Het fragment is van juni 2025, de modellen zijn sindsdien verbeterd, maar de werkwijze blijft gelden.
Belangrijkste inzichten
- De kwaliteit van een AI-video hangt af van de input: context, model en prompt moeten alle 3 kloppen.
- Hoe meer tekst, logo's of ingrediënten, hoe meer artifacts. Gebruik dan eenvoudiger scènes.
- Bij een deegkneder gaf dezelfde prompt een goede foto en een video zonder samenhang.
- Een prompt voor een foto is niet dezelfde als een prompt voor een video.
- ByteDance claimt dat Seedance 1.0 in juni 2025 nummer 1 stond bij Artificial Analysis. Dat is een bedrijfsclaim.
Input bepaalt de kwaliteit
Tachmy zegt dat de kwaliteit van de video afhangt van de input: garbage in, garbage out. Op zijn slide zie je drie cirkels die elkaar overlappen: context, LLM-model en prompt. Hoe meer context je meegeeft over wat je wilt bereiken, hoe beter. De videomodellen worden ook slimmer en kunnen redeneren, zegt hij. Daarom moet de prompt goed zijn en moet je het beste model gebruiken. Hij laat een Lego-set zien die uit de doos wordt gehaald, een voorbeeld van user-generated content, en waarschuwt dat het nog niet perfect is: de doos wordt ineens dunner dan hij echt is. Volgens zijn eigen context gebruikte hij voor de video's het nieuwste model van ByteDance. ByteDance zegt in het technisch rapport van Seedance 1.0 uit juni 2025 dat dat model nummer 1 stond op de ranglijst van Artificial Analysis. Dat is een claim van het bedrijf.
Complexe producten, meer artifacts
Iemand in de chat vraagt naar artifacts, bijvoorbeeld logo's die niet goed doorkomen. Tachmy ziet dat in zijn voorbeeld met zonnebrand: als je inzoomt staat de naam Nivea Sun er goed in, maar daaronder wordt het steeds complexer. Zijn regel: hoe complexer de scène, hoe meer moeite AI heeft met alle details. Heeft je product ingrediënten of veel tekst, dan krijg je vanzelf meer artifacts. Gebruik dan veel simpelere scènes.
Een aparte prompt voor de video
Het tweede voorbeeld is een deegkneder van Maxima. Hij liet de tool een scène maken en gebruikte dezelfde prompt voor een video. Dat gaf volgens hem een totaal niet samenhangende videoscène, terwijl de fotoprompt een prima resultaat had gegeven. Zijn les: de prompt voor je foto is een heel andere prompt dan die je nodig hebt voor de video. Dat klopt met hoe de twee werken: een foto beschrijft een moment en een video beschrijft beweging in de tijd.
Wat je ermee doet
Begin met een product met een eenvoudige vorm en een eenvoudige scène. Schrijf voor de video een aparte prompt, met beweging en cameraperspectief, en laat een taalmodel meedenken. Controleer elk resultaat op logo's, tekst en proporties voor je iets publiceert. Houd bij welke producten telkens fouten geven, zodat je die buiten AI-video houdt.
Probeer dit deze week
- Kies 3 producten, 1 eenvoudig en 2 met veel tekst, en maak per product een video met een aparte videoprompt.
- Laat een taalmodel op basis van je foto 3 beschrijvingen van beweging schrijven en test de beste.
- Vergelijk de 3 resultaten op logo's, tekst en proporties en noteer welke producten je buiten AI-video houdt.
Begrippen
- Artifact
- Een fout in een AI-beeld of -video, zoals een vervormd logo of een onderdeel dat verandert.
- User-generated content (UGC)
- Beeldmateriaal dat lijkt te zijn gemaakt door klanten, zoals een uitpakvideo.
- Garbage in, garbage out
- Als je slechte input geeft, krijg je slechte output.
- Prompt
- De instructie die je aan een AI-model geeft.
Verdiep je in de gids
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
En let zeker op dat het zeker nog niet perfect is, want je ziet echt nog wat artifacts en af en toe zie je nog dat de doos ineens een stuk dunner wordt dan dat die daadwerkelijk is. En dat is eigenlijk wat ik wil meegeven van de kwaliteit van de video hangt eigenlijk ook af van de input. Logischerwijs, garbage in is garbage out. Dus dat hangt heel erg af wat je meestuurt als context. Die modellen zijn, die videomodellen zijn ook steeds slimmer aan het worden, dat ze dus ook kunnen redeneren. Dus hoe meer context je meegeeft wat je wil bereiken. zorg ervoor dat die prompt ook goed is en dat dat model wat je dus gebruikt dat dat ook het allerbeste model is en [onverstaanbaar] en ik zie ook een vraag binnenkomen over de artifacts, dat logo's bijvoorbeeld niet goed doorkomen. Dat zie je hier eigenlijk al een beetje: als je helemaal inzoomt, die Nivea Sun staat er echt wel goed in, maar daaronder wordt het eigenlijk al steeds complexer en dat zijn eigenlijk dingen hoe complexer de scène is, hoe meer moeite AI heeft om al die details goed te krijgen. Dus je zou eigenlijk hele simpele, hoe meer producten je hebt met heel veel complexiteit erin, dan moet je eigenlijk veel simpelere scènes hebben. Dus als je product hebt met ingrediënten of met heel veel tekst erop, dan ga je vanzelf veel meer artifacts krijgen. Ik kan nog wel wat voorbeelden pakken van wat EAN-codes die in de chat meegegeven zijn. Dan kan ik ook even laten zien wat eruit die tool dan komt. Ik had hier een EAN, geen idee wat dit eigenlijk is, wat maak ik aan, een Samsonite koffer. Ga ik ondertussen even weer verder met de voorbeelden die ik had. Ik was zo vrij geweest om een product van Maxima te pakken. Volgens mij is dit een deegkneder. Wat ik gevraagd heb is, hetzelfde tool weer, stop hem erin, maak een scène. Die scène heeft hij gemaakt. Met een beetje bloem zie ik nog een beetje naar boven komen. en wat ik dacht van oké, ik gebruik diezelfde prompt voor het plaatje, die gebruik ik om een video te maken. Nou ja, dat is dus niet zo'n goed idee, want dan krijg je dus ook dit soort zaken. Dus een totaal niet samenhangende video scène, terwijl de prompt voor de foto eigenlijk, in die zin niet perfect, weliswaar, maar gewoon een prima resultaat gaf. Dus het maken van een prompt voor je foto, is weer een totaal andere prompt die je moet maken, om de juiste video eruit te krijgen.
Spreker: Tachmy Dilmy, eCommerce AI Club
Bronnen
Meer over AI & Marketing
 Duur 0:41
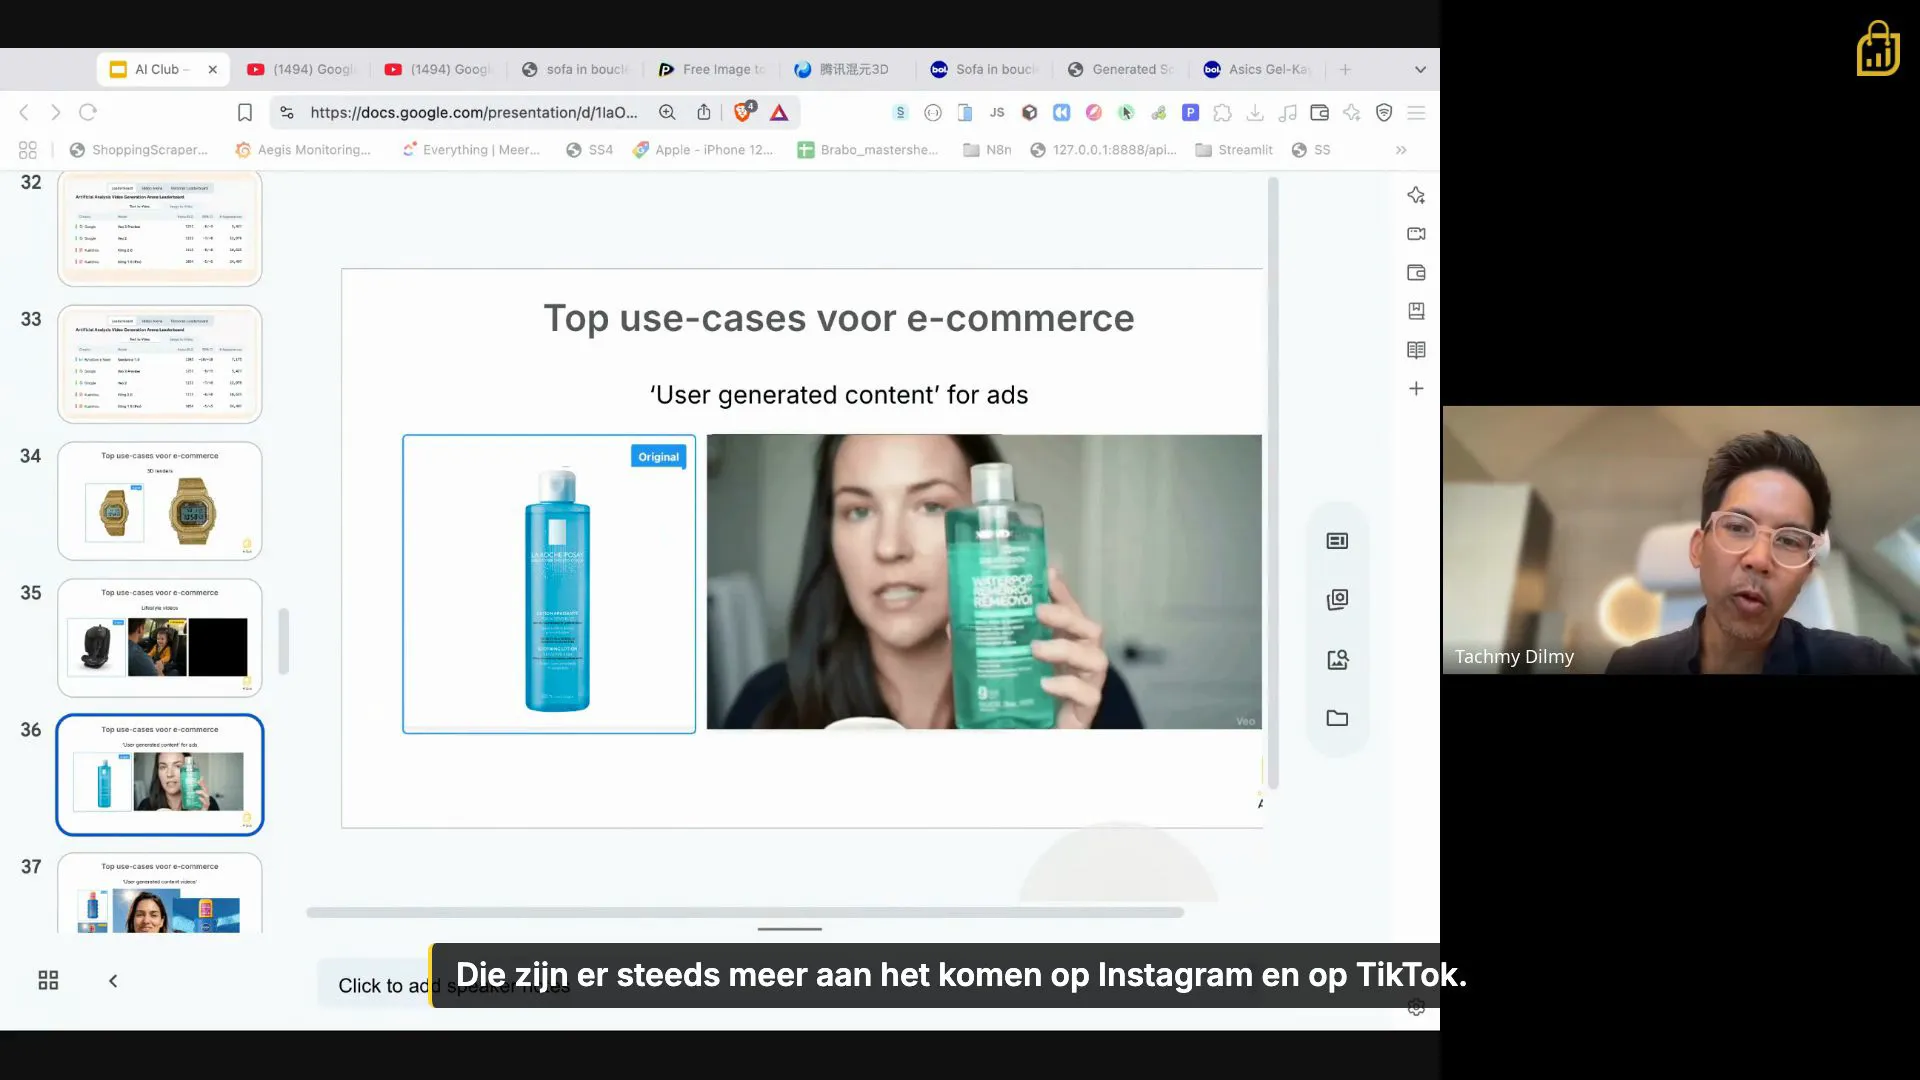
UGC van de toekomst is nep, en dat is oké
Tachmy Dilmy, eCommerce AI Club
Die user generated video op TikTok? Volledig door AI gemaakt
 Duur 0:52
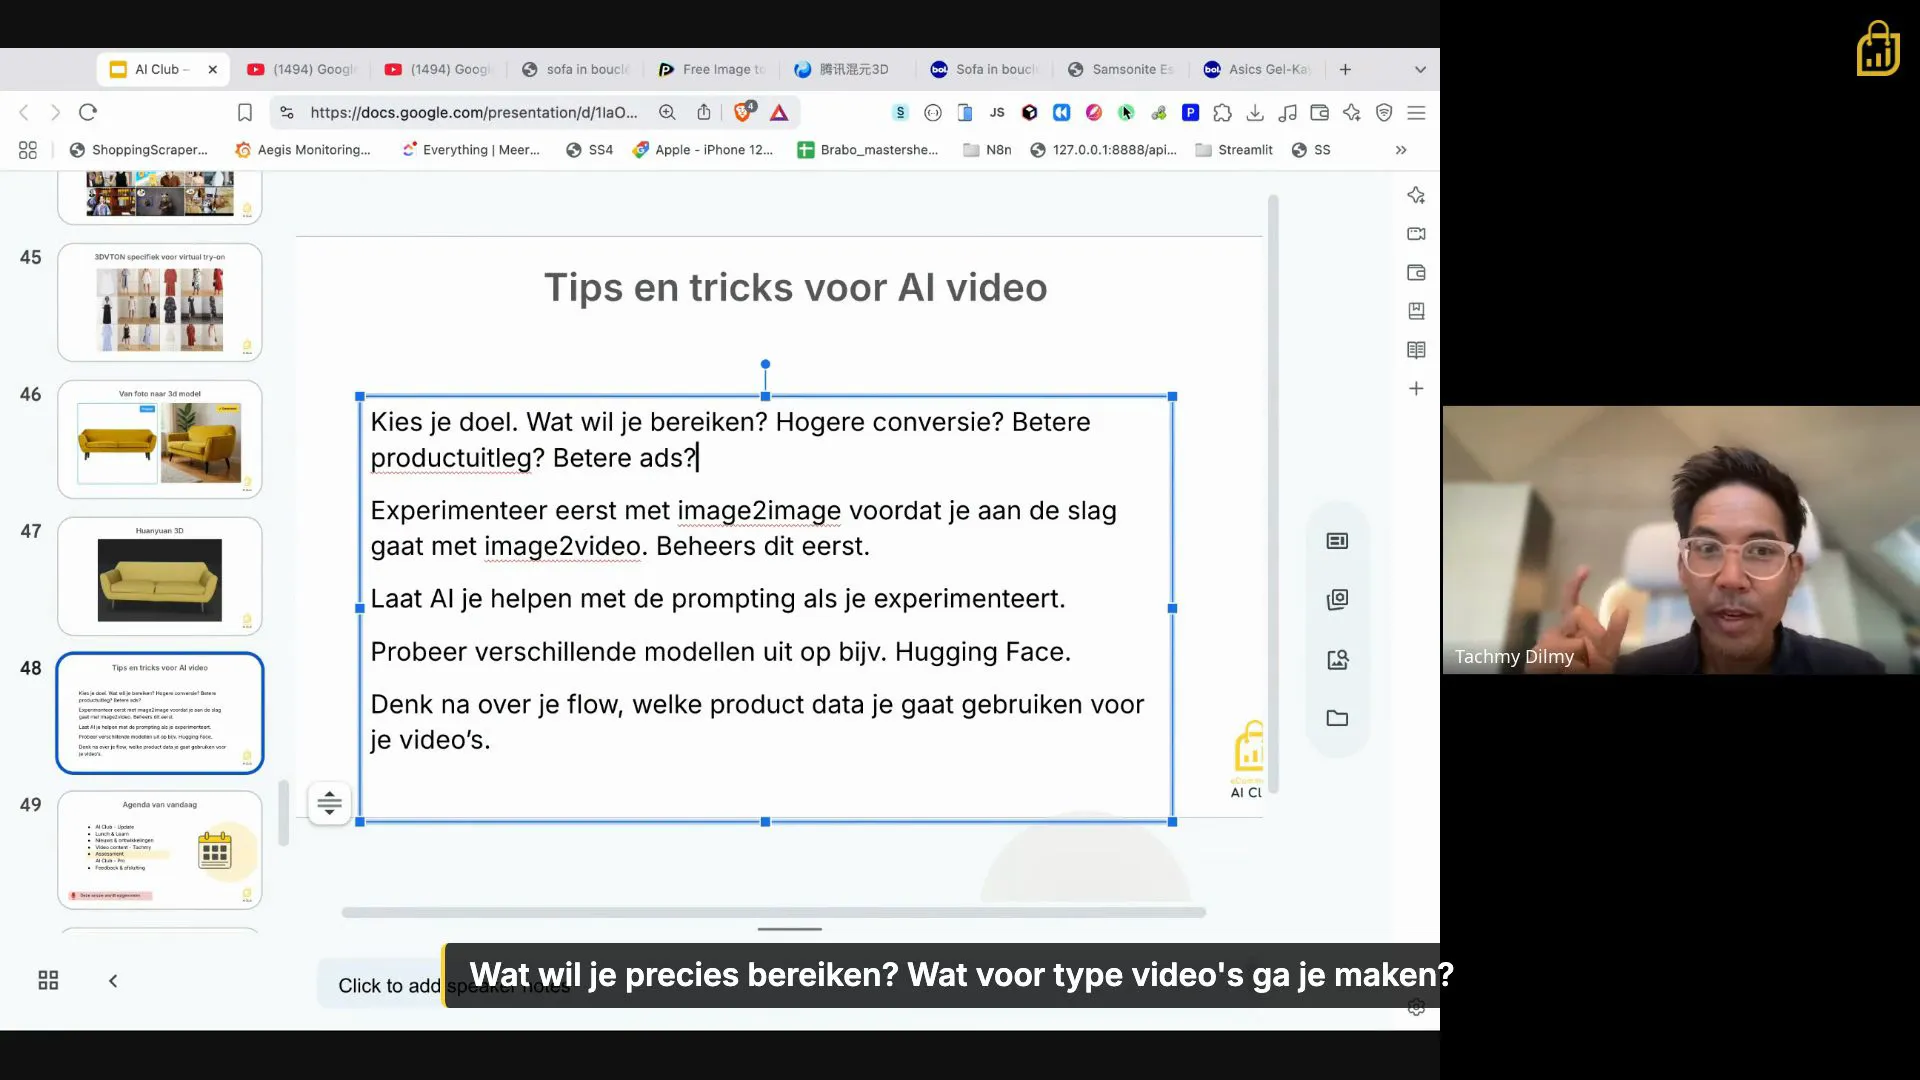
5 tips om te starten met AI video
Tachmy Dilmy, eCommerce AI Club
Begin klein met AI video, deze 5 tips helpen je op weg
 Duur 0:43
Van productfoto naar sfeerbeeld met AI
Jan Karel Ekkel, Kees Smit Tuinmeubelen
Van kale productfoto naar sfeerbeeld met AI, live demo bij Kees Smit