AI-beeldmodellen in de praktijk: van productfoto naar video
Tachmy Dilmy, eCommerce AI Club
Uit de sessie: Specialists: AI in visuele content
Dit is een audio-opname, zonder beeld, van een deel van de Specialists Meeting over AI in visuele content op 15 juli 2025. Tachmy Dilmy, co-founder van de eCommerce AI Club, loopt de beeld- en videomodellen langs die het team zelf testte, van FLUX.1 Kontext tot Veo 3 en Seedance. Hij praat bij slides die je niet ziet, dus de uitleg hieronder beschrijft wat er op het scherm stond.
Voor wie: Je wilt weten welke AI-modellen in 2025 bruikbaar waren voor productbeelden en video, en waar het in de praktijk nog misging.
Alleen audio
Van deze sessie bestaat geen video, alleen de geluidsopname. Wat er gezegd wordt, lees je hieronder in de transcriptie.
Waarom dit ertoe doet
Een productfoto laten schieten kost volgens Tachmy al snel 20 tot 30 euro per beeld. Een beeld uit FLUX.1 Kontext kostte hem 10 tot 20 cent, en 15 tot 40 cent als hij het opnieuw liet genereren. Black Forest Labs rekent op de eigen API 4 dollarcent per beeld voor Kontext [pro] en 8 dollarcent voor Kontext [max]. Met dat verschil komen sfeerbeelden en korte video's binnen bereik voor producten waar nu geen fotoshoot voor is. Elke nieuwe poging en elke extra controle kost wel weer geld. Tachmy rekent het zo: als het beeld even goed is en de helft kost, heb je gewonnen. Houd er ook rekening mee dat het model dat je vandaag kiest over een paar weken niet meer het beste is.
Belangrijkste inzichten
- FLUX.1 Kontext (29 mei 2025) houdt een product of persoon herkenbaar zonder LoRA-training; de API kost 4 dollarcent per beeld voor [pro] en 8 voor [max].
- Een AI-beeld kostte Tachmy 10 tot 20 cent, met opnieuw genereren 15 tot 40 cent, tegen volgens hem 20 tot 30 euro voor een geschoten foto.
- Veo 3 (20 mei 2025) maakt video met geluid, maar Seedance 1.0 stond op 10 juni 2025 bovenaan beide video-ranglijsten van Artificial Analysis.
- Werk in stappen (scène bedenken, beeld maken, video maken) en bouw na elke stap een controle in, door een mens of een tweede model.
- Geef het model de afmetingen van je product mee; zonder maten kwam er een Apple Watch zo groot als de draagster uit.
Wat FLUX.1 Kontext veranderde
Black Forest Labs bracht FLUX.1 Kontext uit op 29 mei 2025. Je geeft het model een bestaand beeld en een opdracht in tekst, en het houdt een persoon of product herkenbaar over meerdere scènes. Daarvoor hoef je niet eerst een eigen model te trainen. Tot dan toe had je daarvoor een LoRA nodig, een kleine extra training op je eigen product. Tachmy liet een test zien met een hoodie met het clublogo, die het team zelf door AI had laten ontwerpen. Daar plakten ze een model bij, en via een eigen tool op de API van FLUX.1 Kontext maakten ze er een scène van, die daarna bewoog. Op 26 juni 2025 volgde een open variant, Kontext [dev], onder een niet-commerciële licentie.
Veo 3, Seedance en een ranglijst die snel draait
Google kondigde Veo 3 aan op 20 mei 2025, tijdens Google I/O. Het was het eerste videomodel van Google dat er zelf geluid bij maakt: stemmen, geluidseffecten en achtergrondgeluid. Tachmy wijst vooral op de natuurkunde: water dat echt vloeit en druppelt, een gezicht dat meetrilt bij hardlopen. Toch stond Seedance 1.0 van ByteDance, het bedrijf achter TikTok, volgens het eigen onderzoeksverslag op 10 juni 2025 bovenaan beide video-ranglijsten van Artificial Analysis, voor tekst naar video en voor beeld naar video. Veo 3 stond daar onder. In die arena zien bezoekers twee video's bij dezelfde prompt, zoals popcorn in een magnetron, en kiezen ze de beste zonder het model te kennen. Tachmy zegt dat de wissel binnen een dag ging. Dat konden we niet nagaan. Zijn advies is wel helder: kijk elke week op zo'n openbare ranglijst, want misschien kan een nieuw model precies wat jij zoekt.
In stappen naar bewegend beeld, met controles ertussen
Tachmy werkt in fases. Bij één product vroeg hij eerst Gemini om een scène die het product in gebruik laat zien. Gemini kwam met een vader die zijn dochter in de auto zet. Die scène maakte hij met FLUX.1 Kontext, en het beeld ging daarna een videomodel in. In elke stap kan het misgaan. Daarom wil hij controles tussen de stappen: een mens die uit zes beelden er twee kiest, of een ander model dat checkt of het product nog klopt, of het logo goed staat en of een hand vijf vingers heeft. Volgens Tachmy bepalen drie dingen de kwaliteit: de context die je meegeeft, het model en de prompt. Geef bijvoorbeeld de afmetingen mee. Zonder maten kreeg hij een Apple Watch die even groot was als de vrouw die hem droeg.
Consistentie, try-on en de fouten die blijven
Tachmy noemt een model van Tencent dat een persoon gelijk houdt van foto naar video. Vermoedelijk gaat het om HunyuanCustom, dat Tencent op 8 mei 2025 openbaar maakte en dat volgens Tencent ook virtuele try-on ondersteunt. Try-on-modellen wisselen de kleding in een bestaande video. Veel daarvan zijn open source, dus je kunt ze op een eigen Nvidia-GPU draaien. Gebruik je beelden van een echt model, maak dan afspraken over beeldrecht. ByteDance kondigde daarna een model aan dat meerdere onderwerpen in één scène zet, vermoedelijk XVerse van 26 juni 2025. Fouten blijven: een tas met een ontbrekende flap, een knuffel van 50 centimeter die te groot uitvalt, een kind dat in een onmogelijke hoek ligt. Het team werkt aan een tool die vanaf een EAN-code beelden maakt. In juli 2025 zaten daar volgens Tachmy nog bugs in.
Probeer dit deze week
- Kies 5 producten en laat Gemini voor elk een in-use-scène voor je webshop beschrijven, inclusief de afmetingen uit je productdata.
- Maak met FLUX.1 Kontext 6 varianten per product, kies er zelf 2 en noteer per beeld wat er misging: logo, vingers, verhoudingen.
- Zet de video-ranglijst van Artificial Analysis in je agenda als vast weekmoment en vergelijk het nummer 1-model met wat je nu gebruikt.
Begrippen
- LoRA
- Een kleine extra training bovenop een groot beeldmodel, zodat het jouw product of persoon precies leert kennen.
- Modelconsistentie
- Het vermogen van een model om hetzelfde product of dezelfde persoon in elk nieuw beeld of elke video gelijk te houden.
- Video-arena
- Een openbare ranglijst waar bezoekers blind tussen twee video's kiezen; uit die stemmen volgt de score per model.
- Artifact
- Een fout die het model in het beeld maakt, zoals een extra vinger, een verdwenen flap of een vervormd logo.
- Try-on-model
- Een model dat kleding wisselt op een bestaande foto of video van een persoon.
Verdiep je in de gids
Transcriptie
Uitgeschreven uit de audio van dit fragment. Stopwoorden en herhalingen zijn weggelaten. Waar [onverstaanbaar] staat, is de opname niet te verstaan.
Die modellen worden elke dag weer beter. We weten gewoon één ding dat hetgeen wat je vandaag aan je modellen gebruikt is over twee, drie weken alweer achterhaald. De ervaring en uitdaging hebben denk ik al een beetje doorgesproken. Misschien nog leuk om later in de Wednesday's sessies, zodat daar nog wat ruimte voor is, om ook wat echte voorbeelden te zien vanuit de business, dus vanuit jullie zelf. Dus laten we die even parkeren voor het einde. Ik wil die even meenemen in een aantal dingetjes die ik al in een aantal sessies al laten zien heb. En ook wat andere voorbeelden die ik meegenomen heb.
Wat wij gedaan hebben is eigenlijk een aantal van die modellen die nu op de markt zijn. Die hebben wij zelf ook uitgeprobeerd. Met in dit geval een fictief product van ons. Stel je voor dat je een hoodie hebt. Dit FLUX.1 Kontext model. Met een K geloof ik uit mijn hoofd. is eigenlijk een aantal maanden geleden voor Genal weer aangekondigd.
Wat eigenlijk voor het eerst was, waarbij je zonder een LoRA te trainen, dat je best wel goede modelconsistency had. Dus dat de persoon of dat het product wat gebruikt werd, dat dat eigenlijk best wel grote kans had, dat het in het gegenereerde plaatje door AI ook nog hetzelfde druid zag. En dat zie je dus met de trui die we hadden, die we overigens zelf hebben laten maken door een andere AI-generator, met ons logo alleen, daar hebben we dus een model bij geplakt, en dat model hebben we dan, middels een eigen zelfgemaakte tool, die gewoon gekoppeld was aan deze API van FLUX.1 Kontext, hebben we gezegd van oké, we hebben een model, we willen graag een scène hebben, waarbij dit model beweegt, waarbij ze laat zien hoe, dan moet ik even de juiste slide erbij pakken, dat je dus eigenlijk gewoon een bewegend beeld ervan kan maken. Wat je ziet is dat, een aantal routes zijn om naar dit plaatje te komen. Je kan vanuit een foto die je zelf gemaakt hebt met AI of een foto die al bestaat, kan je bewegend beeld gaan maken met een videomodel. Dat is eigenlijk de route waarbij je gewoon een API call doet. Je stuurt de foto er naar toe en met de juiste prompt komt dit er dan uit.
Wat je ook kan doen is eigenlijk een tool gebruiken waarbij je eigenlijk gespecialiseerd in het maken van dit soort modellen. Er zijn een aantal van ze, ook een hele grote Nederlandse club, die eigenlijk niks anders doen dan voor de Zalando's van deze wereld dit soort dingen maken. Dus het is eigenlijk een beetje een keuze, wil je vanuit een tool gaan werken, waarbij je gewoon 100 JPG'tjes upload, of wil je vanuit een API, in de vorm van hoe Arne werkt, vanuit een YourSurprise, dan moet je wel met een API call gaan werken, omdat je anders niet op tijd klaar krijgt voor die klanten. Er is helemaal geen handmatig werk meer nodig. Wat je ziet is dat, twee maanden geleden was Veo 3 van Google aangekondigd. Veo 3 was toen baanbrekend. Waarom?
De fysiërs waren heel goed. Dus als je water zag, dat vloeide ook en dat druppelde ook exact. Als mensen gingen lopen, dan zag je ook een gelaat. Als ze hardlopen waren, zag je hun gelaat ook zo'n beetje meetrillen. Alles was er supergoed. En er zat geluid in. En geluid is dus ook een ander model wat je eigenlijk moet gebruiken om te genereren.
Maar het geluid moet exact overeen komen met de beweging in het beeld. Dus wat zie je nu? Er zijn ook nog geluidsmodellen waar je een video in stopt en waar het geluid bij je gemaakt wordt. Dus je ziet dat allemaal een beetje naar elkaar toegroeien. En wat je zag, en dat is wat ik bedoelde met wat je vandaag gebruikt, dus over drie weken weer anders. Veo 3 was een aantal dagen de nummer 1 video generator, volgens de Video Generation Leaderboard. In dit geval is dit volgens mij van Hugging Face.
Kijk je echter een dag later, en dat was letterlijk een dag later, kwam ByteDance, die jongens van TikTok kwamen uit met een nieuw model, genaamd Seedance. En die had de nummer 1 eigenlijk binnen een dag overgenomen. En het verschil is dus heel klein. Je ziet hier het aantal punten wat gegeven wordt en hoe dit gedaan wordt. Er worden gewoon video's gegenereerd. wordt een prompt laten zien van popcorn, popping in een microwave, en dan zie je links en rechts, en dan kunnen mensen voten of de linker of de rechter beter is, ze zien niet welk model het is, maar uiteindelijk kiezen ze voor de rechter, en dat was dan Seedance, en in één keer voor de linker, en uiteindelijk wie er wint, is degene die hierbovenaan staat. Wat ik wil zeggen, hou dit dus ook in de gaten, je ziet dus letterlijk in mei, en een dag later was dat in juni, dat dat ding van ByteDance dan op nummer 1 staat, hou deze leaderboards ook in de gaten, Het zijn gewoon openbare leaderboards, kijk er ook naar, en zodra er ook gewoon een beter model is, wellicht kan dat model dan wel exact wat jij wil.
En dat gaat echt, letterlijk, iedere week is het gewoon de moeite waard om even dit te refresh, om te kijken of daar iets in gebeurd is. Wat we nu ook zien, is dat die modellen ook steeds beter het product in een soort 3D context snappen, dus door het uploaden van één plaatje, en in dit geval zonder context, kan hij dit dus ook maken. hoe herken je dit plaatje dat het dus geen echte klok is die echt beweegt dat zie je aan de secondenwijzer of de secondenticker die dus niet naar boven gaat in dit geval het is gewoon een plaatje die in een soort 3D model gestopt is door dat videomodel hoe ik dit aangepakt heb is ik heb het originele plaatje gepakt ik heb daarvan tegen FLUX.1 Kontext gezegd maak van dat plaatje een scène waarbij een vader en dochter in een auto stopt die scène heb ik niet helemaal zelf gemaakt Ik heb de scène gecreëerd door de linkerfoto eerst naar Gemini te sturen. En gevraagd naar Gemini, Gemini. Kan je voor mij een scène creëren die voor een webshop de perfecte in-use-action fotografie toont van dit product? Die kwam dan met het beeld van vader uitgezoomd. Een beetje blurred, geblurred.
En dan, wat is er scherp gesteld, het kind? En zo zie je dat het foto van het kind wat dan gecreëerd is. kan je dan daarna in een videomodel stoppen. Dat je dus eigenlijk in een aantal fases naar jouw bewegende beeld gaat. En dat dat dus niet per se hoeft ook gelijk van dit, dat je dan gelijk naar dat beeld gaat. Dat je een aantal stappen ertussen hebt. En eigenlijk kan het in iedere stap weer misgaan.
Dus ook daarin weer, als je met dit soort modellen aan de slag gaat, zorg er ook voor dat er dus controles plaatsvinden, waarbij je dat human interface kan hebben, met iemand die controleert, er komen zes plaatjes uit. Je kiest deze twee om verder te gaan. Maar dat kan je ook weer door AI laten doen. Of door een ander model weer laten doen. Laten controleren. Waarbij je dat kan controleren. Is de input hetzelfde als de output?
Zijn er artifacts bijgekomen? Is het logo wat daar staat nog steeds correct? Of moet ik hem dan nog een keer aanbieden? Zodat de handen en de vingers zijn nog vaak een issue bij heel wat modellen. Het wordt steeds beter. Maar er zijn er vijf anatomische correcte vingers uitgekomen. Dat klinkt heel stom.
Maar dat zijn echt de dingen die ervoor zorgen dat het model dus beter wordt. Daardoor ook wel weer, of de modellen de output beter wordt. Maar ook wel weer kostbaarder. Want een FLUX.1 Kontext plaat je dus tussen 10 en 20 cent. En laat je hem nog een keer genereren. En dan wordt het weer 15 tot 40 cent. Dus dat loopt uiteraard wel op.
Tegelijkertijd, als je een echte foto laat schieten, is het misschien wel 2, 3 tientjes per foto. Dus hou dat ook gewoon in de gaten. AI betekent niet dat het goedkoop hoeft te zijn. Als het maar gewoon dezelfde kwaliteit is. En als het dan de helft van de prijs al is. Dan heb je eigenlijk al gewonnen. Zo moet je het eigenlijk ook zien.
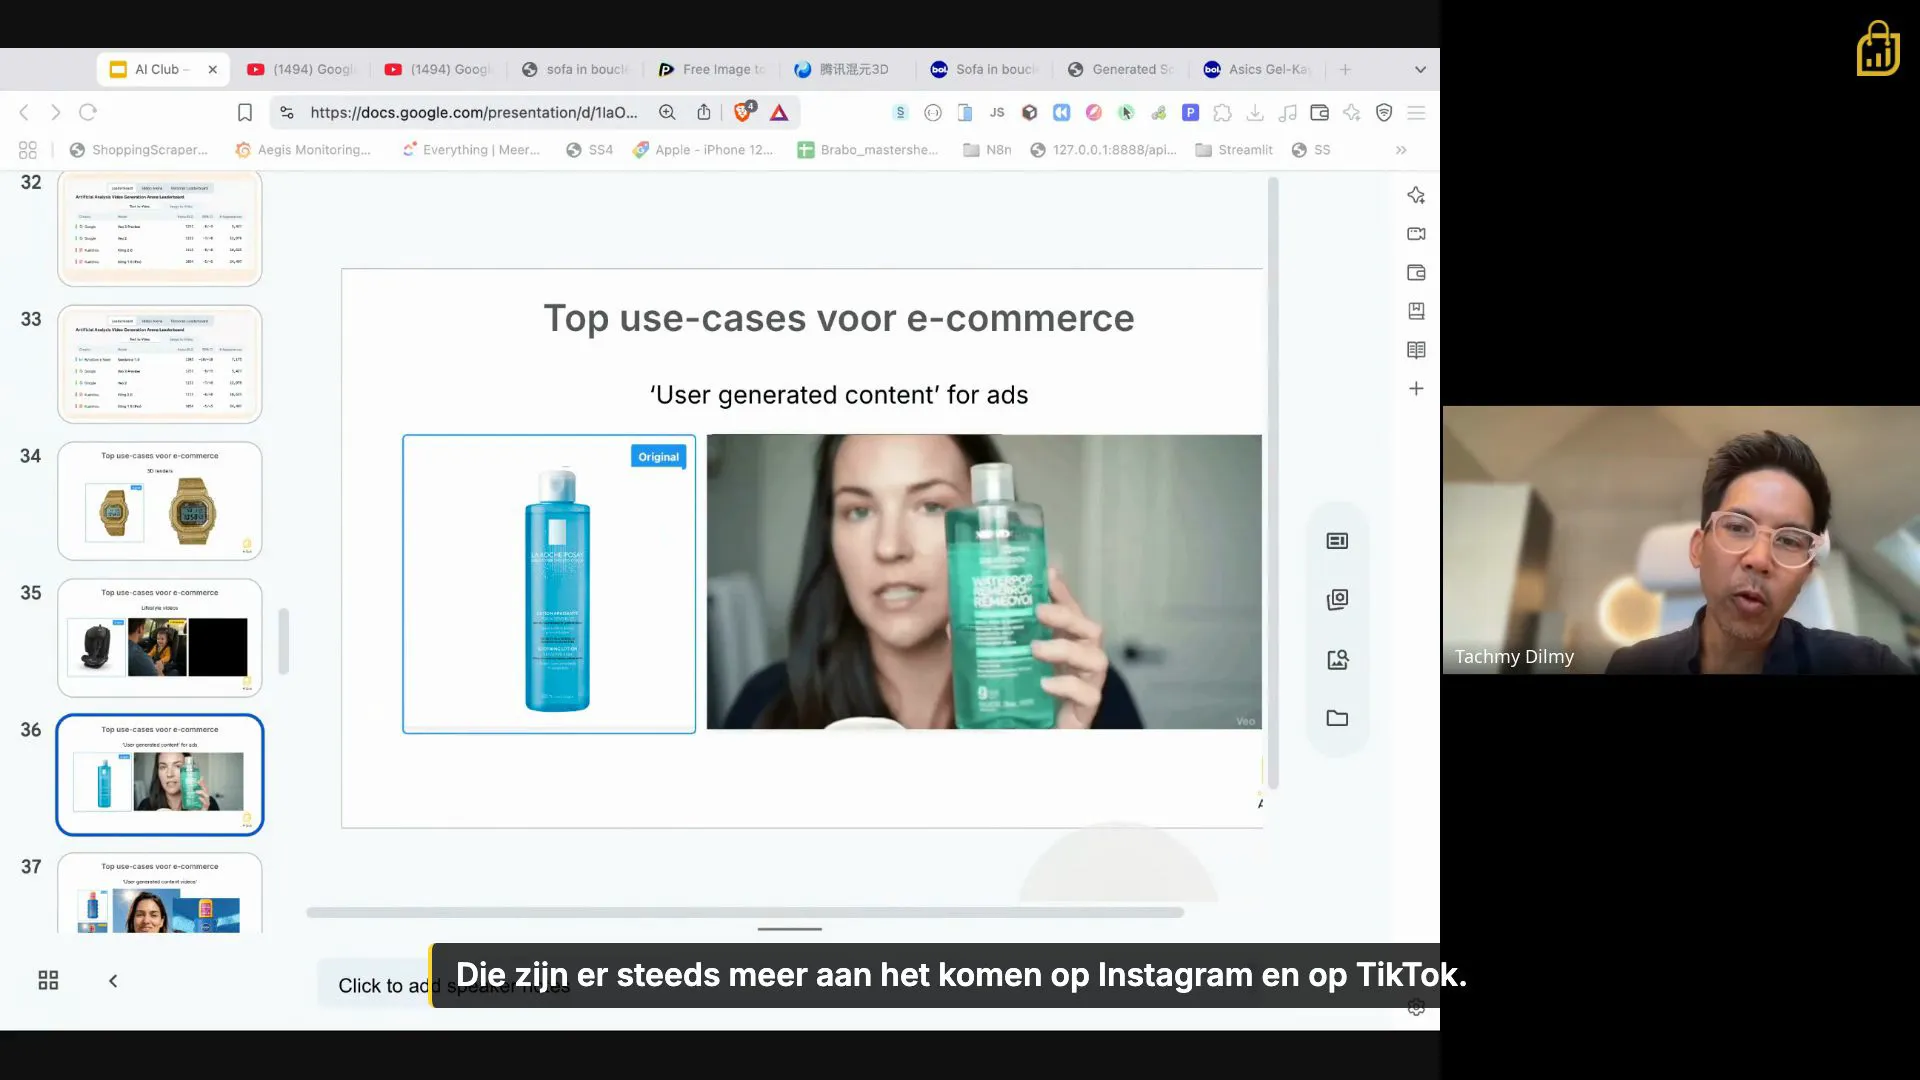
De andere stap is dat je dit soort beeld dan ook krijgt, waarbij je een soort van TikTok-achtige video kan maken, waarbij de mevrouw in kwestie A misschien niet eens zelf bestaat, en dat product nog nooit eens ontvangen heeft, maar dat je dus wel een heel verhaal ervan kan gaan maken, met de Veo 3's van deze wereld. Nivea, waarbij we dus een plaatje hebben geüpload, FLUX.1 Kontext in en aangegeven aan een makende vrouw die een verhaal vertelt over dit product met wat product in handen. Dus ook unboxing video's en hier zie je al wat artifacts alweer ontstaan. Misschien is de doos ook net niet zo plat en hij verschuist ook en hij zit dan net niet lekker hoe die, hoe dat doosje ook valt op de tafel. maar ook dit gaat echt wel snel beter worden. Wat we ook zagen is dat, dit is een Maxima product, vorige keer had ik volgens mij dit voorbeeld ook al laten zien, waarbij we de prompt die je gebruikt om een foto te genereren, en hier links zie je dan een foto met wat bloem ernaast, als je diezelfde prompt gebruikt, en dan twee keer laten runnen voor een video, dan krijg je eigenlijk een heel ander beeld, dan wat je eigenlijk zou willen hebben, In dit geval wordt het gewoon een soort van ontploffing. En strooit iemand gewoon een lekkere bloem over dat hele apparaat heen.
Dus ook hier weer is het, wat voed je dat model? De kwaliteit van de output is obviously afhankelijk van de input. Drie dingen. De context, het model zelf. LLM is dan misschien niet het juiste woord voor die fotomodellen. Maar het model wat je kiest en de prompt die je meegeeft. En ook die fotomodellen zijn dus slimmer aan het worden.
dat ze, een aantal daarvan, dat die dus ook gewoon multi-model zijn, waardoor het wel helpt om meer context mee te geven. Dat je dus ook de afmetingen van het product bijvoorbeeld meegeeft. Heb ik gezien dat dat al veel beter helpt om dat je dus realistischere foto's krijgt. Ik heb echt talloze tokens verbrand aan Apple Watches die even groot waren als de mevrouw zelf, zeg maar. En niet zo groot zijn als haar pols een horloge om haar pols heen. Ik heb zo wat voorbeelden ervan ook. Wat we nu ook zien is dat die model consistency steeds meer vooruit gaat.
FLUX.1 Kontext hadden we al gezien. Dit is een model van Tencent. Hunyuan heet het. En daar zie je dus ook dat je input op model en ook in bewegend beeld komt dat gewoon exact hetzelfde overheen. En wat we nu zien in een trend is dat je dus meerdere dingen kan injecteren. Dus je kan niet alleen de persoon, maar je kan ook dus de kleding erbij doen, waardoor je dus eigenlijk meerdere objecten in een scène kan stoppen en dat bewegend kan gaan maken. Wat je verder niet is, is dat er specifieke modellen ontstaan voor eigenlijk iedere situatie die je maar kan bedenken.
In dit geval is het een try-on, waarbij je een bestaande video die er al is van van iemand die dus al een bepaalde movement heeft, die tegen een bepaalde achtergrond staat, die kan je dus laten swappen qua kleding. Dus je zou dus wel een bestaand model, wat al wel bestaat, kunnen gaan gebruiken, waar je dus wel een keer een shoot voor gemaakt hebt, dat alle varianten die ze aan heeft, of alle andere kledingsticker die ze dan draagt, of die hij draagt, dat je dat met zo'n model oplost. Dus dan is je input gewoon altijd een plaatje geweest van iemand die wel bestaat. Nou, dan moet je dan iets mijl spreken, wat je daarmee doet qua beeldrecht en dat soort grappen, maar je kan dan zo'n specifiek model gebruiken om alleen maar de clothing te swappen en hier zijn er dus echt tallozen van en er komen echt om de haverklap dit soort vaak open source modellen uit en het was voordeel dat je die ook zelf kan gaan draaien als je dan op een gegeven moment je eigen Nvidia GPU inkoopt, dat je dat ook op je eigen lokale server zelfs kan gaan draaien of ergens gehost, dat maakt er niet uit maar dat hele model krijg je gewoon tot je beschikking dan met die open source modellen Laatste is dat er vanuit ByteDance, en dit is echt een paar weken geleden aangekondigd, ik heb het zelf nog niet goed kunnen testen, je kan meerdere subjects toevoegen. Ik heb een vraag gekregen vanuit de partij van, zou je dus in zo'n badkamer meerdere meubels kunnen plaatsen uit dezelfde lijn, uit dezelfde serie, of zou je... Het voordeel is dat je dan eigenlijk een scène kan creëren met exact dezelfde situatie met de product uit een lijn. Want een foto maken van een tas, dat snapt iedereen nu wel dat dit kan.
En ook hier heb je nog steeds last van artifacts. Dit is dat X-First product. Je ziet hier dat die twee flappen hier in de flap mist. Dus dat blijft gewoon opletten. En ook zelfs met de beste modellen gaat dit nog steeds gebeuren. maar het gave is dat je hier model, de pose de muts en een spaceship mocht je zo gek zijn dat je deze situatie wil dan kan je dit creëren en dat is dus wat gave dat je veel meer invloed hebt op alle objecten binnen een scène ik heb zelf even wat gespeeld met een dat is letterlijk niet heel veel werk geweest in de zin van, er zit geen antwerp tussen het is niet gemonteerd of geëdit dus ik heb gevraagd naar Gemini wat vind je van dit plaatje niet zozeer wat vind je van dit plaatje maar wat kan je voor scène creëren die past bij dit product maak daar een scène van die geschikt is voor een webshop en daar heeft hij dan een scène bij gecreëerd en ik heb ook de afmetingen mee gestuurd en de producttekst let daarmee op het is dus heel belangrijk dat je dus ook wat ik geleerd heb hieruit is dat het heel lastig is om met één prompt, of door AI zelf de prompt te laten maken, dat je nog steeds heel veel kwaliteitsverschil eruit haalt. Dit zijn de voorbeelden die nog wel best oké eruit zien.
Ik laat je zo even in onze tool zien wat voor dingen er ook uitkomen. Het is ook wel leuk om te zien wat voor fouten je kan maken. Nou, de Leatherman gevraagd van, maak een situatie voor een webshop waar het product gewoon stoer gefotografeerd is. Kreeg je dit soort foto's uit. Hier zou je je afvragen waarom zou je het in een maatsnaam zo willen vasthouden. Dat zijn dus van die zaken die je dus in die prompting zelf moet gaan aanpassen, zodat je dus wel de situatie krijgt die je wil. Ik zag ook een foto, laat ik ook zo zien.
We zijn dus met een applicatie bezig waarbij je dus een EAN kan uploaden en dan komt er eigenlijk gewoon dit uit zonder dat je ook maar iets eraan hoeft te doen. Deze foto hierboven bijvoorbeeld, het is de vraag waarom zou je hem zo dichtbij een persoon willen vasthouden? Bij mij komt dat al een beetje vreemd over. Dus ook dat soort dingen moet je gaan opletten wat de perfecte prompt is hoe je hem zou willen gebruiken. Kijken wat we nog meer hadden. We hadden wat zwembad, zwembad, product van Intex. Opblaasbare bedden zijn het geloof ik.
Nou, er kwamen best wat oké dingen uit. Ik zie proportioneel wellicht dat die dan niet helemaal dat die misschien hier iets breder is dan hier. Dat soort zaken moet je dus ook gaan opletten. Dit was dan hele gaaf. Lijkt echt op een niet zozeer AI-gegenereerde foto. Dit soort scènes. Als je het leuk vindt om dit uit te proberen, laat het weten.
Ik zal aan het einde van de sessie een linkje doorsturen. Waarbij je die kan registreren. En dan kan je wat EAN-codes. Als jouw producten EAN-codes hebben. Kan je wat EAN-codes uploaden. En dan krijg je vanzelf een gegenereerd plaatje eruit. Ik zal hier nog wat voorbeelden van XXL Nutrition laten zien.
Hier zie je dus dat het plaatje nog niet goed opgehaald wordt. En er zitten nog wat bukjes in onze tooling. Waarbij de plaatjes niet helemaal goed zijn. Ik zal nog even een leuke laten zien van wat knuffels. Waarbij het grappige is, is dat deze was 50 centimeter. Dus misschien net iets te groot in deze situatie. Deze was 60 centimeter.
Nou, wat al enigszins in de buurt komt. Anatomisch incorrecte foto's krijg je ook eruit. Dus dit is een op zich overeenkomend product. Kindje ook leuk. Alleen, hij ligt hier in een te 90 graden hoek. Wat niet mogelijk is. En een boek leest in een of andere encrypted language.
Dus er zitten gewoon nog wel wat dingen in die niet helemaal lekker zijn. Maar je ziet dus dat die modellen wel echt in staat zijn om best wel wat te maken wat iets kan. Dus dit soort dingen zijn natuurlijk wel heel overeenkomend. En soms nog een beetje vreemd dat er een volwassen kerel met zo'n groen Angry Birds plusje knuffel zit.
Spreker: Tachmy Dilmy, eCommerce AI Club
Bronnen
- bfl.ai/announcements/flux-1-kontext
- bfl.ai/pricing
- bfl.ai/announcements/flux-1-kontext-dev
- gigazine.net/gsc_news/en/20250521-google-veo-3
- arxiv.org/html/2506.09113v2
- the-decoder.com/bytedances-seedance-1-0-is-trading-blows-with-googles-veo-3/
- artificialanalysis.ai/text-to-video/arena
- huggingface.co/spaces/ArtificialAnalysis/Video-Generation-Arena-Leaderboard
- huggingface.co/tencent/HunyuanCustom
- bytedance.github.io/XVerse
Meer over AI & Marketing
 Duur 0:41
UGC van de toekomst is nep, en dat is oké
Tachmy Dilmy, eCommerce AI Club
Die user generated video op TikTok? Volledig door AI gemaakt
 Duur 0:52
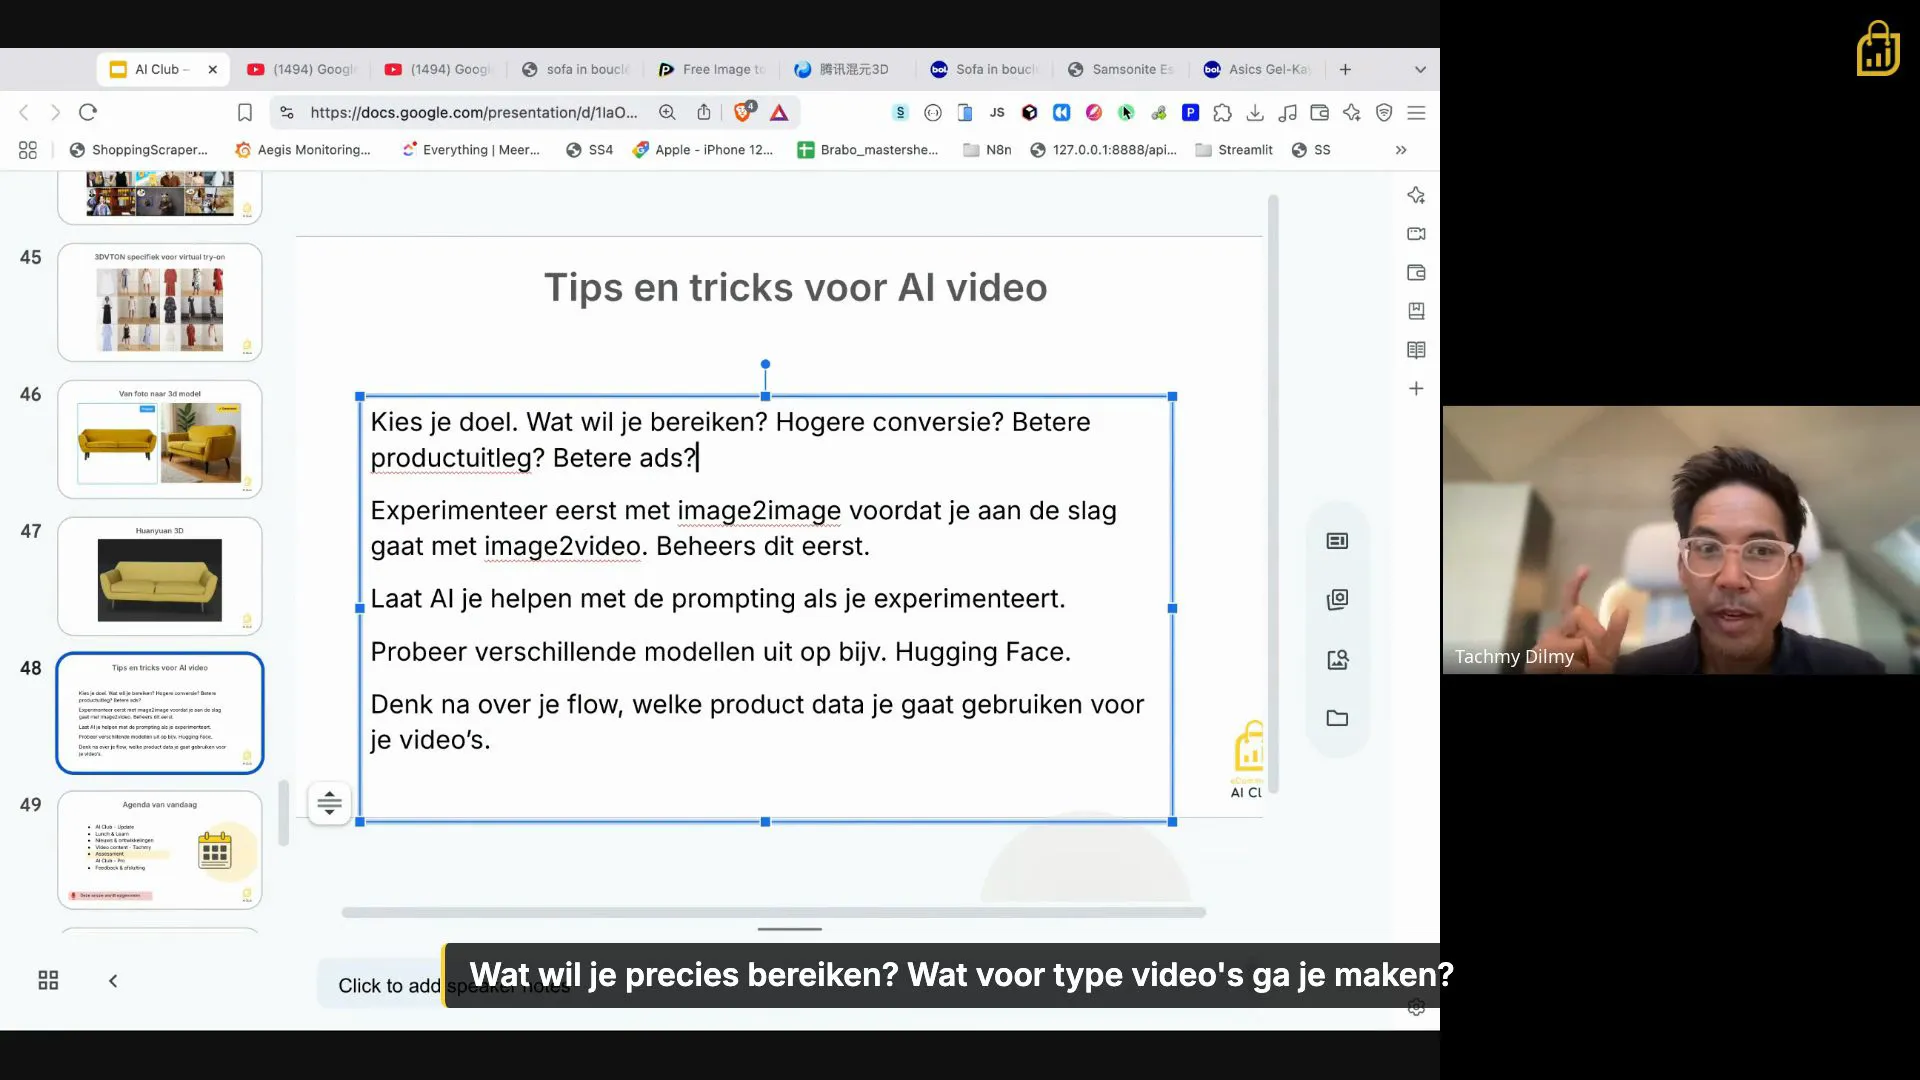
5 tips om te starten met AI video
Tachmy Dilmy, eCommerce AI Club
Begin klein met AI video, deze 5 tips helpen je op weg
 Duur 0:43
Van productfoto naar sfeerbeeld met AI
Jan Karel Ekkel, Kees Smit Tuinmeubelen
Van kale productfoto naar sfeerbeeld met AI, live demo bij Kees Smit